Python使用xml.etree将XML文件批量转换为TXT文件的方法
本文介绍如何利用Python内置的xml.etree模块,将XML格式数据高效转换为TXT文件。重点解析批量处理包含多个XML文件的文件夹场景,通过遍历目录、解析树结构并提取指定标签文本,实现自动化数据提取与格式转换,适用于数据分析前的预处理环节。
2026-10-14
23

本文介绍如何利用Python内置的xml.etree模块,将XML格式数据高效转换为TXT文件。重点解析批量处理包含多个XML文件的文件夹场景,通过遍历目录、解析树结构并提取指定标签文本,实现自动化数据提取与格式转换,适用于数据分析前的预处理环节。
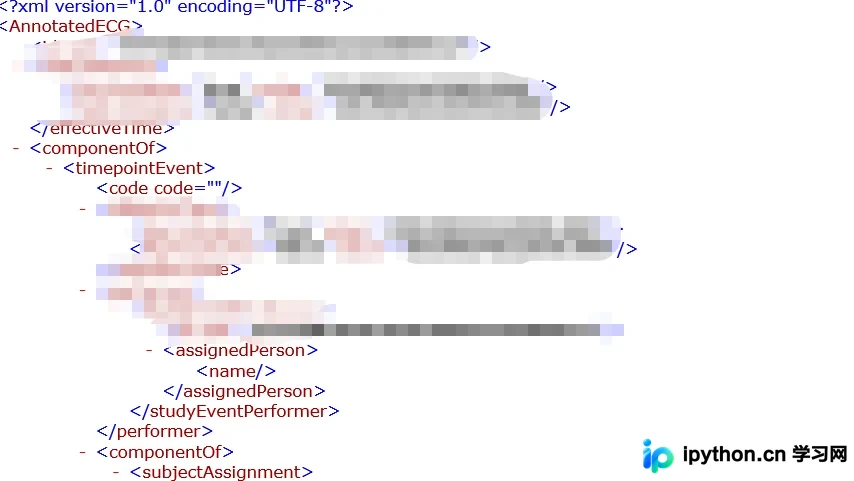
本文详解Python中is与==的区别。==比较值是否相等,is比较内存地址是否相同。重点解析小整数[-5,256]对象池及字符串Intern机制对is比较结果的影响,并说明命令行与脚本执行环境的差异。
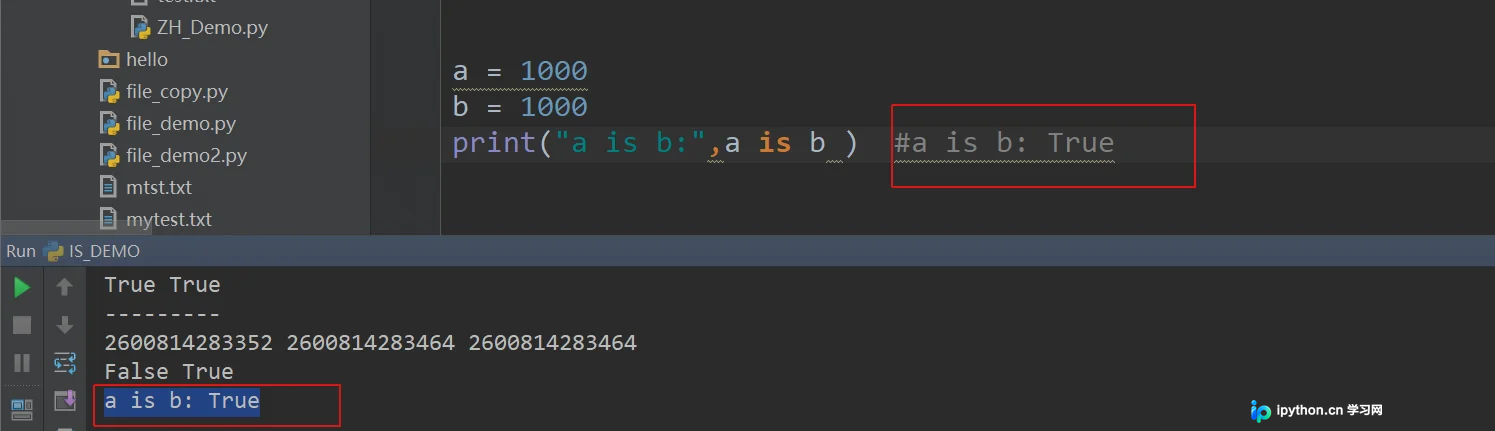
本文深入解析Python多继承中子类访问父类属性的现象。通过代码示例揭示,看似子类调用父类方法访问父类属性,实则是子类实例在操作。核心在于self始终指向子类实例,父类属性和方法被“转移”至子类实例中,并非存在隐藏的继承关系。
本文详细解析Python字符串驻留机制的适用范围,包括长度为0和1的字符串、符合标识符规范的字符串以及[-5, 256]范围内的整数。重点说明驻留仅在编译时生效,并深入剖析interned字典的工作原理及引用计数变化,帮助开发者理解Python内存优化策略。
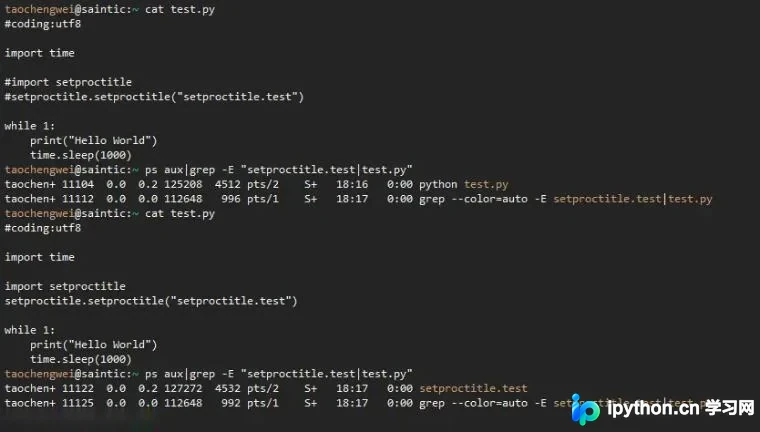
本文介绍在Python中获取进程PID和名称的两种主要方式。首先通过安装psutil库遍历进程获取信息;其次,针对Web应用默认名称不直观的问题,推荐使用setproctitle库自定义进程显示名称,提供源码编译与pip安装两种方法及代码示例。
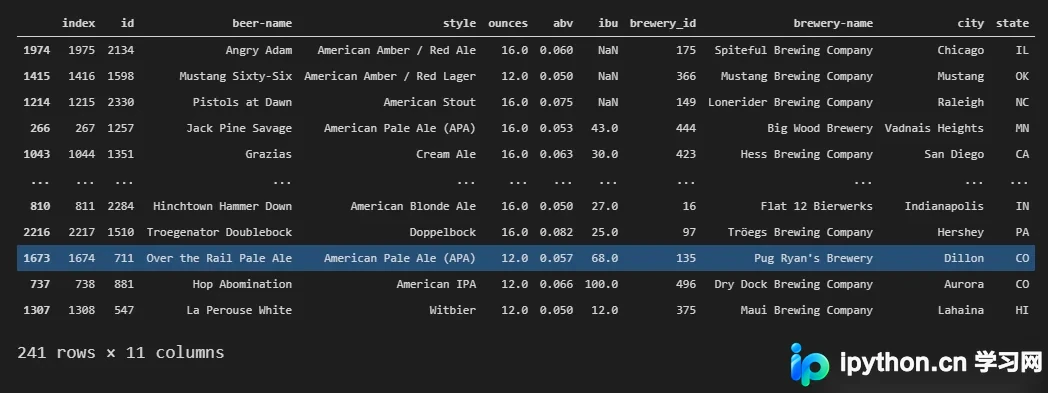
本文详细介绍在Python pandas中如何处理数据重复问题。通过sample函数进行加权采样,使用append方法合并数据集,最后利用drop_duplicates根据特定列(如id)去除重复项,实现数据的清洗与更新。
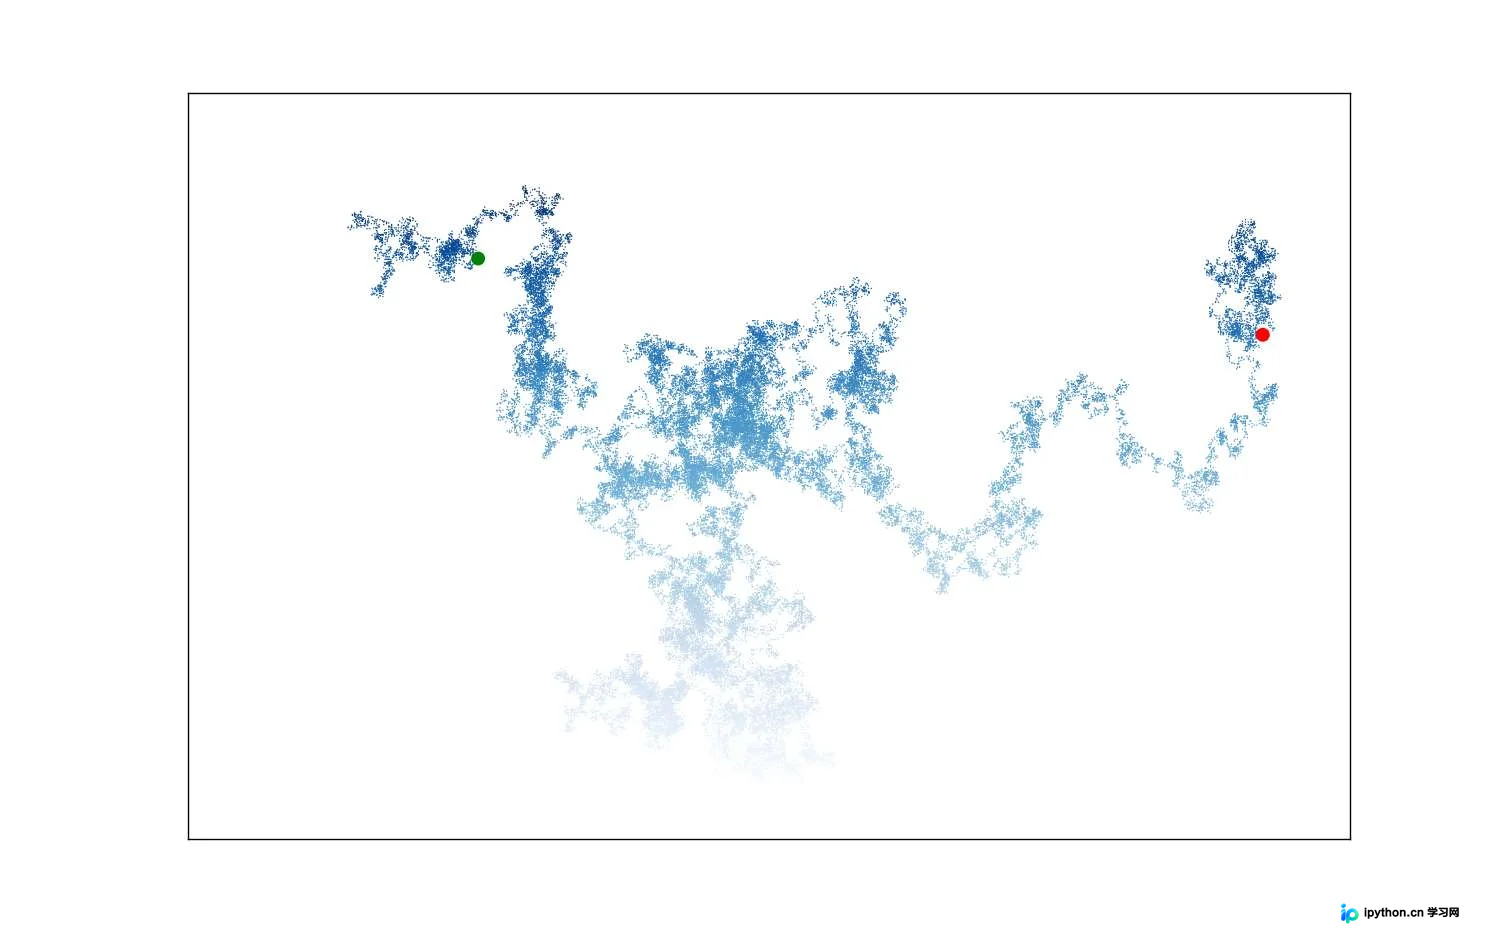
本文详解Python Matplotlib中颜色映射(cmap)与数据映射(c)的配合使用。c参数指定数值列表,其位置对应点的绘制顺序,数值大小决定颜色深浅。通过随机漫步示例,分析y_values与range(50000)两种情况下颜色随位置变化的规律,揭示数据趋势与视觉颜色的对应关系。
本文详细解析Python中sorted()函数对字典进行排序的方法。通过key参数指定排序依据,可实现按字典的键(key)或值(value)进行升序或降序排列。文章包含具体代码示例,演示如何对简单字典、嵌套元组列表及字符串列表进行自定义排序,帮助开发者掌握灵活的数据排序技巧。
本文详细介绍 Python 中 rindex() 方法的用法,该方法用于返回子字符串最后一次出现的索引位置。与 rfind() 不同,当未找到匹配项时 rindex() 会抛出 ValueError 异常。文章涵盖语法结构、start/end 可选参数及具体代码示例,帮助开发者正确处理字符串搜索场景。
本文详细介绍Python中利用lxml库和XPath技术提取网页数据的方法。内容涵盖XPath基础路径表达式、常用功能函数如contains和text的使用,以及通过requests获取HTML后解析的具体代码示例,帮助开发者高效处理网页元素。
本文介绍TensorFlow2中全连接层的实现方法。详细解析keras.layers.Dense的参数配置与权重形状,以及使用Sequential构建多层线性网络模型。通过代码示例展示如何定义层、设置激活函数并查看内部参数,帮助开发者快速掌握基础网络构建。
本文详细讲解如何在PyCharm中配置Robot Framework开发环境。重点解决ExcelLibrary库因版本兼容性问题导致的安装报错,提供通过修改源码解决依赖冲突的具体步骤,并推荐替代库Seliky以优化开发体验,帮助开发者快速搭建自动化测试平台。