

Python数据处理:Shape属性、维度扩展与数组操作详解
本文详解Python中数据shape的常见操作。针对list无shape属性,介绍转换为np数组的方法。深入解析append与extend的区别、np.concatenate与np.append的拼接逻辑,以及transpose、.T和reshape的转置技巧。重点讲解newaxis增加维度、ravel与flatten的区别,以及-1在reshape中的模糊控制用法。
2026-10-11
24

本文详解Python中数据shape的常见操作。针对list无shape属性,介绍转换为np数组的方法。深入解析append与extend的区别、np.concatenate与np.append的拼接逻辑,以及transpose、.T和reshape的转置技巧。重点讲解newaxis增加维度、ravel与flatten的区别,以及-1在reshape中的模糊控制用法。
本文深入解析Python中关闭Socket的正确方式。重点区分close()与shutdown()方法的差异,说明为何仅调用close()无法立即释放资源。通过介绍shutdown()的三种模式(SHUT_RD、SHUT_WR、SHUT_RDWR)及其参数,指导开发者在需要立即切断连接或半关闭通信时使用shutdown(),并强调其必须在close()之前调用的操作顺序,以确保网络资源的有效释放。
本文介绍在 Linux 环境下使用 Python 获取主机名和 IP 地址的方法。通过 socket 模块的 gethostname() 和 gethostbyname() 函数,可以获取当前主机名及其对应的 IP 地址。同时,使用 gethostbyname_ex() 可以获取更详细的网络信息,包括别名和所有关联的 IP 地址列表。
在Python中,print语句前加u表示定义Unicode字符串。该前缀不仅适用于中文,也适用于任何字符串,用于指定Unicode编码。英文字符通常无需此标识,而中文字符若未明确编码易出现乱码。建议统一采用UTF-8编码以确保兼容性。
本文介绍如何使用Python将Excel文件中所有已存在的Sheet数据横向合并到一个新的Sheet中。通过xlrd读取源数据,利用xlwt和xlutils.copy创建并写入新Sheet,最后保存为新的Excel文件。
本文详细介绍如何在 Selenium Python 中配置爬虫代理 IP。通过 ChromeOptions 添加 --proxy-server 参数,可解决反爬限制并提升抓取效率。文章涵盖代理类型选择、多线程注意事项及代码实现,帮助开发者高效部署爬虫。
本文深入解析Python中字符串的常见操作方法,包括去除空格、大小写转换、位置查找及分割连接等。同时详细讲解函数定义的多种参数形式,涵盖默认参数、可变位置参数、关键字参数及命名关键字参数。通过代码示例展示函数作为参数的应用及递归逻辑,帮助开发者掌握Python编程核心技巧。
在Python开发中,字典默认一个键仅对应一个值。当需要将多个值映射到同一个键时,通常将值放入列表或集合中。本文详细对比了手动实现、使用setdefault()以及利用collections.defaultdict三种方法的优劣,重点解析defaultdict如何简化代码并自动处理键初始化,帮助开发者选择最适合场景的数据结构。
在Python开发中,确认第三方库或内置模块的版本号对于排查兼容性问题至关重要。本文介绍了两种最常用的查看方法:通过导入模块后访问__version__属性,以及使用pkg_resources库获取版本信息。以networkx为例演示具体操作,帮助开发者快速定位环境依赖状态。
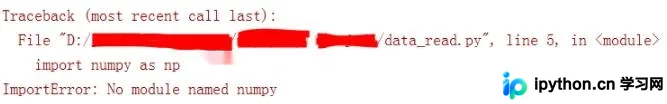
在PyCharm中运行Python代码时,即使模块在Jupyter Notebook中可用,仍可能遇到“ImportError: No module named”错误。这通常是因为PyCharm当前使用的Python解释器未安装该模块,或者电脑中存在多个Python版本导致环境不一致。本文详细介绍如何通过修改PyCharm的项目解释器来解决此问题,确保代码顺利运行。
本文深入解析 Python 中 join() 方法的核心机制,涵盖字符串、列表及字典的拼接规则,并重点演示如何利用 os.path.join 安全构建文件绝对路径。通过具体代码示例,展示如何获取目录下最新文件的完整路径,帮助开发者掌握高效的字符串与路径处理技巧。
本文详细解析了利用Python Selenium WebDriver自动化操作浏览器登录微信公众号后台,并抓取文章内容的完整流程。通过模拟输入账号密码、获取Cookie并持久化存储,结合Requests库调用后台接口实现文章数据的批量下载与本地保存,为公众号数据抓取提供了可参考的代码实现。