

Python程序性能优化实战:从基础技巧到高级工具
本文深入解析Python程序加速运行的核心方法。从基础层面探讨将代码封装为函数、利用局部变量优势、预绑定方法以及使用内置容器等技巧,有效减少属性查找开销。进阶部分介绍PyPy的JIT编译与Numba的LLVM加速技术,并强调在追求性能前确保逻辑正确性的重要性。
2026-10-12
24

本文深入解析Python程序加速运行的核心方法。从基础层面探讨将代码封装为函数、利用局部变量优势、预绑定方法以及使用内置容器等技巧,有效减少属性查找开销。进阶部分介绍PyPy的JIT编译与Numba的LLVM加速技术,并强调在追求性能前确保逻辑正确性的重要性。
本文探讨学习Python爬虫的实际应用价值,涵盖大数据分析与机器学习的数据源获取。解析网络爬虫工作原理,对比浏览器与爬虫的数据交互差异,并深入分析Python作为爬虫首选语言的技术优势,包括其丰富的标准库、胶水语言特性及高效的执行机制。
本文解析了Python中return不返回值的问题。主要原因为未将返回的值取出来。解决方法是调用函数并将返回值赋给变量,然后输出该变量即可查看函数的返回值。
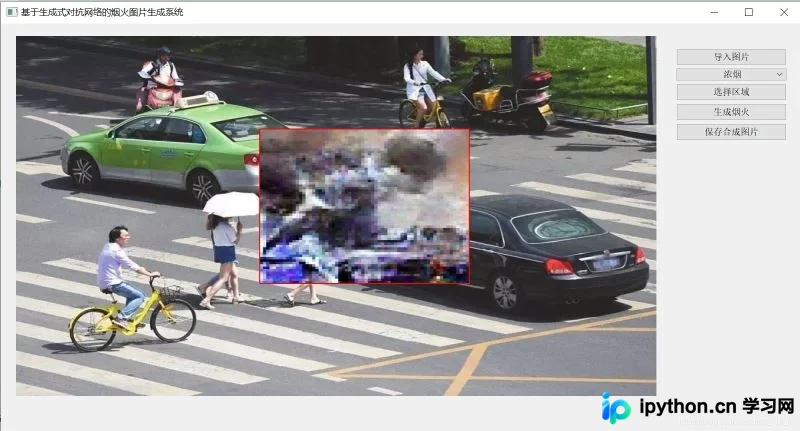
本文介绍如何使用Python OpenCV将一张图片嵌入并叠加到另一张图片上。通过调整图像尺寸并利用切片赋值操作,实现指定坐标区域的图像覆盖。文章包含核心代码片段及PyQt5界面集成示例,适用于烟火生成等需要图像合成的场景。
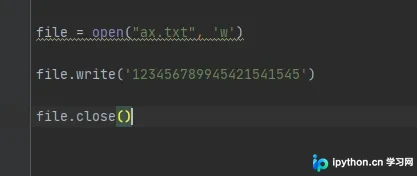
本文详细介绍Python中保存文本文件的标准流程,重点讲解内置open()类、write()函数及close()函数的配合使用。通过具体代码示例,演示如何创建文件、写入字符串数据并正确关闭文件以保存内容,同时涵盖追加模式'a'与普通写入模式'w'的区别及应用场景。
本文深入解析Python的核心应用场景。从Web后端开发(Django/Twisted)到系统运维自动化,从科学计算(NumPy)到网络爬虫,详细阐述Python在各类技术栈中的具体作用与优势,帮助开发者理解其广泛适用性。
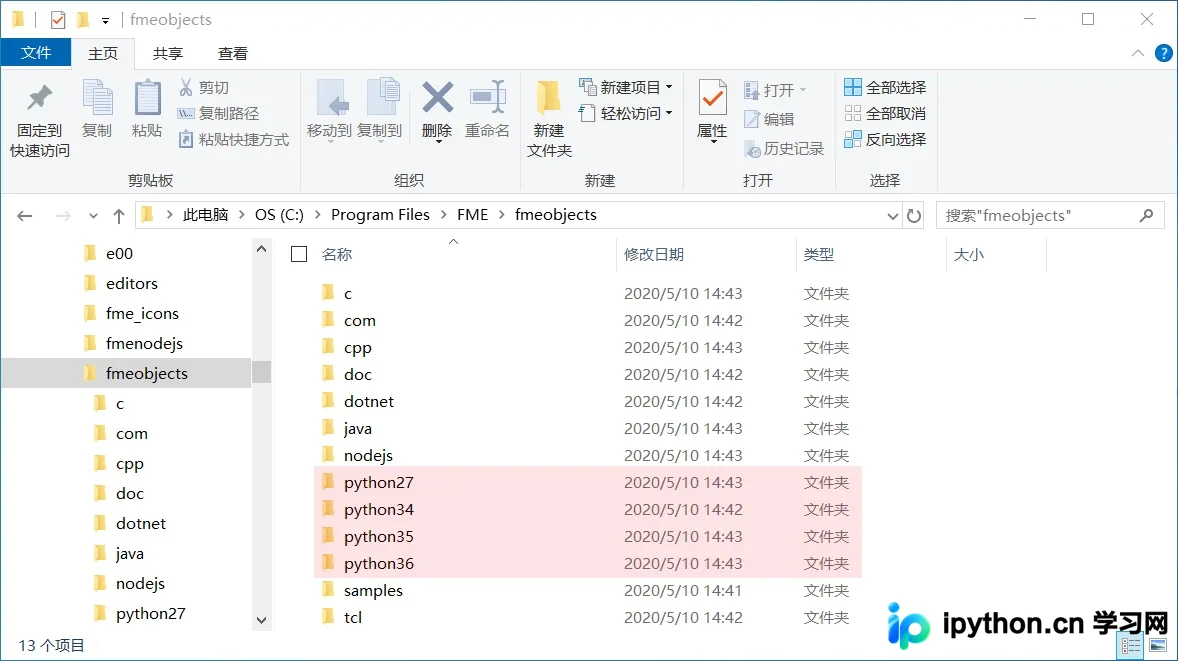
本文详细讲解如何在Python环境中配置FME对象库(fmeobjects),实现Python与FME的无缝集成。通过复制FME安装目录下的fmeobjects文件夹至Python的site-packages路径,开发者可以在Python脚本或Jupyter Notebook中直接调用pyfme模块,进行空间数据处理与自动化工作流开发。
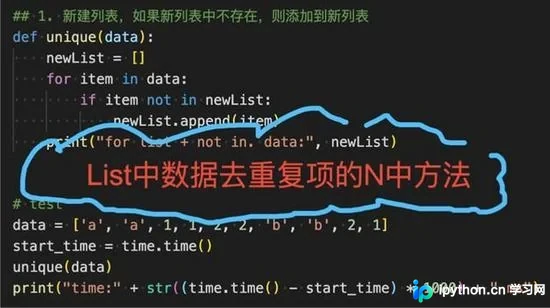
本文深入探讨Python中列表去重的多种实现方式,涵盖新建列表、原地删除、利用Set和Dict结构以及NumPy库等近20种方法。通过具体代码示例与时间复杂度分析,对比各方案在Python 2.7及更高版本中的执行效率与适用场景,帮助开发者根据实际需求选择最优的去重策略。
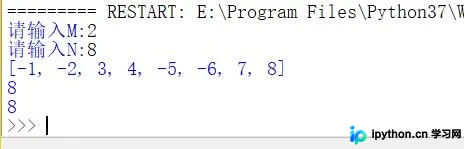
本文介绍了一种名为翻转数列的Python实现方法,针对给定整数n和m,生成每隔m个符号翻转的数列并计算前n项和。通过两种思路解析规律,提供完整代码示例,帮助读者理解数列生成与求和逻辑,适用于算法练习与编程学习。
本文介绍在 Python 中实现函数定时轮询执行的两种常见方式:利用 threading.Timer 创建子线程循环,以及使用 time.sleep 阻塞主线程。通过代码示例对比两者的资源消耗与实现逻辑,帮助开发者根据场景选择合适的方案。
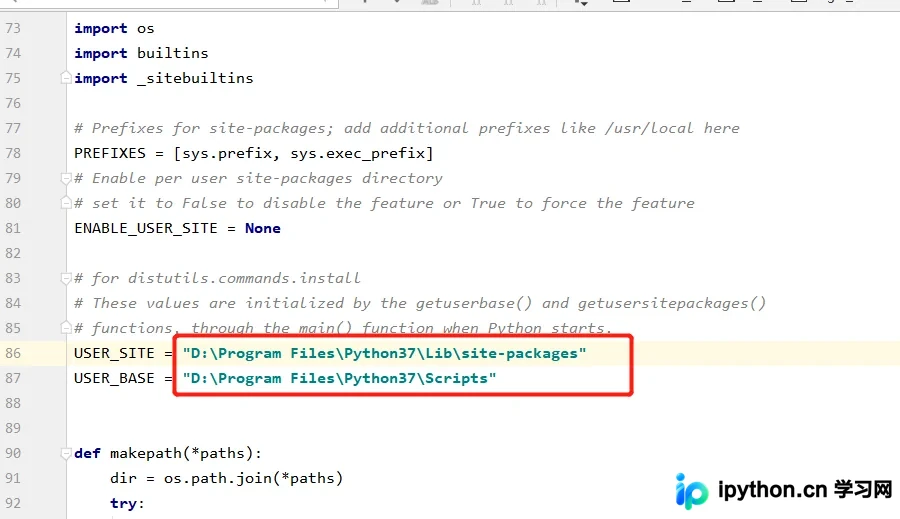
本文介绍如何通过修改Python的site.py文件来更改pip install的默认下载路径。通过查看USER_SITE和USER_BASE,可以了解当前依赖包和脚本的安装位置,进而修改site.py文件中的路径设置,实现自定义安装目录。
本文深入解析Python中startswith()和endswith()方法的底层逻辑与参数应用。通过具体代码示例,展示如何利用这两个方法高效判断字符串前缀与后缀,并探讨在SQL语句校验及文件类型识别等实际开发场景中的最佳实践。