

Python验证码识别实战:从灰度处理到TesserOCR识别全流程
本文详细讲解利用Python进行图像类验证码识别的完整流程。从生成测试验证码入手,依次演示灰度处理、二值化及基于邻域算法的降噪技术,并结合TesserOCR库实现自动识别。文章通过对比不同干扰程度下的识别效果,提供了处理简单至中等复杂度验证码的实用代码与策略。
2026-10-13
24

本文详细讲解利用Python进行图像类验证码识别的完整流程。从生成测试验证码入手,依次演示灰度处理、二值化及基于邻域算法的降噪技术,并结合TesserOCR库实现自动识别。文章通过对比不同干扰程度下的识别效果,提供了处理简单至中等复杂度验证码的实用代码与策略。
本文介绍如何利用Python内置的SimpleHTTPServer(Python2)或http.server(Python3)模块,在局域网内快速搭建临时文件服务器。通过指定端口启动服务,局域网内其他设备可通过浏览器访问主机IP及端口,直接浏览并下载指定目录下的文件,无需安装额外第三方库。
本文介绍使用Python编写爬虫程序,自动抓取煎蛋网(jandan.net)上的图片并保存至本地文件夹。通过解析网页HTML获取图片链接,利用urllib库发起请求并下载图片文件,支持指定页数批量处理。代码包含页面解析、图片地址提取及文件保存逻辑,适合Python初学者学习网络爬虫基础操作。
本文介绍利用Python标准库datetime和time模块,通过日期加减运算获取昨天、今天和明天的起止时间戳。代码演示了如何计算具体日期的起始与结束毫秒级时间戳,并输出对应数值结果,适用于需要精确时间范围处理的场景。
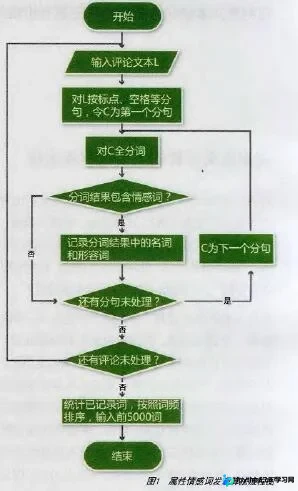
本文介绍一种基于Python的中文用户评论处理方法,旨在从评论文本中自动提取评价对象(属性词)及对应的情感表达。通过观察发现属性词常与情感词伴随出现,且多为名词或形容词。文章提供了详细的算法流程图、示例数据及完整代码实现,展示如何遍历分词结果,识别名词后的情感描述,并处理否定词等特殊情况,最终输出结构化的匹配结果。
本文详细介绍Python中optparse模块的使用方法。该模块能自动生成符合Unix/Posix规范的帮助文档,通过add_option()定义选项,利用parse_args()解析参数。文章涵盖选项缩写、全拼及type、default等命名参数的配置,并提供完整代码示例展示如何获取options对象和positional arguments,适用于需要标准命令行交互的Python程序开发。
本文介绍如何在Django中间件中直接返回HTTP响应。通过导入HttpResponse类,利用json.dumps将字典内容序列化为JSON格式字符串,并设置content_type为application/json。该方法可有效避免上层处理报错,适用于在中间件阶段拦截请求并返回特定状态或错误信息。
本文介绍一种使用Python将MySQL数据同步至Elasticsearch的轻量级方案。针对Logstash-input-jdbc同步频率低的问题,该方案通过读取MySQL更新字段的时间戳进行增量查询,并设定10秒同步间隔。通过对比上次同步时间与当前时间解决服务器时间差,利用MySQL ID作为ES ID避免重复,确保数据同步的实时性与完整性。
Python 原生 UUID 为 32 位十六进制字符串,长度较长且处理效率受限。本文介绍一种利用 62 个可打印字符(大小写字母加数字)将 32 位 UUID 压缩为 8 位的算法。通过将 UUID 分为 8 组,每组 4 个十六进制字符转换为整数后对 62 取模,以结果作为索引从字符集中提取字符,最终生成仅含 8 个字符的短 UUID。
本文介绍Python中判断用户输入是否为数字的三种常用方法。首先讲解整型判断使用的isdigit()方法及其局限性;其次通过try-except异常处理机制实现浮点数验证;最后利用正则表达式精确匹配浮点数格式。文章提供完整代码示例,帮助开发者根据需求选择合适方案。
本文详细介绍如何使用PyInstaller将Python代码打包为Windows或Linux下的EXE可执行文件。内容涵盖PyInstaller与UPX的安装配置、环境检测、Spec文件生成及最终打包步骤,帮助开发者快速生成独立运行的程序。
本文通过两个Python多继承示例,深入解析类方法解析顺序(MRO)。结合C3线性化算法,阐明Python 3中多继承的查找规则,对比不同父类排列对方法调用的影响,帮助开发者掌握复杂继承结构下的行为预测。