在Anaconda3中创建独立Python 2.7虚拟环境指南
本文介绍如何在Anaconda3环境下快速创建并激活独立的Python 2.7虚拟开发环境。通过conda create命令指定版本,结合Linux/Mac的source activate或Windows的activate命令,实现环境隔离,确保库安装不影响主版本,适用于需要兼容旧版Python的项目开发。
2026-10-13
24

本文介绍如何在Anaconda3环境下快速创建并激活独立的Python 2.7虚拟开发环境。通过conda create命令指定版本,结合Linux/Mac的source activate或Windows的activate命令,实现环境隔离,确保库安装不影响主版本,适用于需要兼容旧版Python的项目开发。
本文详细介绍在Python pandas中替换某一列特定值的方法。通过示例数据集,演示如何将非指定字符串统一替换为默认值,提供简洁的代码实现步骤,帮助开发者快速掌握数据清洗中的关键技巧,适用于各类表格数据处理场景。
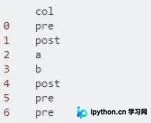
本文介绍如何在Python的DataFrame对象中为行和列添加名称。通过设置index.name和columns.name属性,可以解决因缺少行列名导致的报错问题,并优化数据展示格式。
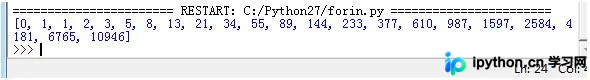
本文介绍Python 2.7中如何使用for循环遍历range函数来计算斐波那契数列。通过初始化列表并循环20次,利用append方法在列表末尾添加前两项之和,最终输出包含22个元素的数列。文章还解析了变量i的作用及列表逆向索引技巧,适合Python初学者参考。
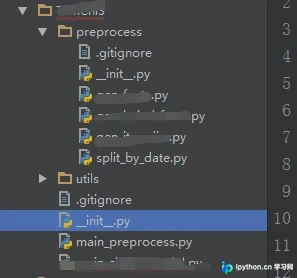
本文总结了在Python中调用不同路径下py文件函数的多种实现方法。针对Python无法自动识别其他文件夹路径的问题,详细解析了五种常见解决方案,包括直接修改sys.path、利用__init__.py构建包、相对导入以及针对特定环境(如Linux)的配置技巧。文章提供了具体的代码示例和目录结构说明,帮助开发者解决跨文件函数调用的路径依赖难题。
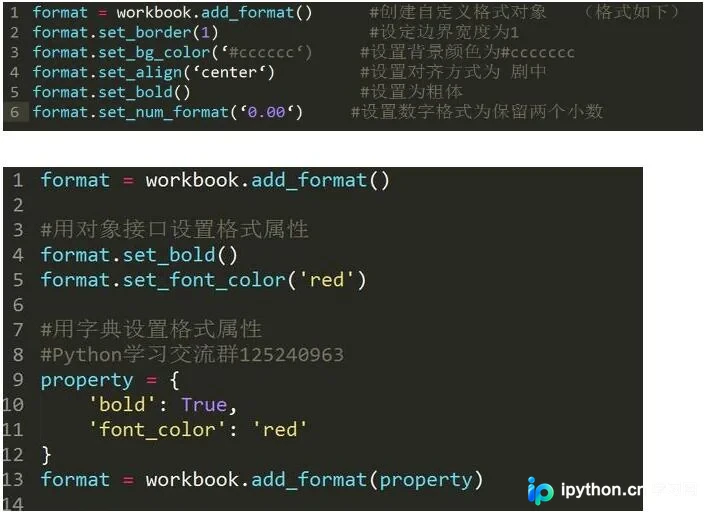
本文介绍如何使用Python的xlsxwriter库处理Excel单元格格式。详细解析了颜色、数字格式、字体、边框、对齐方式及图案等属性,并说明如何将数据转换为相应格式写入xlsx文件,帮助开发者高效实现Excel表格的样式定制。
本文详解如何利用Python的open函数进行文件读写,结合os模块遍历目录,并通过正则表达式re模块从多个文本文件中精准提取指定数据。文章提供了完整的代码示例,演示如何去除换行符、匹配模式并将结果写入新文件,适合需要批量处理文本数据的开发者参考。
本文详细讲解利用Python进行图像类验证码识别的完整流程。从生成测试验证码入手,依次演示灰度处理、二值化及基于邻域算法的降噪技术,并结合TesserOCR库实现自动识别。文章通过对比不同干扰程度下的识别效果,提供了处理简单至中等复杂度验证码的实用代码与策略。
本文介绍如何利用Python内置的SimpleHTTPServer(Python2)或http.server(Python3)模块,在局域网内快速搭建临时文件服务器。通过指定端口启动服务,局域网内其他设备可通过浏览器访问主机IP及端口,直接浏览并下载指定目录下的文件,无需安装额外第三方库。
本文介绍使用Python编写爬虫程序,自动抓取煎蛋网(jandan.net)上的图片并保存至本地文件夹。通过解析网页HTML获取图片链接,利用urllib库发起请求并下载图片文件,支持指定页数批量处理。代码包含页面解析、图片地址提取及文件保存逻辑,适合Python初学者学习网络爬虫基础操作。
本文介绍利用Python标准库datetime和time模块,通过日期加减运算获取昨天、今天和明天的起止时间戳。代码演示了如何计算具体日期的起始与结束毫秒级时间戳,并输出对应数值结果,适用于需要精确时间范围处理的场景。
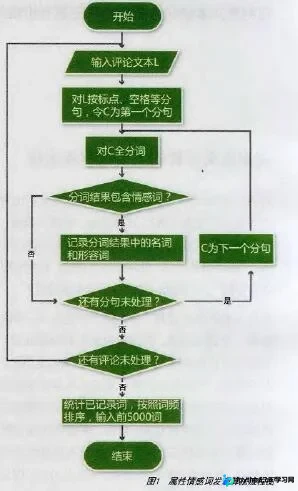
本文介绍一种基于Python的中文用户评论处理方法,旨在从评论文本中自动提取评价对象(属性词)及对应的情感表达。通过观察发现属性词常与情感词伴随出现,且多为名词或形容词。文章提供了详细的算法流程图、示例数据及完整代码实现,展示如何遍历分词结果,识别名词后的情感描述,并处理否定词等特殊情况,最终输出结构化的匹配结果。