Python嵌套列表的引用陷阱与正确初始化方法
本文深入解析Python中嵌套列表的常见陷阱,特别是使用[[0]*3]*5初始化二维列表时导致的引用共享问题。通过区分对象与引用、理解栈与堆内存机制,揭示为何修改一个元素会影响所有行。文章提供了正确的列表推导式和逐行初始化方案,帮助开发者避免此类尴尬错误,写出更健壮的Python代码。
2026-10-14
24

本文深入解析Python中嵌套列表的常见陷阱,特别是使用[[0]*3]*5初始化二维列表时导致的引用共享问题。通过区分对象与引用、理解栈与堆内存机制,揭示为何修改一个元素会影响所有行。文章提供了正确的列表推导式和逐行初始化方案,帮助开发者避免此类尴尬错误,写出更健壮的Python代码。
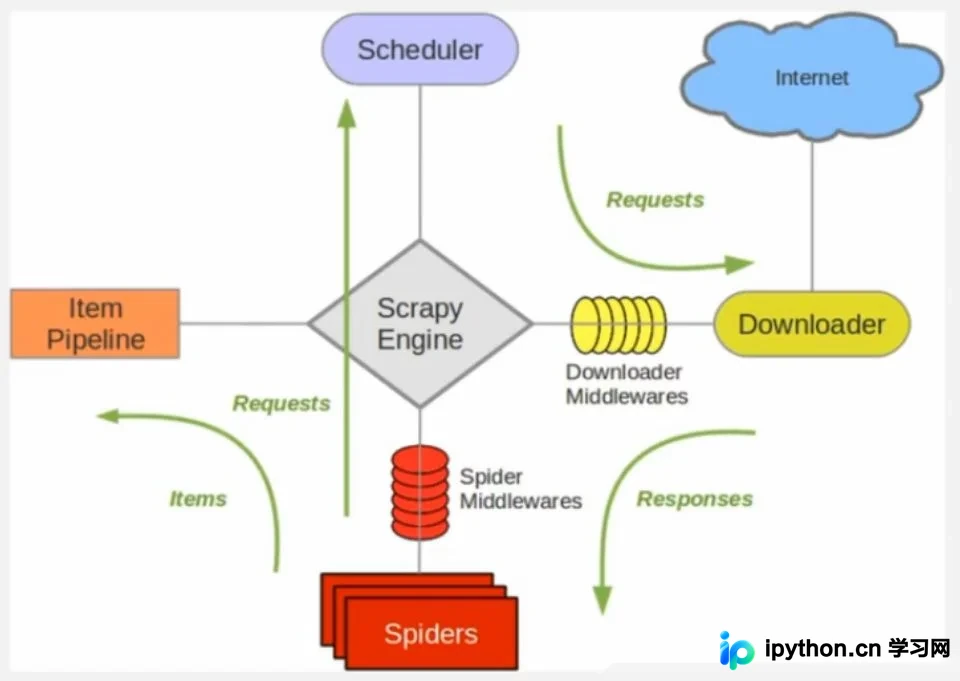
本文深入解析Scrapy-Redis分布式爬虫的核心原理与搭建流程。通过对比Scrapy与Scrapy-Redis的架构图,详细阐述Master端与Slaver端的协作机制,包括URL指纹判重、Request分配及数据存储策略。同时提供从环境配置、依赖安装到代码编写的完整实操指南,帮助开发者高效构建高性能分布式数据采集系统。
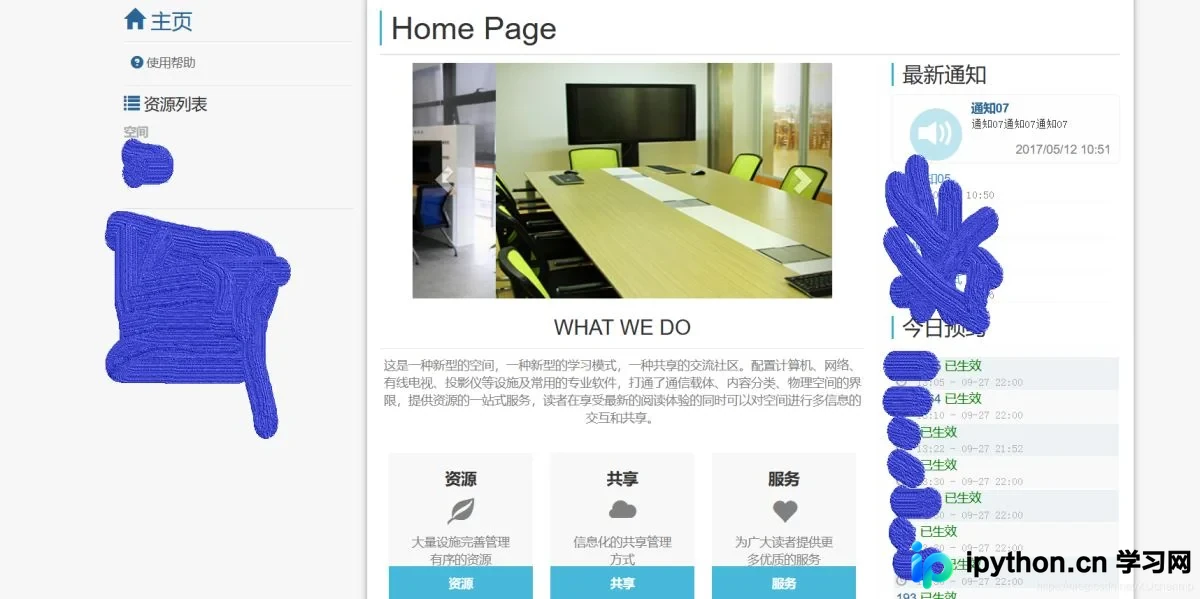
本文介绍使用Python实现图书馆座位自动预约的脚本逻辑。通过F12分析登录与预约接口,利用requests.session保持会话状态。核心优化包括定时在系统开放时发送请求以减轻服务器压力,以及处理撞车情况下的自动顺延策略。代码仅供参考,旨在提供同类系统的开发思路。
本文详细介绍Python中Faker库的安装与基础用法。通过设置locale参数支持多语言环境,涵盖地理、基础信息、网络、加密及时间等类别的随机数据生成方法。最后通过MySQL连接示例,演示如何结合Faker实现数据库表的批量测试数据插入,提升开发测试效率。
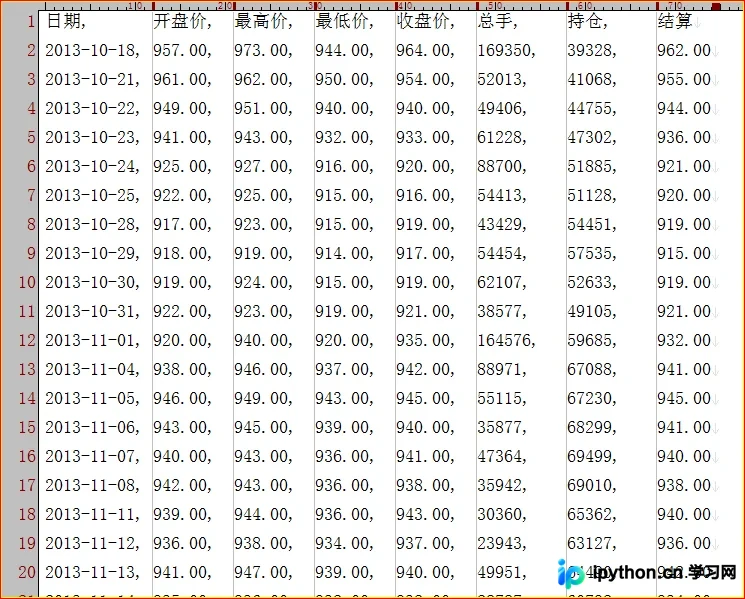
本文介绍如何使用Python的pandas库读取CSV文件并合并两个股票数据集。通过示例代码展示如何将螺纹钢与铁矿石数据按日期关联,实现类似SQL left-join的效果,为后续使用matplotlib绘制历史相关性图表奠定基础。
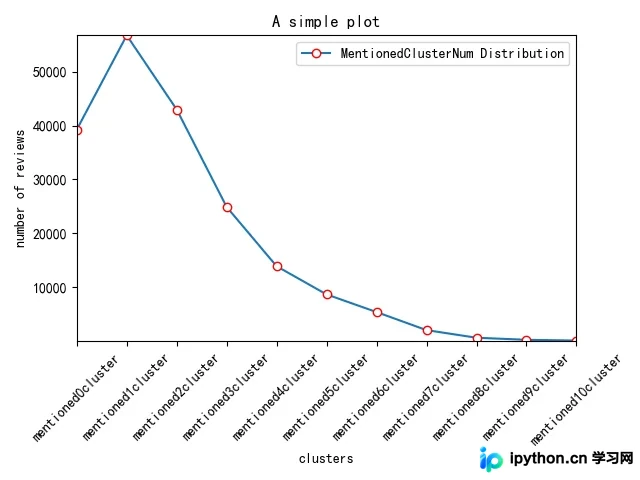
本文介绍如何使用Python的Matplotlib库绘制分布折线图。通过plot()函数设置数据点、标记样式及标签,展示如何生成包含特定数据分布的折线图,并解决中文显示与坐标轴调整问题,提供完整可运行代码示例。
本文介绍Python中判断元素是否存在于序列的两种主要方法。首先讲解in和not in运算符的用法,通过示例展示其返回布尔值的特性;其次演示如何通过for循环遍历列表来查找特定元素,对比两种方式的代码实现与输出结果,帮助开发者根据场景选择合适方案。
本文介绍如何在Python中利用行人检测得到的中心坐标绘制场景热力图。通过获取Bounding Box中心点并传入HeatMap库,可生成热力层。代码演示了如何将热力图以指定透明度加权叠加至原图,并通过调整半径参数控制可视化效果,适用于人群密集度等场景分析。
本文详细介绍如何利用Python的Paramiko库实现交换机的自动化巡检。通过读取设备列表和指令文件,脚本可自动连接交换机并执行环境、CPU、内存及日志等关键状态检查命令,适用于批量网络设备的日常运维监控。
本文详解Python中获取当前文件路径的多种方法,包括__file__与inspect模块的使用差异。介绍如何获取调用者文件路径、当前工作目录及通过os.path提取目录。同时涵盖文件读写模式(r, w, a等)及目录创建、删除、遍历等常用操作,提供完整代码示例。
本文详细解析迪杰斯特拉(Dijkstra)算法的核心思想与Python实现过程。文章首先阐述算法基于最优子结构的贪心策略,明确其适用于无负权值的有向图。随后分步讲解算法操作流程,包括集合S与U的维护、距离更新机制及终止条件,并附带完整的Python代码示例,帮助读者深入理解单元最短路径问题的求解逻辑。
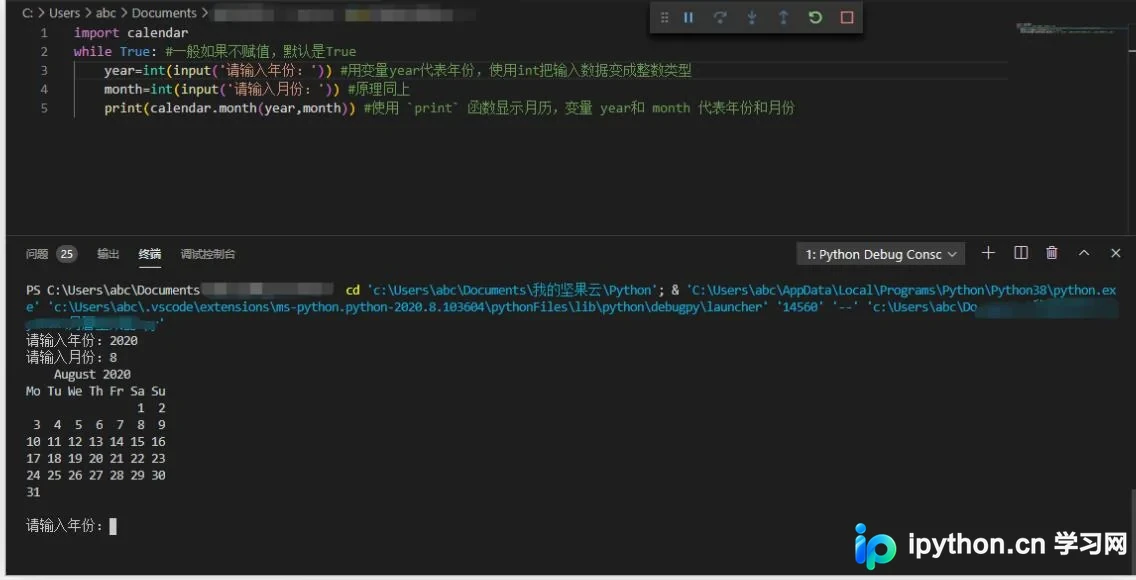
本文介绍如何使用Python仅6行代码快速制作一个可重复运行的月历生成器。通过调用系统内置的calendar模块,结合input输入年份月份及while循环,即可实现指定年月日历的打印输出,适合Python初学者练习基础语法与模块应用。