Python实现伯努利试验与二项分布模拟详解
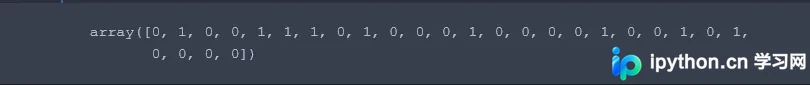
本文介绍如何使用Python中的scipy.stats和NumPy库模拟伯努利试验与二项分布。通过生成冻结分布函数,模拟27次硬币投掷结果,并绘制不同概率和试验次数下的二项分布概率质量函数图,帮助读者理解概率统计在编程中的实际应用。
2026-10-13
22

本文介绍如何使用Python中的scipy.stats和NumPy库模拟伯努利试验与二项分布。通过生成冻结分布函数,模拟27次硬币投掷结果,并绘制不同概率和试验次数下的二项分布概率质量函数图,帮助读者理解概率统计在编程中的实际应用。
本文介绍如何利用Python编写自动化脚本,解决学校疫情通每日手动填报繁琐的问题。通过抓取网页请求头与主体,模拟提交数据,并结合SMTP模块实现执行结果的邮件通知。最后通过Linux Crontab设置定时任务,实现每日早晨自动运行,提高填报效率并减少人为遗漏。
本文深入解析Python语言的核心特性,包括其解释型、面向对象及动态语义的特点。回顾从1989年创始至今的版本演进,对比Python 2与3的差异。详细阐述Python在Web开发、数据科学及人工智能领域的广泛应用,并解读其“优雅、明确、简单”的设计哲学。
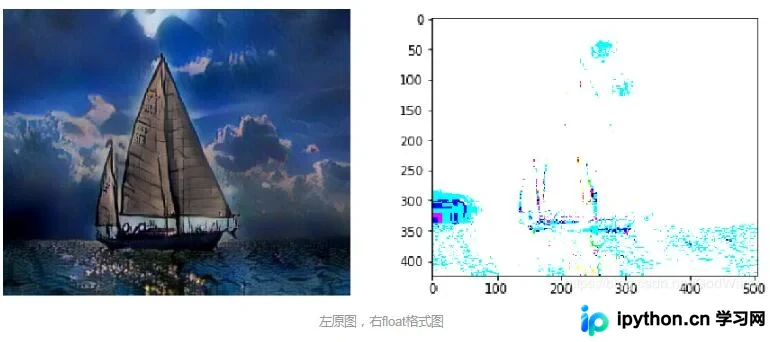
本文详解在TensorFlow中加载Vgg预训练模型时遇到的uint8与float数据类型不匹配报错。通过对比tf.image.decode_jpeg默认行为,说明使用tf.to_float进行类型转换的必要性与安全性,并指出保存float格式图片时需转回uint8,否则会导致显示异常或API报错。
本文详细介绍TensorFlow中模型固化的两种核心方法:使用freeze_graph工具以及通过convert_variables_to_constants将变量转换为常量。文章涵盖从生成PB和CKPT文件、构建固化命令、编写转换代码到最终测试加载模型的全流程,旨在帮助开发者解决移动端无法训练仅能推理的问题,实现参数与图结构的统一保存。
本文介绍如何利用pandas库向现有CSV文件追加新的列和行数据。首先通过Excel准备包含中文编码的CSV文件,接着演示使用df['列名']赋值方式添加整列数据,以及通过df.loc索引定位添加特定行数据。文中包含完整的代码示例及文件路径、编码格式等关键参数说明,适用于Python初学者进行基础数据操作。
本文介绍如何使用Python内置的configparser库对ini配置文件进行读取、增加、删除节点及修改键值等操作。通过具体代码示例,展示了加载文件、获取数据、添加新节点、删除节点以及保存修改后的文件等完整流程,帮助开发者快速掌握配置文件管理技巧。
本文介绍在TensorFlow中扩展矩阵维度的两种方法:传统的tf.expand_dims()函数以及利用索引操作符[]配合tf.newaxis的新技巧。通过具体代码示例,展示如何灵活地在指定维度插入新轴,适用于文本挖掘、卷积神经网络等场景中的张量形状调整。
本文详细介绍在TensorFlow Keras卷积神经网络中添加L2正则化的方法。通过修改Conv2D层的kernel_regularizer参数,可有效防止模型过拟合。文章涵盖正则化原理、L1/L2公式区别、损失函数构建及集合管理技巧,并提供完整代码示例供参考。
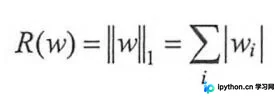
本文详细介绍如何在Django项目中集成Redis作为缓存后端。通过安装django-redis库,修改settings.py配置缓存后端、地址及过期时间,并提供了在Django Shell和独立脚本中进行读写验证的具体代码示例。同时包含解决ipython版本兼容性问题的建议,帮助开发者快速完成缓存环境搭建与功能测试。
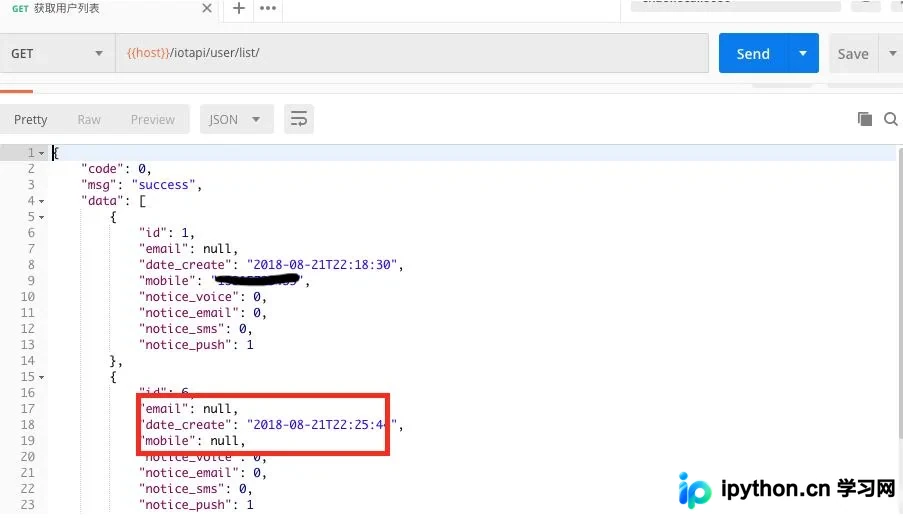
本文介绍如何在Django REST Framework中通过重写to_representation方法,将序列化返回的null字段转换为空字符串,避免前端数据异常。同时补充排查数据库导入数据导致QuerySet返回空集合的常见原因及比对修复方法。
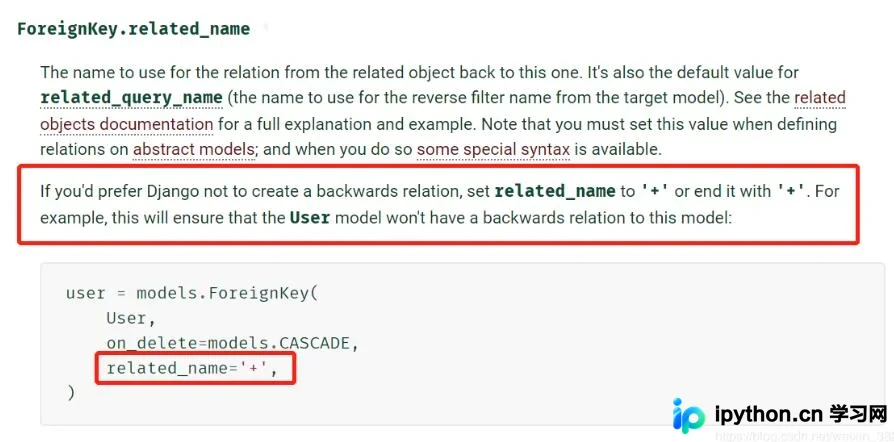
在 Django 模型继承场景中,若多个子类共享基类且拥有相同的外键字段,会触发反向访问器冲突错误。本文介绍了使用 %(class)s 字符串替换机制为每个子类生成唯一的 related_name,从而避免冲突。同时提及通过设置 related_name 为 '+' 来禁用反向映射的官方推荐方案,帮助开发者正确处理外键关系。