Pandas groupby 怎么用?从入门到实战讲清分组聚合、变换与筛选
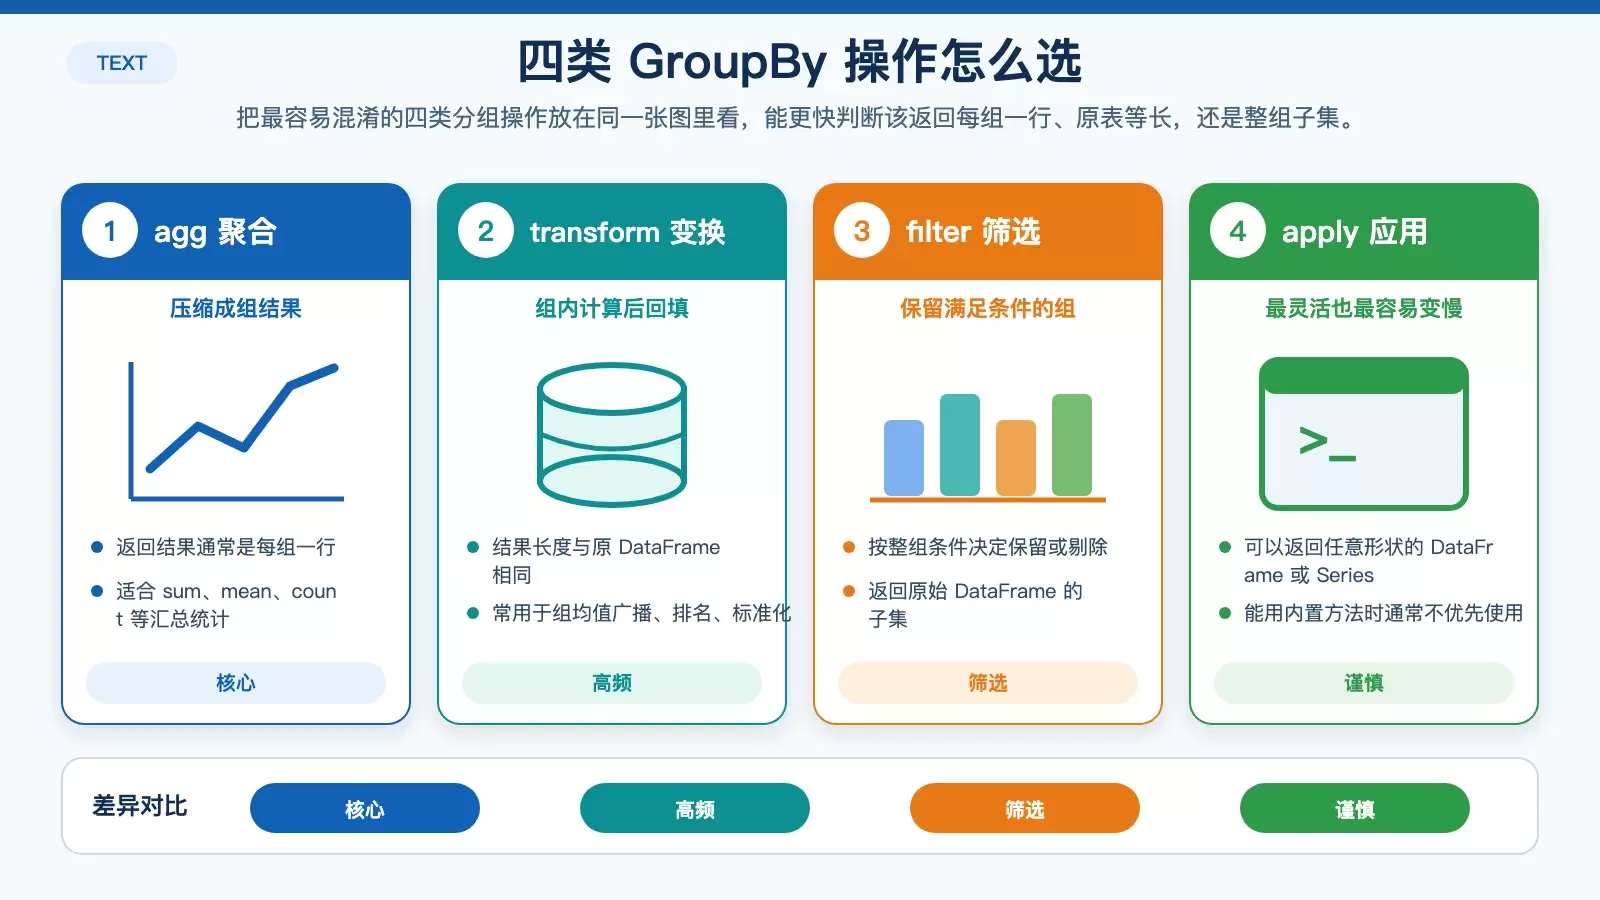
这篇文章围绕 Pandas `groupby()` 的常见使用场景,系统梳理了分组对象创建、聚合、`transform`、`filter`、`apply` 以及多种实战技巧。重点不只在语法罗列,还会说明什么时候该用哪一种方法,以及如何兼顾结果形状、可读性与性能。
2026-08-22
190

这篇文章围绕 Pandas `groupby()` 的常见使用场景,系统梳理了分组对象创建、聚合、`transform`、`filter`、`apply` 以及多种实战技巧。重点不只在语法罗列,还会说明什么时候该用哪一种方法,以及如何兼顾结果形状、可读性与性能。
在 CentOS 上部署 C++ 程序,核心不只是把二进制传到服务器,更在于编译环境、依赖库和进程托管三件事是否处理到位。本文按“准备工具链、编译、排查依赖、上线运行、接入 systemd”的顺序梳理整套流程,并补上生产环境下常见的维护建议。
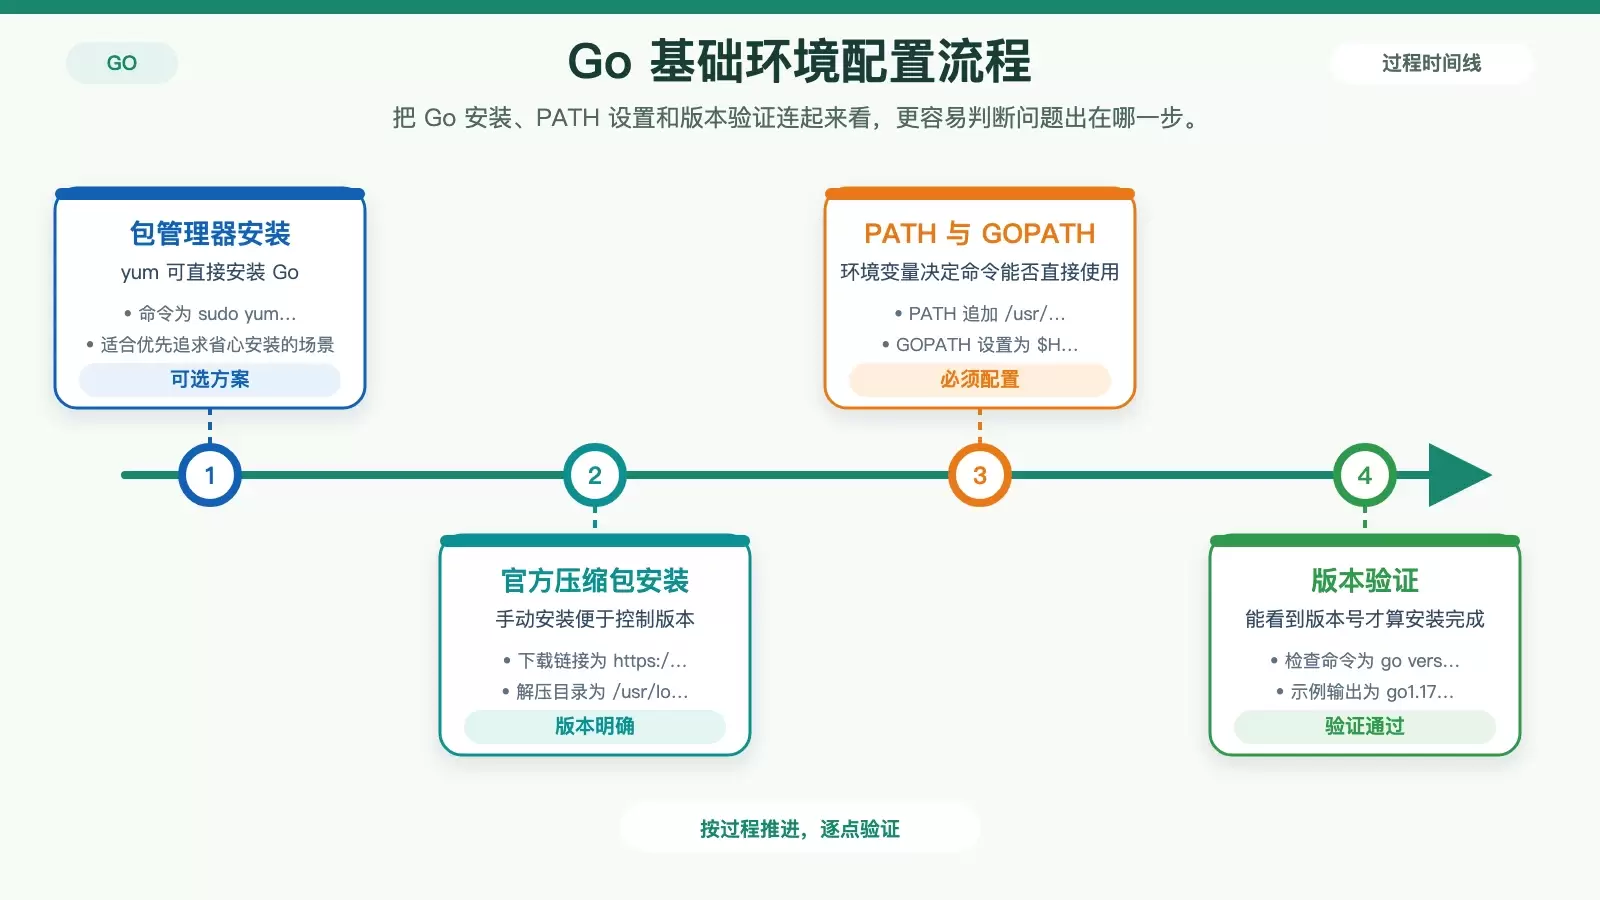
这篇文章梳理了在 CentOS 上配置 Go 打包环境的完整步骤,包括安装 Go、设置 PATH 与 GOPATH、启用 Go Modules、执行本地构建,以及按需进行交叉编译。文中保留了原始命令,适合需要快速搭起可用编译环境的开发者参考。
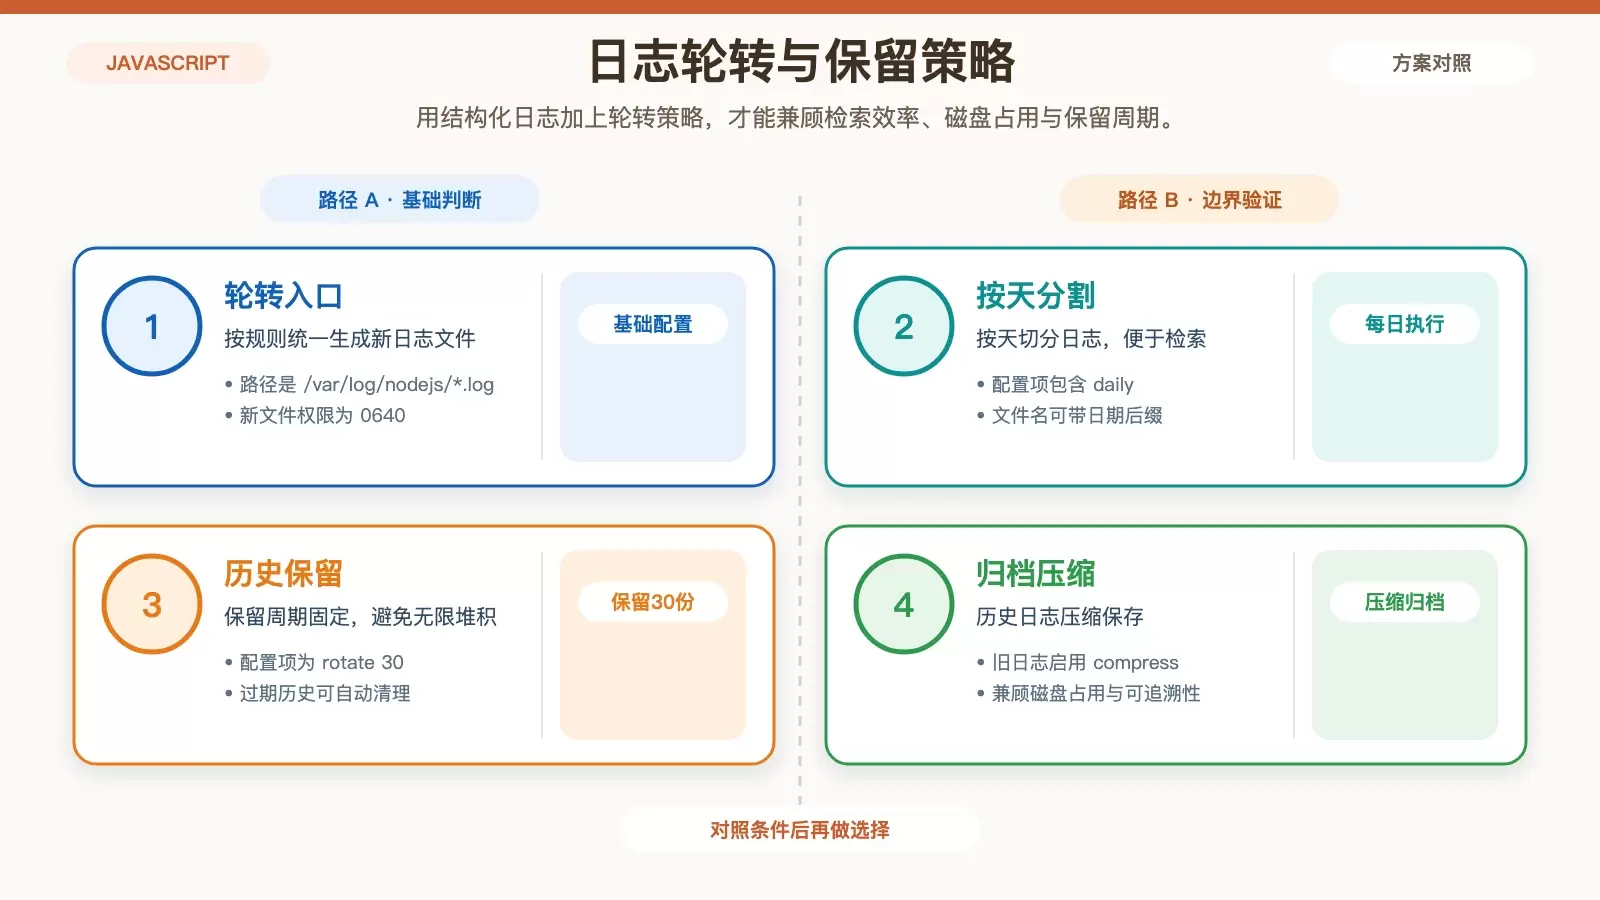
Linux 上跑 Java 服务时,日志膨胀往往比预期更快。本文从系统工具、Shell 脚本、日志框架、systemd 日志和手动清理五个层面梳理可用方案,帮助你按部署方式和保留要求选出更稳妥的清理策略。 Java 服务跑在 Linux 上,日志失控通常不是偶发问题,而是缺少轮转和保留策略的结果。
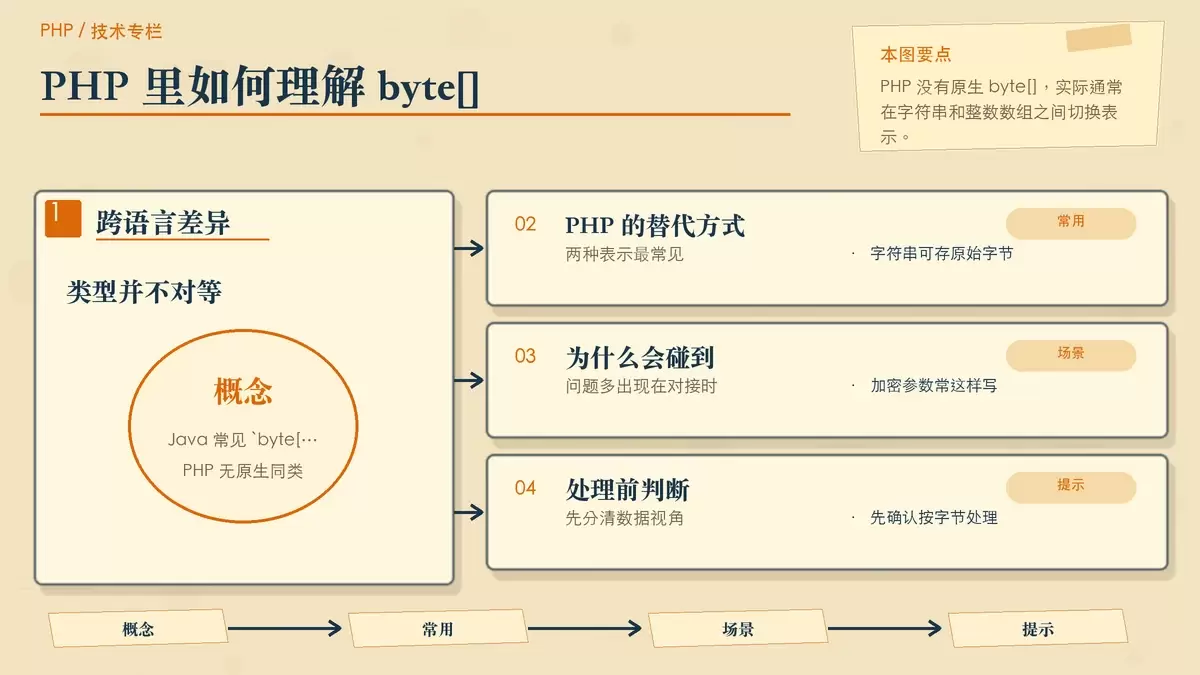
在 PHP 里没有像 Java 那样直接可用的 `byte[]` 类型,但在做加密、协议对接或跨语言数据处理时,字符串和字节数组之间的转换仍然很常见。本文用一组简单函数说明两种转换的写法,并解释它们各自依赖的 `chr()`、`ord()` 与按字节遍历方式,方便你判断这类代码该在什么场景下使用。
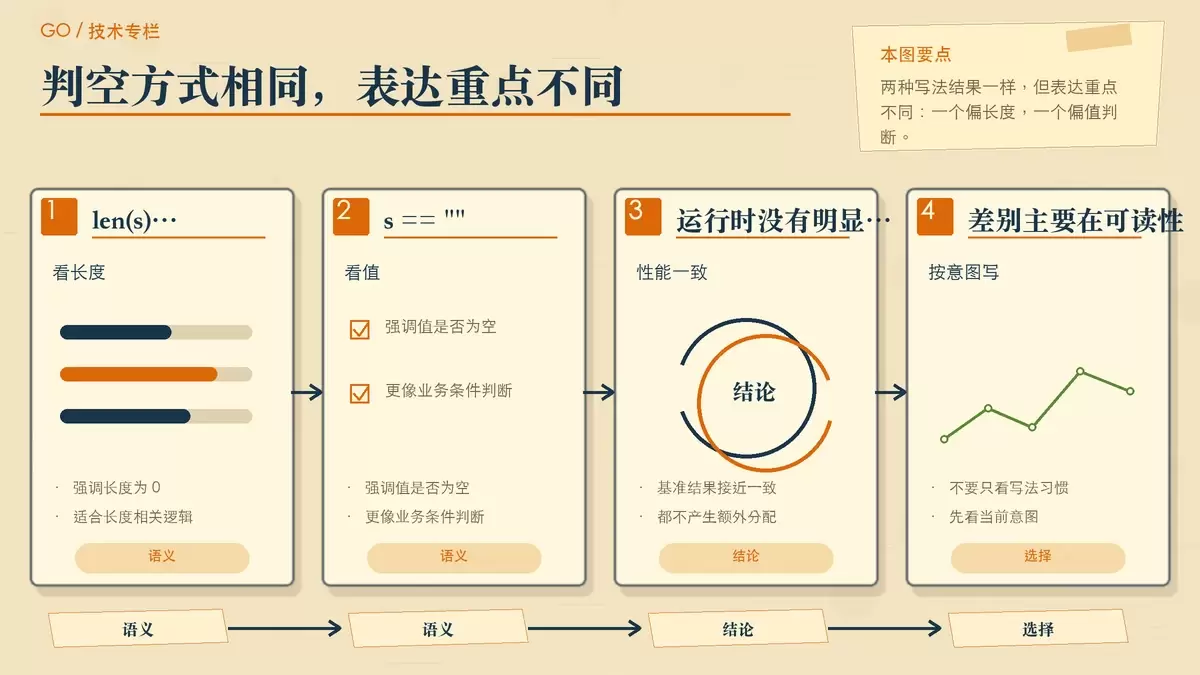
在 Go 里判断字符串是否为空,常见写法是 `len(s) == 0` 和 `s == ""`。两者在运行时性能基本没有差别,关键区别在于语义表达:前者强调长度,后者强调值。真正的选择标准,不是“哪个更快”,而是当前代码想表达什么。
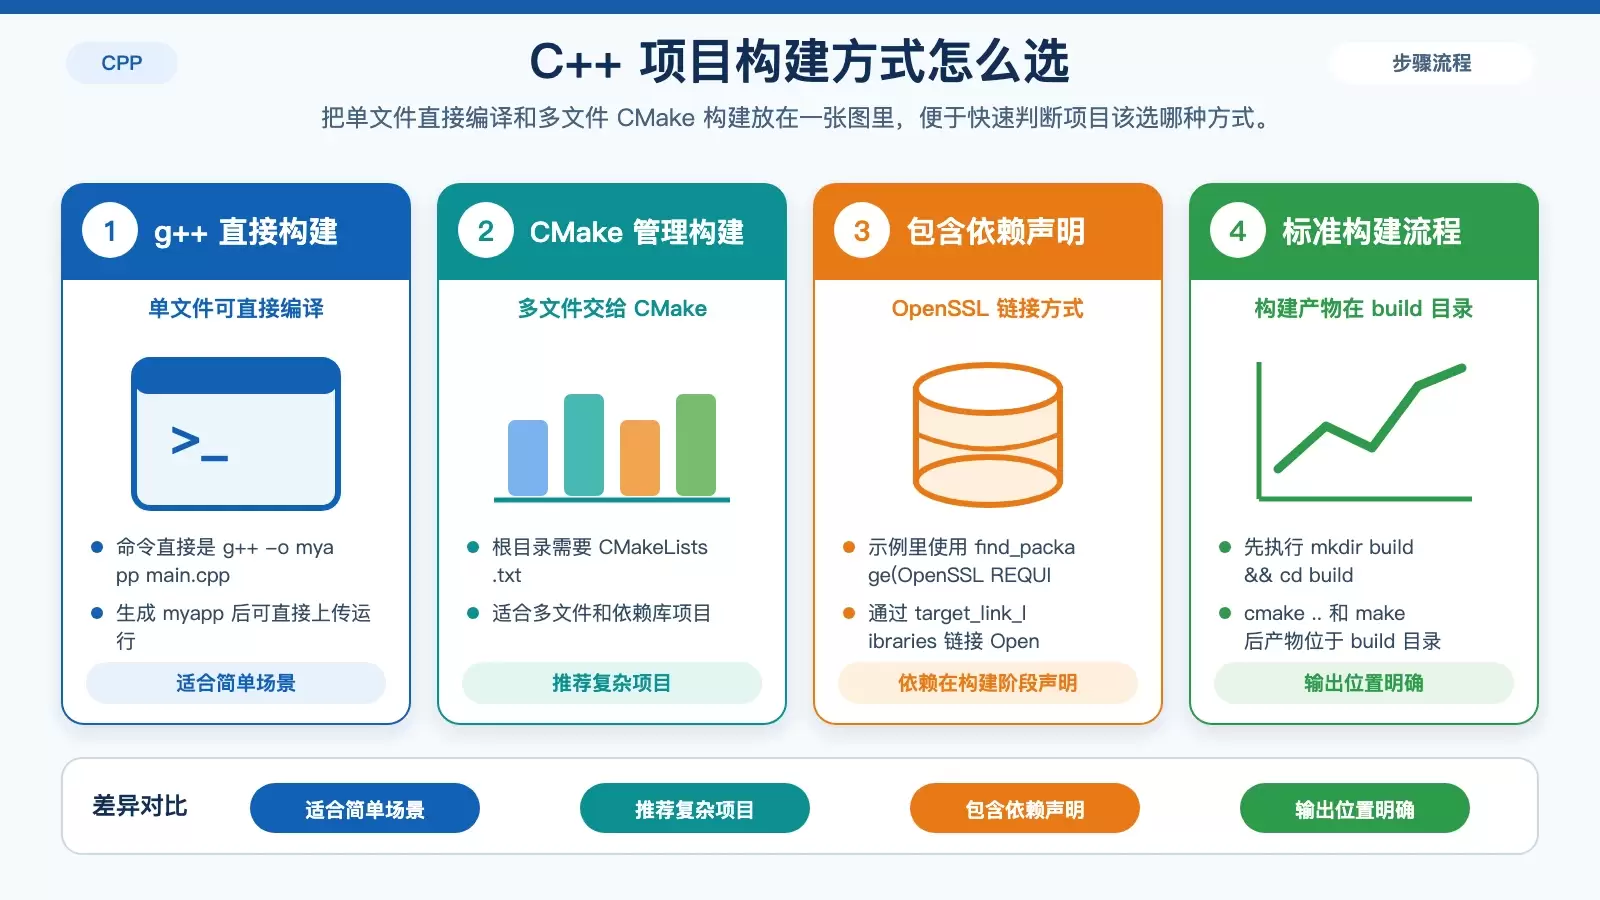
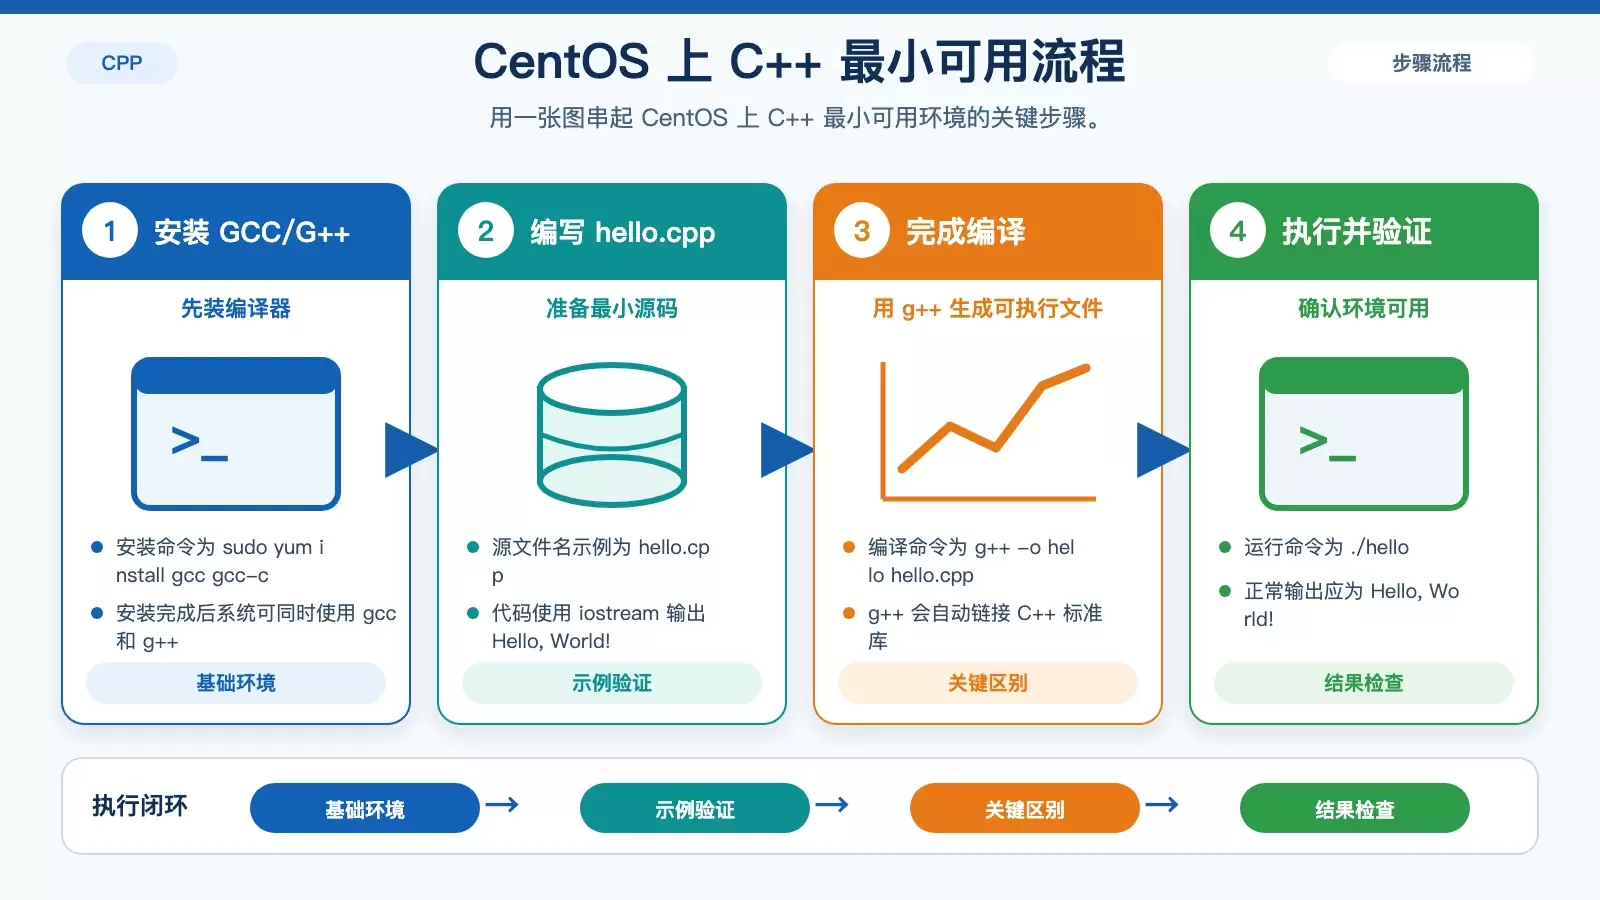
这篇文章用一套最小可用流程,梳理了在 CentOS 上用 GCC/G++ 搭建 C++ 编译环境的方法,包括安装编译器、编写示例程序、编译运行、常用参数选择,以及 gdb、make、cmake 的基本用途,适合刚开始在 Linux 上做 C++ 开发的读者快速上手。
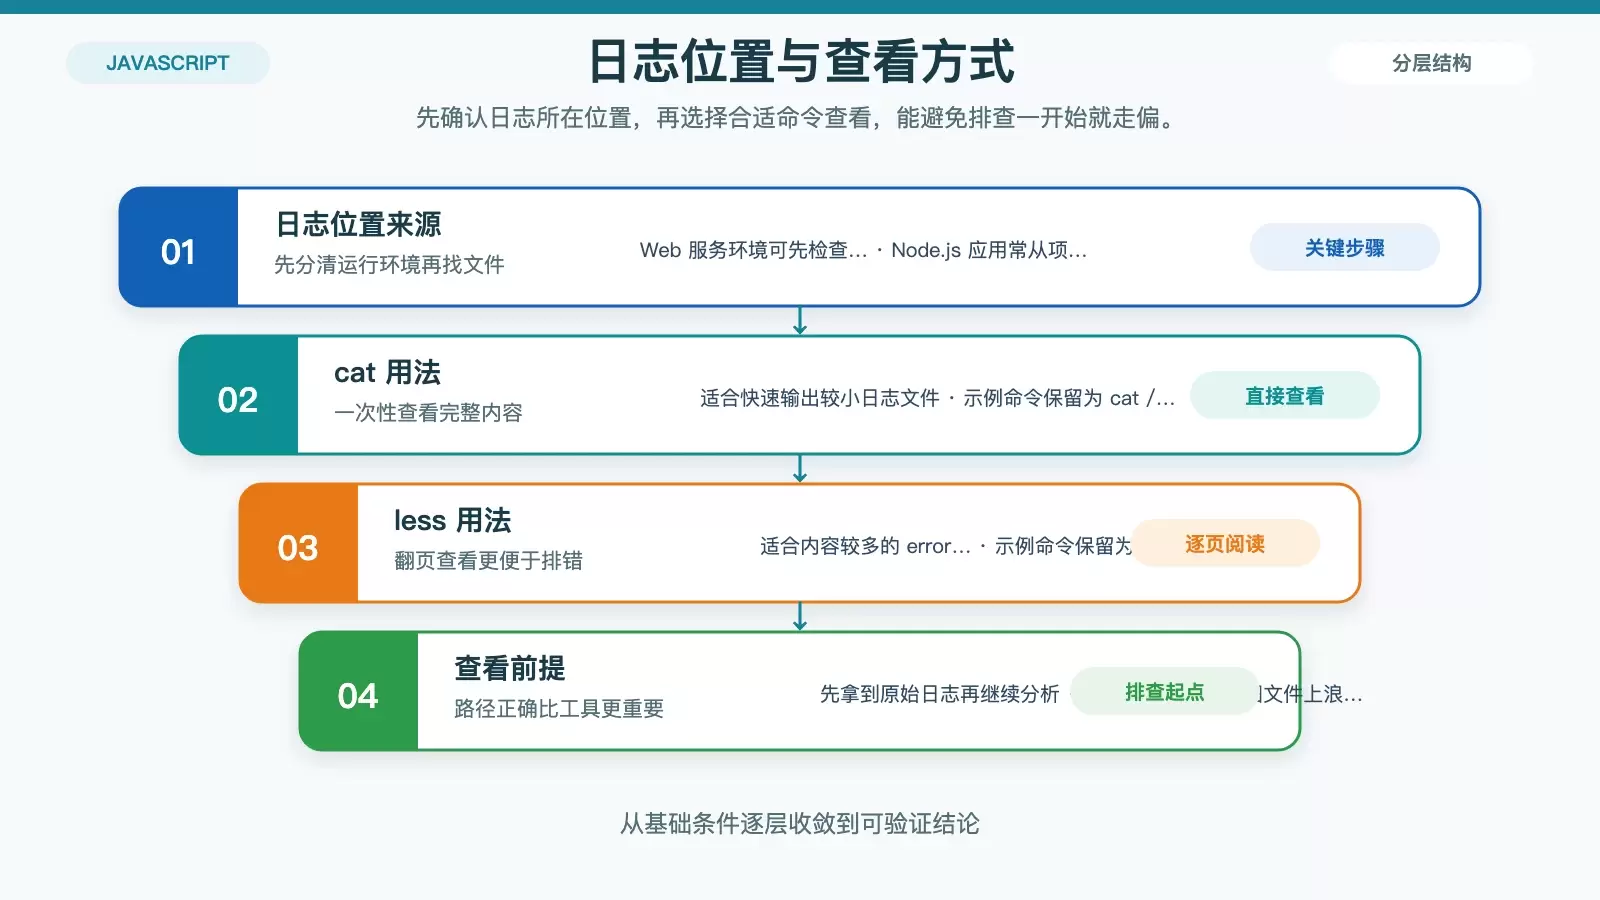
在 CentOS 上排查 JavaScript 报错,关键不在“会不会看日志”,而在于能否按顺序完成定位、分析和修复。本文把日志位置、查看命令、报错字段判断、代码修复以及后续监控整理成一套简明流程,适合 Web 服务和 Node.js 应用快速参照。
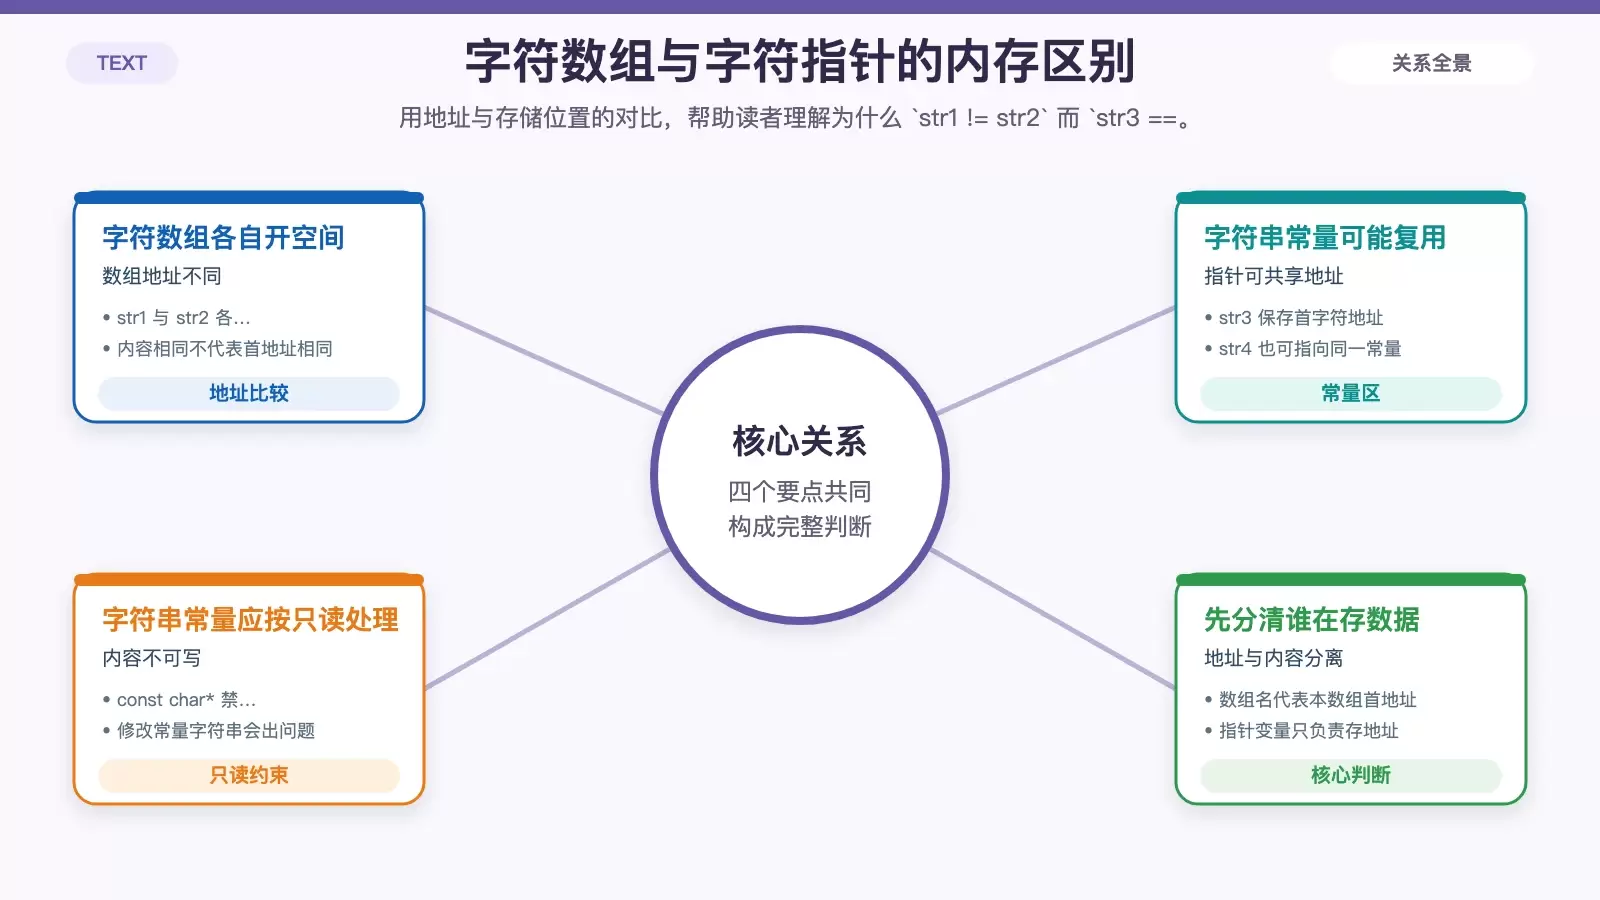
这篇文章围绕 C 语言里的字符指针展开,重点解释“指针里存的到底是什么”、`const char*` 与字符数组的差别,以及为什么有些字符串地址比较会相等。读完后,你可以判断字符指针何时指向变量、何时指向字符串常量,并理解 `[]` 与指针运算之间的对应关系。
在 Ubuntu 上做 Node.js 日志安全审计,重点不只是“把日志记下来”,而是让日志可检索、可控、可追溯。本文从日志库选择、轮转权限、加密、监控告警到定期审查与更新维护,梳理一套更适合生产环境落地的审计思路。
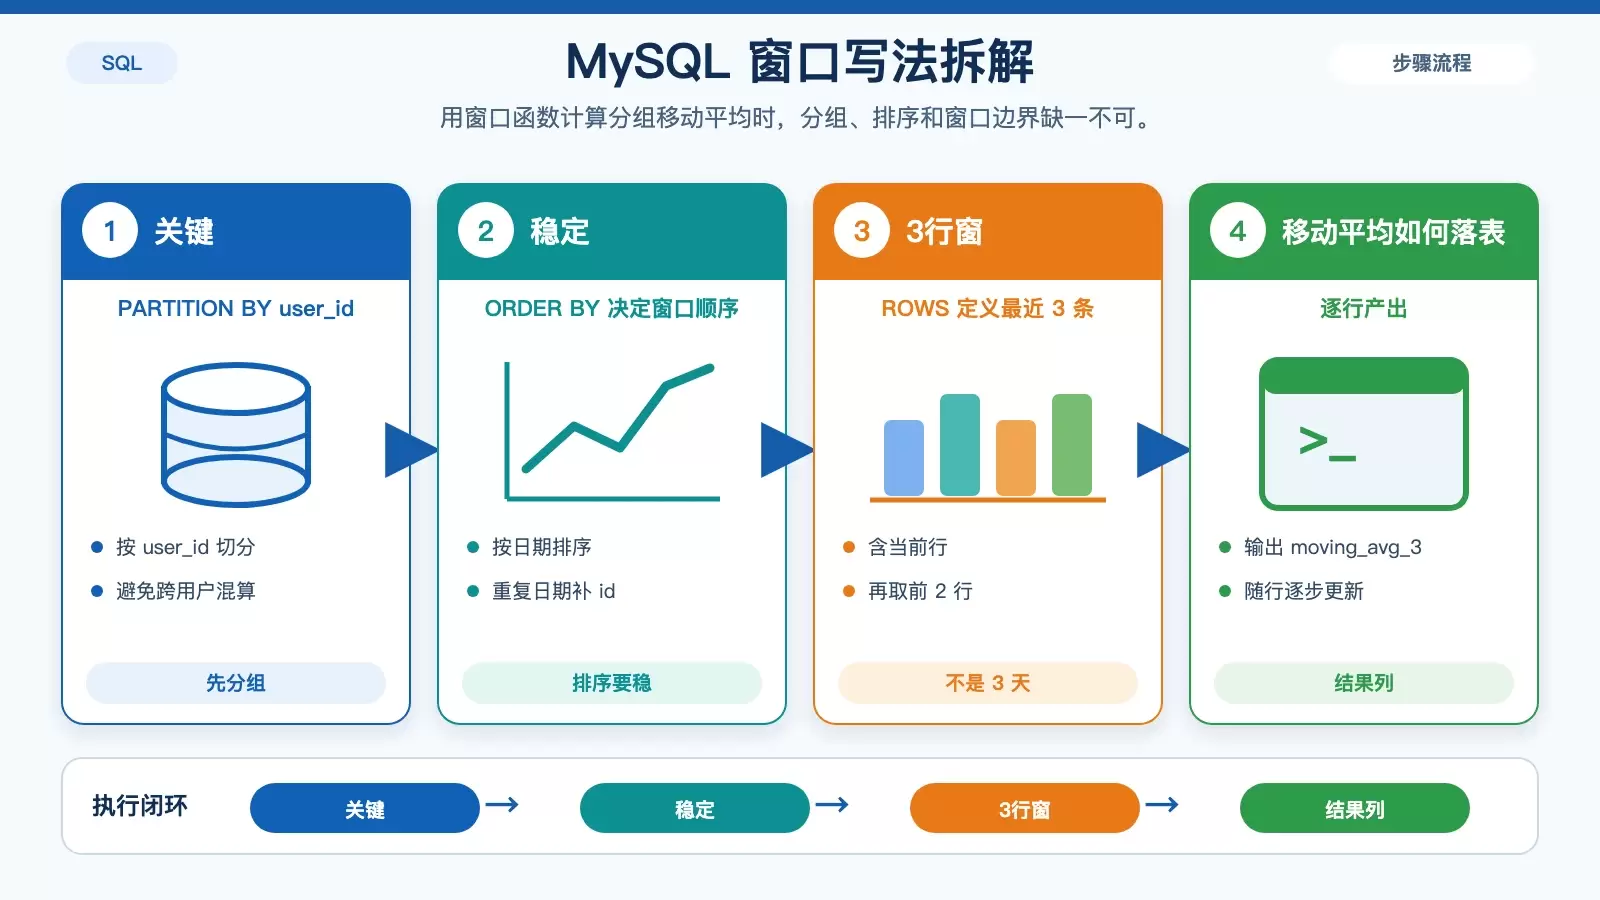
分组移动平均在 SQL 里不难,真正容易出错的是窗口怎么定义、分组是否隔离,以及数据库版本对 `ROWS`、`RANGE` 的支持差异。本文按 MySQL、PostgreSQL、SQL Server 与 SQLite 分别梳理可用写法,并补上边界行与 `NULL` 处理时最常见的误区。
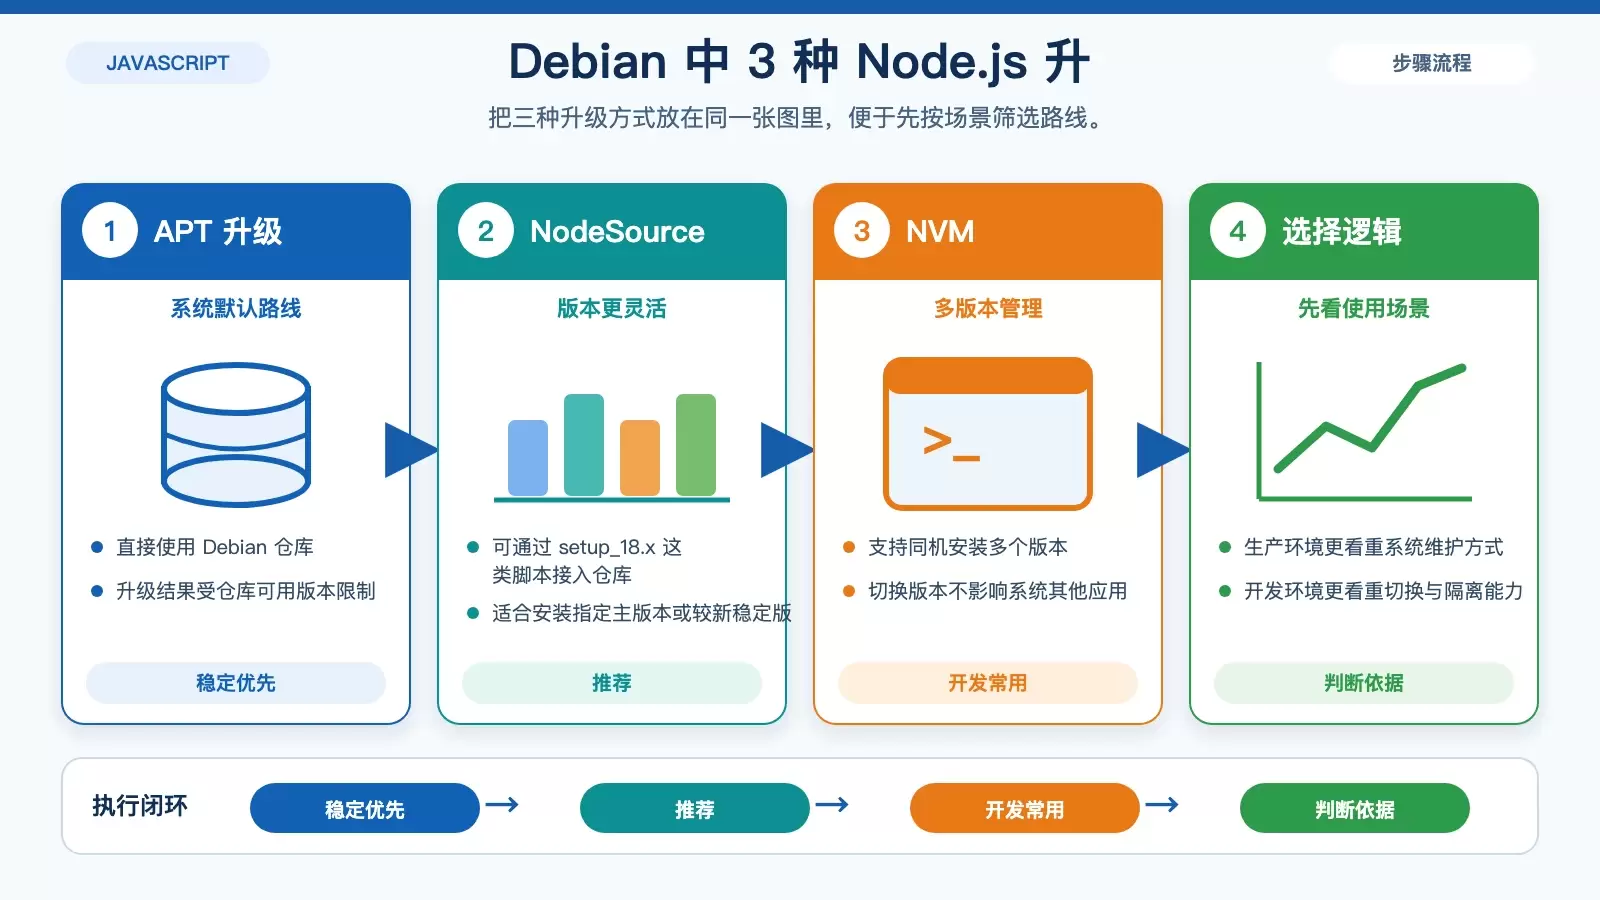
在 Debian 上升级 Node.js,常见路径有 APT、NodeSource 和 NVM 三种。它们分别侧重系统稳定、版本可控和多版本切换,是否再配合 unattended-upgrades,则取决于你是否希望持续接收安全更新。 在 Debian 上升级 Node.js,真正难点往往不是命令本身,而是先分清你要的是系统仓库的稳定版本、某个指定主版本,还是开发环境里的多版本共存。