

Python列表推导式:语法、条件与嵌套应用详解
本文深入解析Python列表推导式的核心用法,涵盖基础语法结构、带条件的元素筛选以及多层嵌套的高级应用。通过具体代码实例展示如何高效处理列表数据、提取矩阵元素及生成笛卡尔积,帮助开发者掌握这一简洁强大的编程技巧,提升代码可读性与执行效率。
2026-10-15
12

本文深入解析Python列表推导式的核心用法,涵盖基础语法结构、带条件的元素筛选以及多层嵌套的高级应用。通过具体代码实例展示如何高效处理列表数据、提取矩阵元素及生成笛卡尔积,帮助开发者掌握这一简洁强大的编程技巧,提升代码可读性与执行效率。
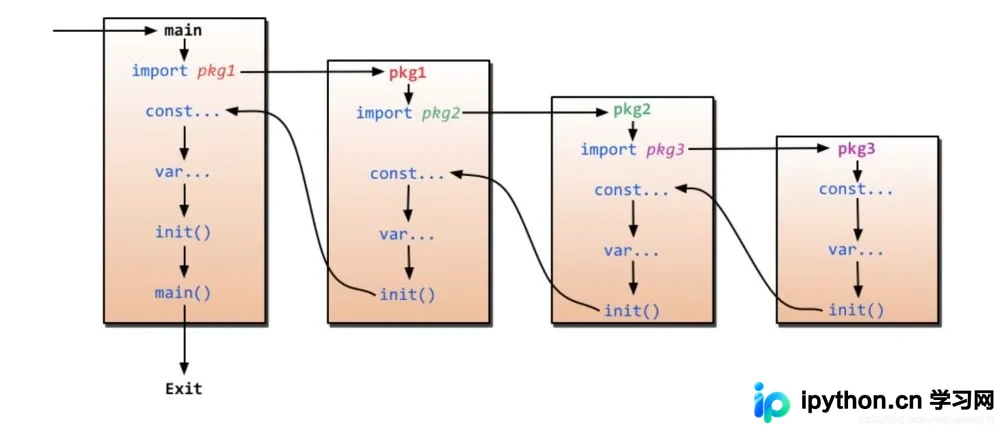
本文详细解析Golang中init函数的特点及在不同场景下的执行顺序。涵盖单文件、多文件同包、存在依赖的多包以及包级变量初始化的顺序规律,并指出应避免强依赖init顺序以确保代码健壮性。
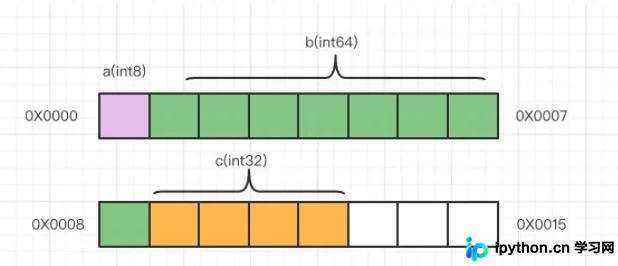
本文详解Golang结构体的内存分布机制,剖析CPU读取效率与内存对齐的关系。通过对比不同字段排列顺序的结构体大小,展示如何利用unsafe.Sizeof检测内存浪费,并给出按数据类型大小降序排列字段的优化方案,帮助开发者编写更高效的Go代码。
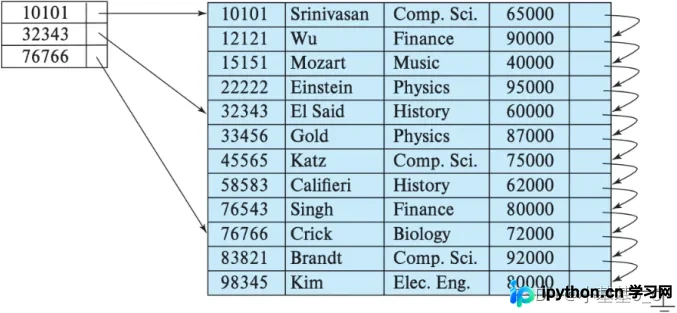
本文详细讲解ClickHouse的核心表引擎,重点分析MergeTree家族的ORDER BY、PRIMARY KEY及分区策略,阐述TTL机制管理数据生命周期,并介绍ReplacingMergeTree与SummingMergeTree在去重和聚合场景的应用,最后对比TinyLog、Memory等小型引擎的特性。
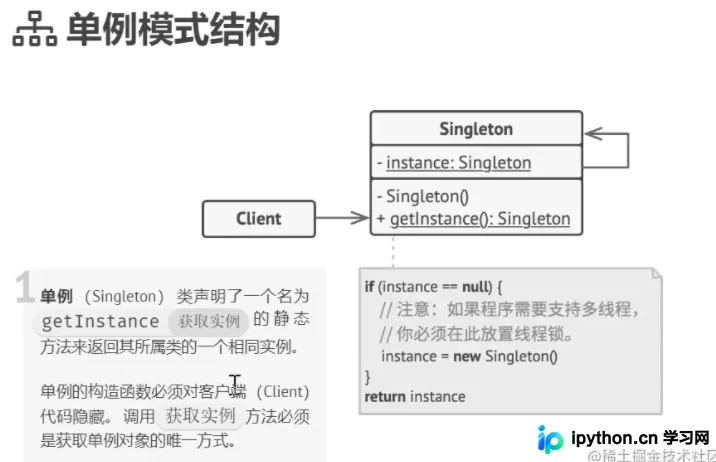
本文详解Go语言中单例模式的实现原理、场景及应用。通过示例演示如何在Go中利用包级变量创建单例,并重点解决多线程环境下的竞争问题,提供sync.Once和互斥锁两种安全实现方案,确保程序执行期间类仅有一个实例且全局可访问。
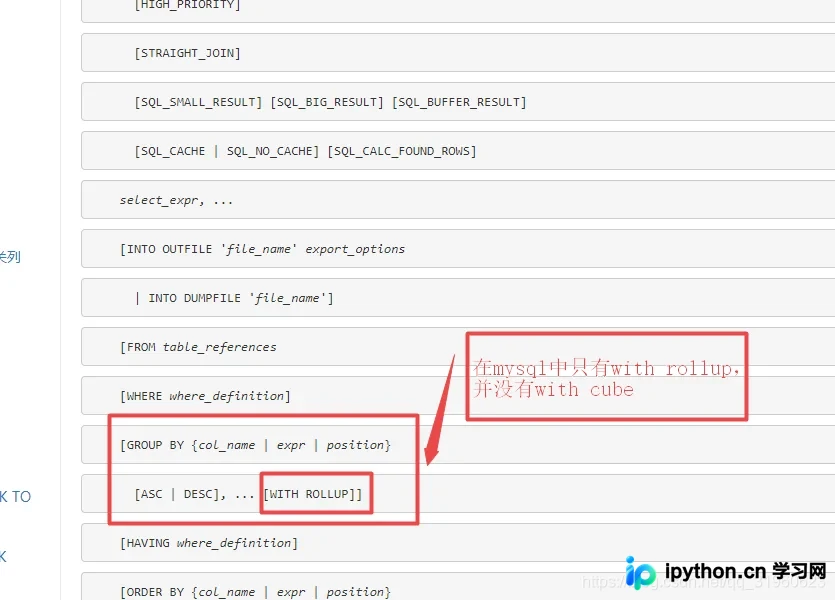
本文详细介绍MySQL中使用GROUP BY时配合WITH ROLLUP关键字实现多层级汇总统计的方法。通过学生成绩和自定义业务场景实例,演示如何自动生成合计行并处理NULL值。同时对比了ROLLUP与CUBE在聚合维度上的差异,指出MySQL对Cube的支持限制及使用注意事项,帮助开发者高效编写聚合SQL。
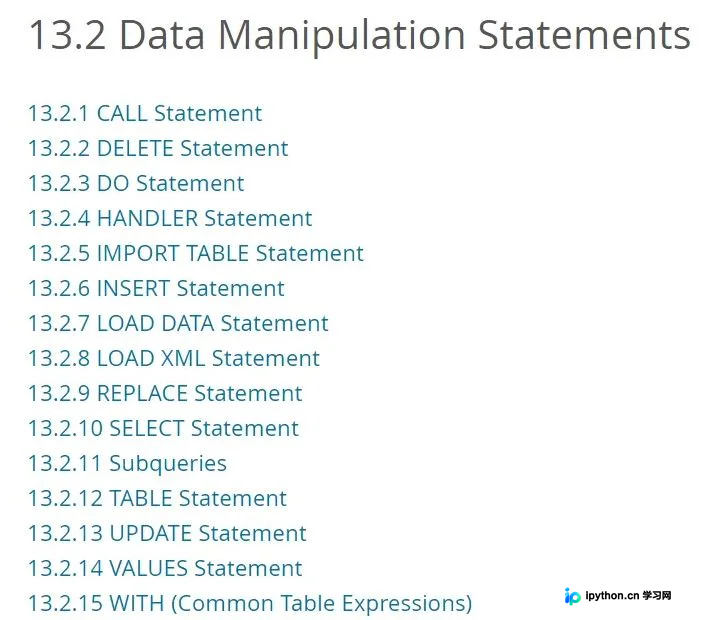
本文深入解析MySQL中INSERT、DELETE、UPDATE及SELECT等数据操作语句的语法原理与常见陷阱。重点介绍INSERT的并发处理、DELETE的大批量删除策略,并详细剖析因数据类型不一致导致的隐式类型转换问题及其对索引和性能的影响,提供避免全表扫描的生产环境解决方案。
本文深入解析C#中创建数组深拷贝的两种核心方法:Array.Copy与Buffer.BlockCopy。通过实际代码演示其基本用法,并引入Benchmark测试验证在大数据量场景下Buffer.BlockCopy在数值类型上的显著性能优势,帮助开发者根据数据类型和性能需求做出最佳选择。
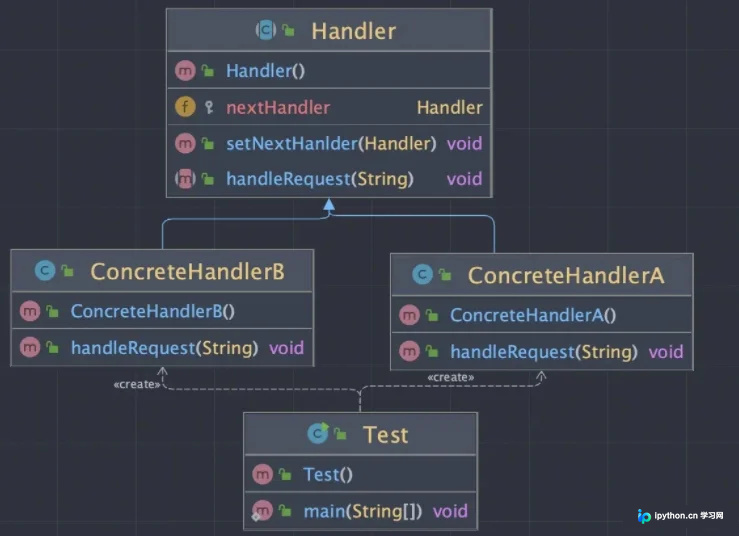
详解Java中的责任链设计模式,通过登录验证场景展示如何消除冗余条件判断。文章涵盖UML结构、Handler抽象类实现、具体拦截器编写及Builder模式自动组装链路的高级用法,兼顾解耦与开闭原则。
本文深入解析 Python 中 lambda 匿名函数的定义、语法及核心应用场景。通过对比 def 语句,阐述 lambda 在 map、filter 等函数式编程中的优势,并展示如何利用闭包创建动态函数工厂,帮助开发者编写更简洁高效的代码。
本文详解在Go语言中如何高效遍历各类数据结构。通过for循环与range关键字处理数组和字符串,利用无序迭代遍历Map,并结合reflect包实现Struct字段的结构化读取。涵盖索引忽略、类型转换及性能注意事项,适合Go入门与进阶开发者参考。
本文深入解析Java单例模式的8种实现方式,涵盖基础写法、饿汉式、线程不安全/安全的懒汉式、双检锁(DCL)、静态内部类及枚举单例。重点对比各模式在内存占用、线程安全及性能上的差异,并推荐使用静态内部类和枚举作为生产环境的标准方案,辅以工具类简化实现。