

MySQL中WITH ROLLUP用法详解及与CUBE区别

在使用MySQL进行数据统计时,除了常规的分组查询,经常需要生成包含总计或分级汇总的结果集。本文将解析GROUP BY子句中WITH ROLLUP关键字的用法,通过实际案例展示如何实现自动聚合,并澄清其与CUBE操作的区别及版本兼容性。
结果目标:实现分层级数据汇总
在进行分类统计时,通常使用GROUP BY对数据进行分组。若需要在各组统计数据的基础上,进一步对部分或全部字段进行层级汇总(例如按班级统计分数后,再统计全校总分),手动多次查询拼接效率较低。WITH ROLLUP正是为此设计,它能在分组结果末尾附加聚合行。
第1步:基础环境准备与表结构理解
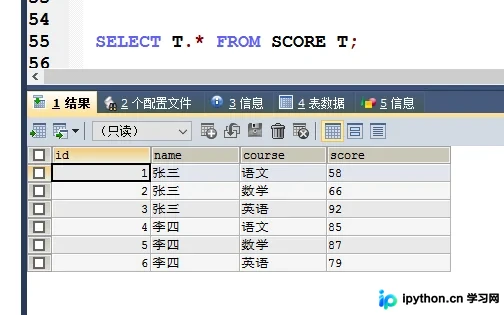
首先,我们需要一个包含多维属性的测试数据表。假设有一张学生成绩表,包含“科目”和“分数”等字段。为了演示清晰的分组效果,我们参考以下数据结构示意:
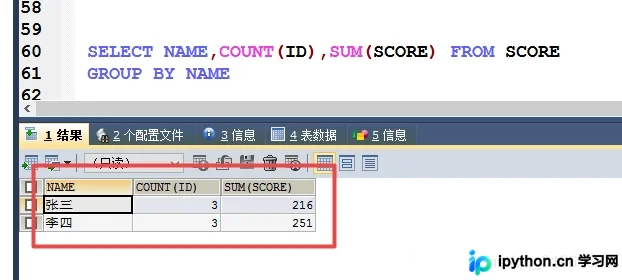
若仅使用标准GROUP BY,我们只能得到每个分组的静态统计值:
例如,统计各科目的总分:SELECT subject, SUM(score) FROM grades GROUP BY subject;。此时结果集中没有“所有科目总平均分”这一行。
第2步:使用 WITH ROLLUP 生成汇总行
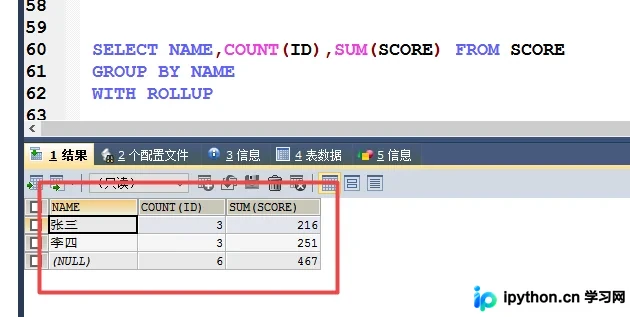
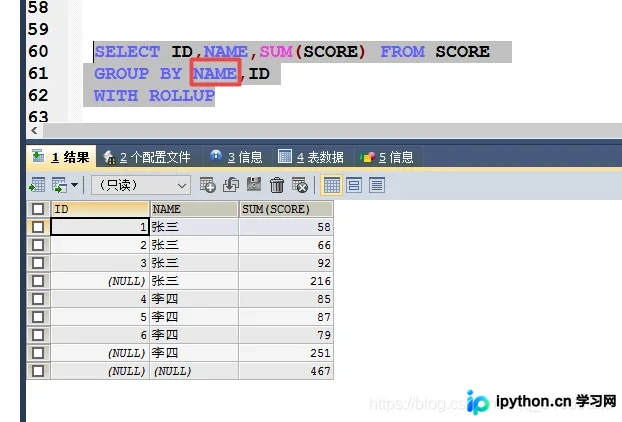
为了实现上述需求,可以在GROUP BY子句后添加WITH ROLLUP。这会将GROUP BY后的第一个字段作为聚合依据,计算其总和。
执行该查询后,结果集会多出一行,其中第一列为NULL,第二列为所有记录的总和。这是因为ROLLUP实际上生成了虚拟的“全量”分组,而该字段的值在无具体分类时为NULL。
第3步:清理汇总标识符(替换 NULL 值)
在前一步的结果中,汇总行的分类字段显示为NULL,这在报表展示时不够直观。我们可以使用IFNULL()函数将其替换为更具可读性的文本,如“Total”或“All”。
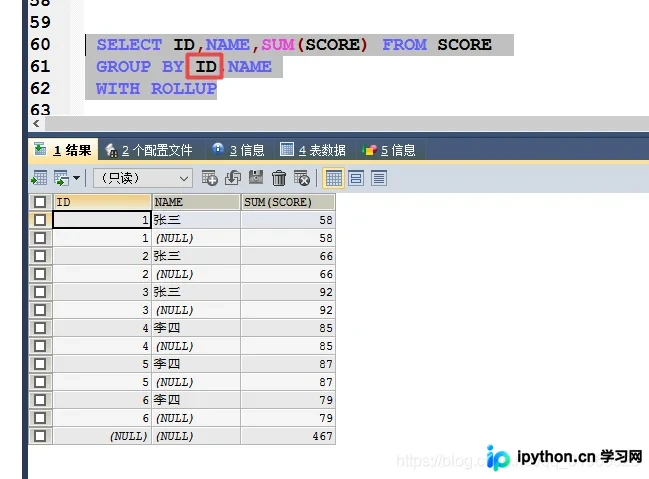
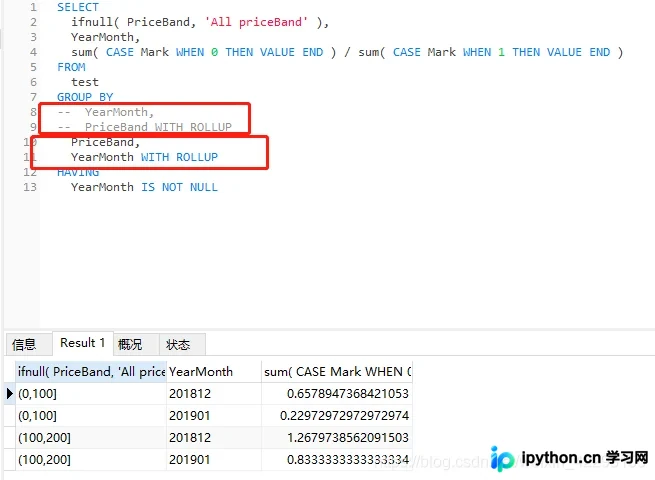
注意:WITH ROLLUP是对GROUP BY后的第一个字段进行逐层汇总。如果GROUP BY涉及多个字段,ROLLUP会从左向右逐级合并。
复杂场景示例:多条件聚合与 UNION ALL 替代方案对比
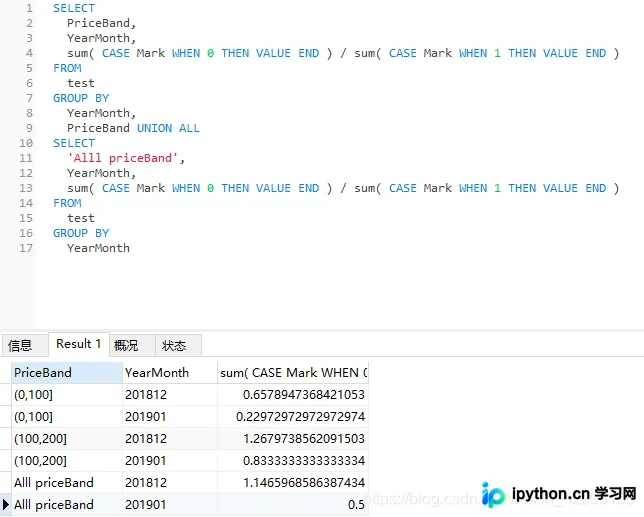
在处理更复杂的业务逻辑时,例如计算不同价格区间在不同月份的比率,传统方法可能需要使用UNION ALL拼接多个查询语句。
第4步:不使用 ROLLUP 的传统写法
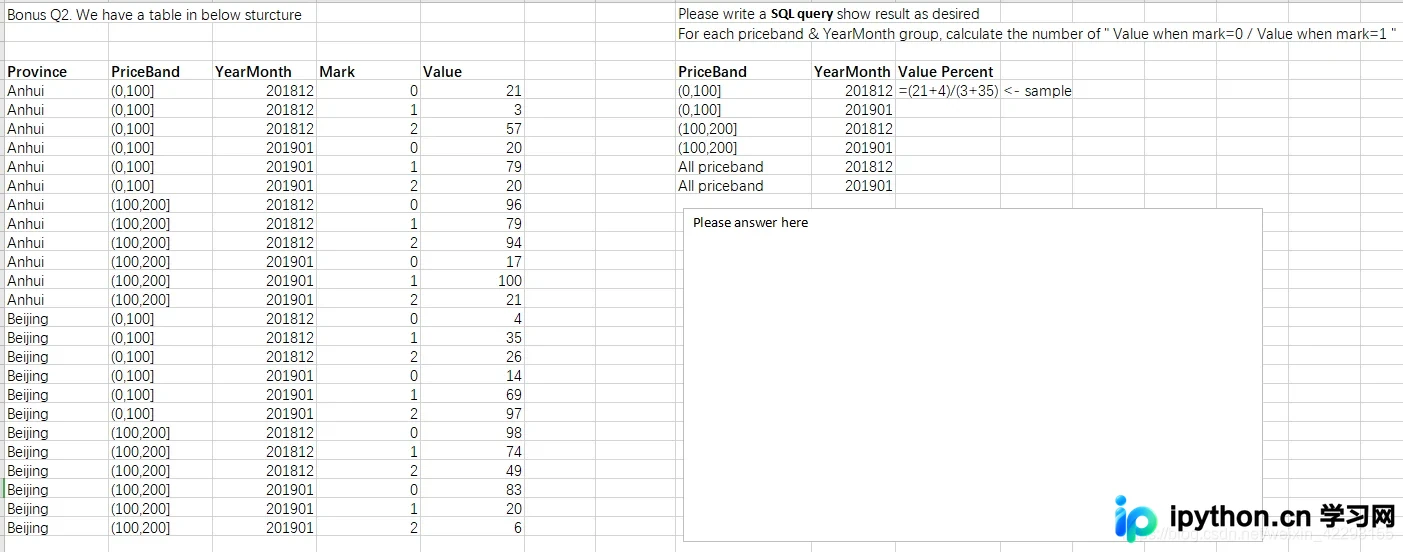
假设需要统计各价格区间、各月份内 mark=0 的总值与 mark=1 的总值之比,并要求最后输出所有价格区间的月度汇总。
常规做法是写出两遍类似的查询,并通过UNION ALL连接:第一遍按细节维度(价格区间、月份)分组,第二遍忽略价格区间,只按月分组。这种方法代码冗余且维护困难。
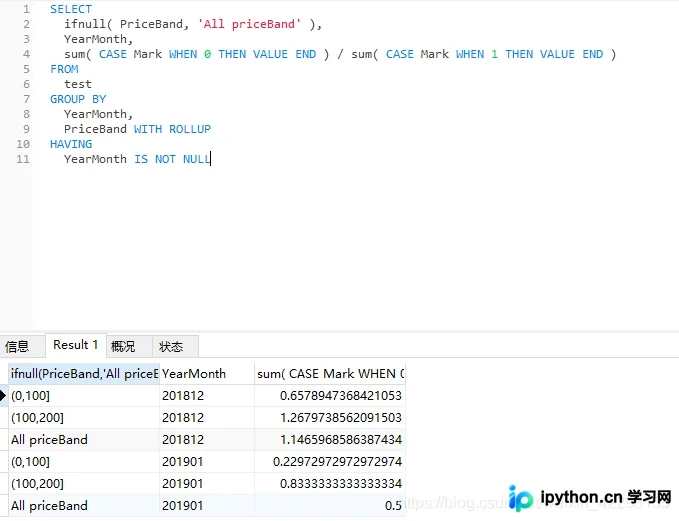
第5步:使用 ROLLUP 简化查询
利用WITH ROLLUP,可以将上述两个查询合并为一个:
SELECT
    IFNULL(PriceBand, 'All PriceBand'),
    YearMonth,
    SUM(CASE WHEN Mark = 0 THEN VALUE END) / SUM(CASE WHEN Mark = 1 THEN VALUE END)
FROM test
GROUP BY YearMonth, PriceBand WITH ROLLUP
HAVING YearMonth IS NOT NULL;
在此查询中:
GROUP BY YearMonth, PriceBand WITH ROLLUP:先按年月分组,再按价格区间分组,最后将价格区间合并为“所有价格区间”。IFNULL(PriceBand, 'All PriceBand'):将合并行中的PriceBand占位符NULL替换为特定字符串。HAVING YearMonth IS NOT NULL:过滤掉最顶层的全局汇总行(如果不需要全局总计,只关心按月的细项汇总时可用)。如果没有此限制,结果还会多出一行所有年份的总和。
这种写法显著减少了SQL代码量,且逻辑更加紧凑。执行结果清晰展示了各细分项及其对应的月度汇总:
核心概念辨析:WITH ROLLUP 与 CUBE 的区别
在许多数据库文档中,ROLLUP常与CUBE并列出现。两者虽然都用于多维分析,但在MySQL中的支持情况完全不同。
作用机制对比
- ROLLUP:具有层次性的聚合。如果有N个分组维度,它会产生 N+1 个聚合层级(从最小粒度到最大总纲)。例如
GROUP BY A, B WITH ROLLUP会生成 (A,B)、(A)、() 三种组合。 - CUBE:生成所有可能的维度组合。如果有N个分组维度,它会生成 2^N 种组合。例如
GROUP BY A, B WITH CUBE会生成 (A,B)、(A)、(B)、() 四种组合。
MySQL 的版本限制
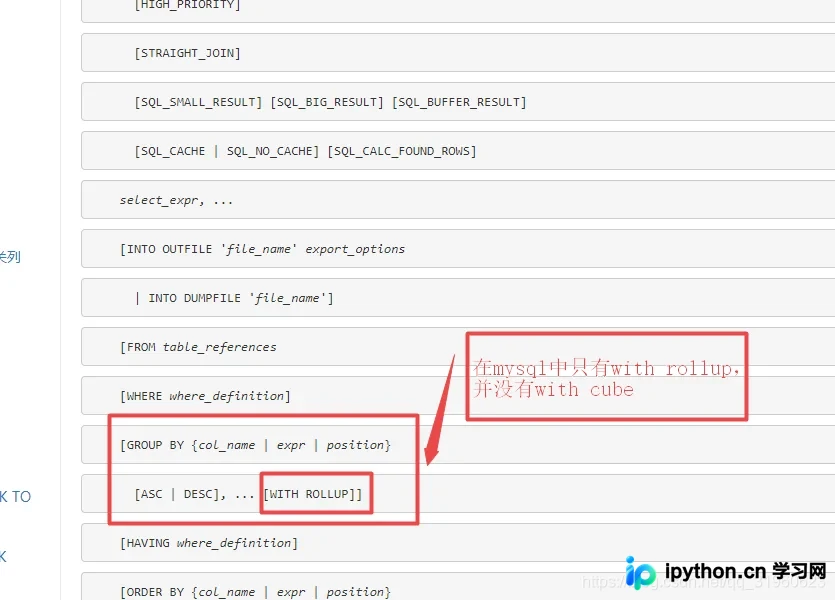
关键事实:MySQL 并不支持 CUBE 操作。
尽管在某些版本的语法定义中可能保留关键字,但执行时会报错或不被支持。MySQL 5.6.17 及以上版本明确限制了 Cube 的使用。因此,在实际开发中,只能在 MySQL 中使用 ROLLUP,无法像某些BI工具或Oracle数据库那样直接使用CUBE来实现全排列聚合。
完成判断与常见排错
1. 错误提示
如果在查询中同时使用了ORDER BY和ROLLUP,早期的MySQL版本(如5.7及部分早期8.0版本)可能会抛出错误:
Error Code: 1221. Incorrect usage of CUBE/ROLLUP and ORDER BY
这是因为排序顺序在聚合阶段尚未完全确定时存在逻辑冲突。虽然新版MySQL逐渐放宽了此限制,但在遇到此类错误时,建议移除ORDER BY或在外部子查询中进行排序,或者检查MySQL具体版本号是否已修复该Bug。
2. 位置规范
WITH ROLLUP必须紧跟在GROUP BY子句之后,不能插入到其他分组字段中间,例如GROUP BY A, B WITH ROLLUP, C是错误的写法。正确的逻辑是:GROUP BY定义的维度列表 + WITH ROLLUP。
简要总结
WITH ROLLUP是MySQL中实现分层统计的高效工具。它通过在GROUP BY基础上自动追加聚合行,避免了使用UNION ALL拼接数据的繁琐。使用时需注意用IFNULL处理汇总行的空值,并注意MySQL不支持CUBE操作以及ORDER BY兼容性问题。
以上就是MySQL中WITH ROLLUP的用法及说明的详细内,更多关于MySQL高级查询的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









