pip install jupyterlab 安装失败排查与 pywinpty 修复指南
在使用 pip install jupyterlab 安装深度学习交互式笔记本时,常因缺少 Rust 编译环境或依赖损坏导致构建失败。本文详细解析 pywinpty 包的底层依赖机制,并给出基于 conda 通道快速补全组件、绕过本地编译限制的标准操作步骤。
2026-10-11
25

在使用 pip install jupyterlab 安装深度学习交互式笔记本时,常因缺少 Rust 编译环境或依赖损坏导致构建失败。本文详细解析 pywinpty 包的底层依赖机制,并给出基于 conda 通道快速补全组件、绕过本地编译限制的标准操作步骤。
本文介绍如何使用pandas库将numpy数组高效保存为CSV文件。通过创建DataFrame对象并调用to_csv方法,可简化数据持久化过程。文章包含完整的代码示例,展示从数组生成到文件保存的具体操作及结果分析。
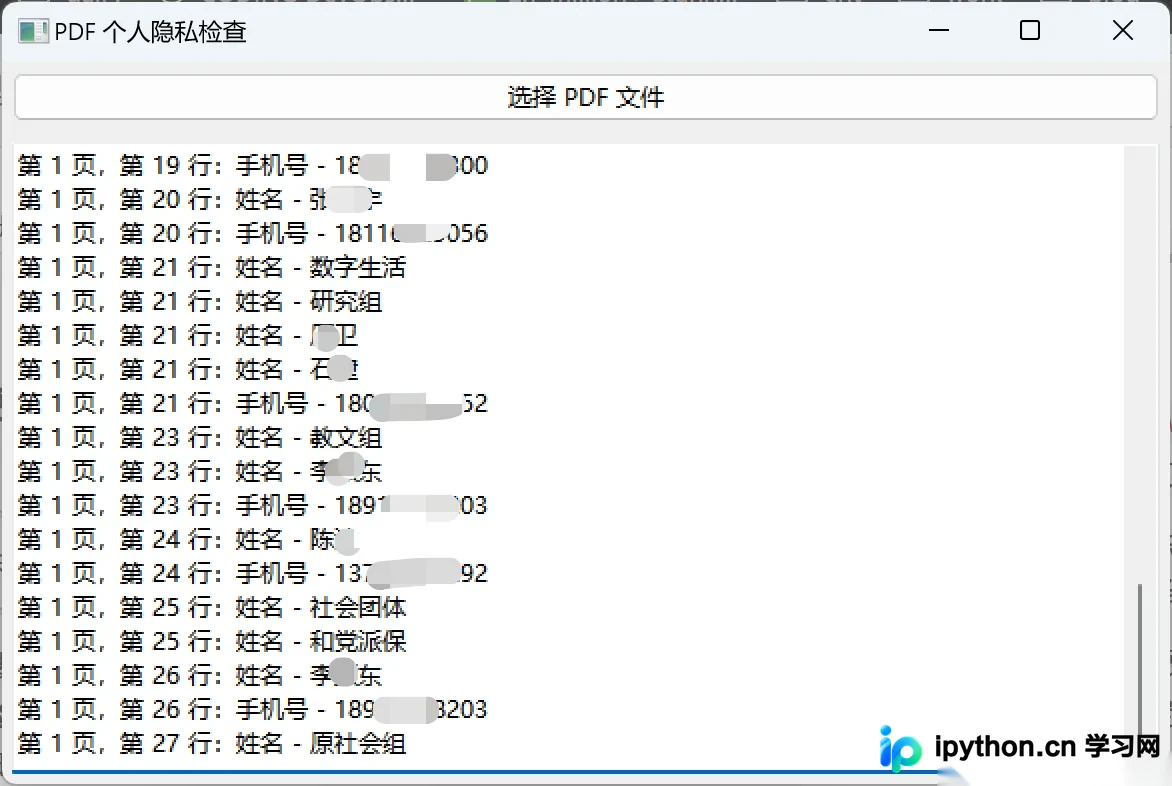
本文介绍使用Python结合pdfplumber库提取PDF文本,并配合正则表达式快速定位姓名、身份证号、手机号等敏感数据的方法。通过wxPython搭建桌面界面,输入文件后自动输出结果页码与行号,支持按需扩展检测规则,适用于日常文档脱敏审查。
本文介绍在 pandas 中处理小数位数与精度的两种常见场景:控制台打印显示与实际数据修改。通过 pd.set_option 控制显示格式,利用 DataFrame.round() 方法修改实际数值精度,支持全局、列名映射及 Series 指定方式。
本文介绍 Python 标准库 logging 模块的使用。通过定义主入口 logger 并配置处理器(文件与屏幕输出),子模块利用 getLogger 继承日志名(如 main.sub)自动获取父级配置。文章提供完整的代码示例,展示如何设置日志格式、处理级别及在模块间共享日志对象。
本文介绍在 Python 2.7.10 及以上版本中,如何解决自带 pip 版本滞后导致的下载缓慢问题。通过切换到安装目录并使用 python -m pip 命令升级 pip,以及多次尝试安装 requests 包,确保环境配置成功。
Python正则表达式中,非捕获组((?:...))专为逻辑分组设计,不保存匹配结果。通过对比普通捕获组,可直观掌握其语法特性。本文结合实际提取、交替匹配及性能基准测试代码,详细说明何时使用非捕获组以降低内存消耗并提升大规模文本处理速度。
本文详解Python中字典(dict)与JSON字符串及文件之间的相互转换。通过json模块的dumps、loads、dump和load方法,演示如何将字典转为JSON字符串、将JSON字符串解析为字典,以及如何将数据写入JSON文件并从文件中读取JSON数据。
本文详细解析Python中利用for循环实现九九乘法表的9种不同排列方式。通过调整内外层循环的range步长与边界,结合字符串格式化方法,实现正序、倒序、三角形及矩形等多种布局。文章提供完整代码示例与逻辑说明,帮助开发者深入理解循环嵌套与格式化输出的实际应用。
本文详解如何使用Python主流库处理PDF文件。涵盖PyPDF2执行合并拆分与加解密、pdfminer.six与PyMuPDF精准提取文档文本、ReportLab动态创建页面及嵌入图片。提供完整代码示例、依赖安装步骤与安全操作规范,助您快速掌握自动化文档处理全流程。
本文深入解析Python中property函数的用法,涵盖直接调用与装饰器两种实现方式。通过Rectangle类实例,详细演示如何规范访问、修改和删除类属性,帮助开发者掌握属性管理的最佳实践。
本文详细讲解如何在Django项目中配置多个应用共存。通过创建独立应用、配置根URL路由、管理静态与媒体文件,以及集成Jinja2模板引擎,实现模块化开发。