

深入理解Python中__dict__与dir()的区别及实例方法机制
本文深入探讨Python中__dict__与dir()的区别。__dict__仅存储实例私有属性,不包含类方法;而dir()返回对象所有可见属性,包括继承的方法。通过代码示例解析实例方法如何通过self参数与实例绑定,以及属性在__dict__中的动态变化。
2026-10-12
31

本文深入探讨Python中__dict__与dir()的区别。__dict__仅存储实例私有属性,不包含类方法;而dir()返回对象所有可见属性,包括继承的方法。通过代码示例解析实例方法如何通过self参数与实例绑定,以及属性在__dict__中的动态变化。
本文详解如何在Grasshopper中使用Python实现带原始索引追踪的Z字形空间点集排序。算法先按Y坐标结合容差进行分组,组内再按X坐标升序排列,最终输出重排后的点列与原序列索引映射,适用于参数化建模中的阵列排布与点位规划。
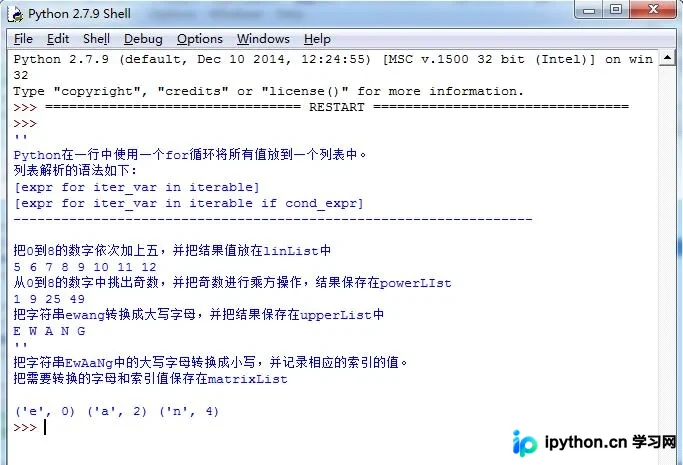
本文深入解析Python列表解析(List Comprehension)的高级用法,通过整数运算、字符串转换及矩阵处理三个具体案例,展示如何利用一行代码高效完成数据筛选与转换。内容涵盖基础语法、条件过滤及嵌套循环逻辑,帮助开发者提升代码简洁性与执行效率。
掌握Python文件读写的核心方法,可覆盖纯文本处理到CSV、JSON等结构化数据的日常开发需求。本文梳理了基于open函数的基础读取与写入操作,对比了全量读取与按行遍历的内存差异,并详解csv与json模块的标准用法,帮助开发者快速匹配不同场景的最佳实践。
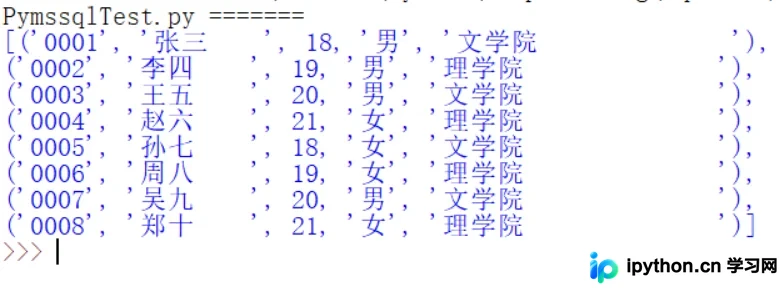
本文详细讲解如何使用Python3通过pymssql模块连接SQL Server数据库。内容涵盖环境安装、连接配置(含身份验证注意事项)、数据查询与插入的完整代码示例,以及基于类的数据库操作封装方法,帮助开发者快速掌握Python与SQL Server的交互技巧。
本文深入解析 Python 的垃圾回收机制,涵盖引用计数、标记-清除和分代收集三大核心策略。通过剖析 PyObject 结构体与 PyGC_Head 链表,详解如何处理循环引用问题。同时介绍对象池优化及分代回收算法,帮助开发者理解 Python 内存管理原理,优化程序性能。
针对Web开发与数据采集场景下的高频访问需求,本文详细演示如何使用Python结合asyncio与aiohttp库一次性发起100个HTTP并发请求。文章提供完整代码模板,解析会话复用、任务分发与结果收集原理,并补充异常捕获、并发控制与资源清理的最佳实践,帮助开发者快速搭建稳定高效的批量请求方案。
本文精选5道Python基础练习题,涵盖while与for循环、条件判断及逻辑求和。通过打印序列、计算总和、筛选奇偶数及实现简易登录功能,帮助初学者掌握核心语法与代码结构。
面对包含多个工作表的Excel文件,手动拆分极易漏改且耗时。本文介绍使用Python与pandas库编写自动化脚本,按Sheet名称逐个读取并导出为独立文件的操作流程,附带核心参数说明与运行排错指南,适用于日常数据处理与办公提效。
Python 中的 len() 是用于获取对象元素数量的内置函数,以 O(1) 时间复杂度直接读取对象的长度属性。它广泛支持字符串、列表、元组、字典及集合等内置序列与映射类型,同时可被 NumPy 数组和 pandas DataFrame 等第三方数据结构继承。本文将详细解析其运行原理、适用边界,并结合输入校验、循环控制与数据切分等实际编码场景提供标准化代码示例,帮助开发者高效调用并避免类型错误。
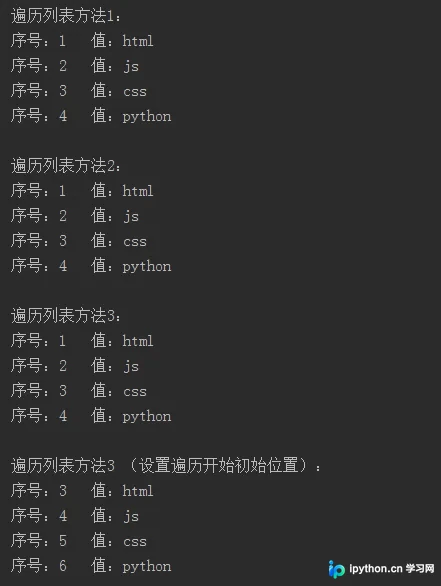
本文详解 Python 列表的三种遍历方式:通过 index() 获取索引、利用 range(len()) 控制下标,以及使用 enumerate() 同时获取索引与值。重点介绍 enumerate 的起始值设置,并提供完整代码示例与运行结果分析。
针对业务数据表中存在的分类标签重复、维护标准不一及缺失值干扰等问题,本文基于Python与Pandas库构建自动化字段清洗方案。通过字符串规范化、正则过滤、哈希索引去重与分块读取等核心操作,配合异常处理机制与模糊匹配扩展,提供从环境配置、脚本编写到结果验证的完整实践路径,有效替代人工排查,提升数据结构化质量。