

Grasshopper Python点集排序:带索引的Z字形排序算法实现

本文详解如何在Grasshopper中使用Python实现带原始索引追踪的Z字形空间点集排序。算法先按Y坐标结合容差进行分组,组内再按X坐标升序排列,最终输出重排后的点列与原序列索引映射,适用于参数化建模中的阵列排布与点位规划。
目标与输出说明
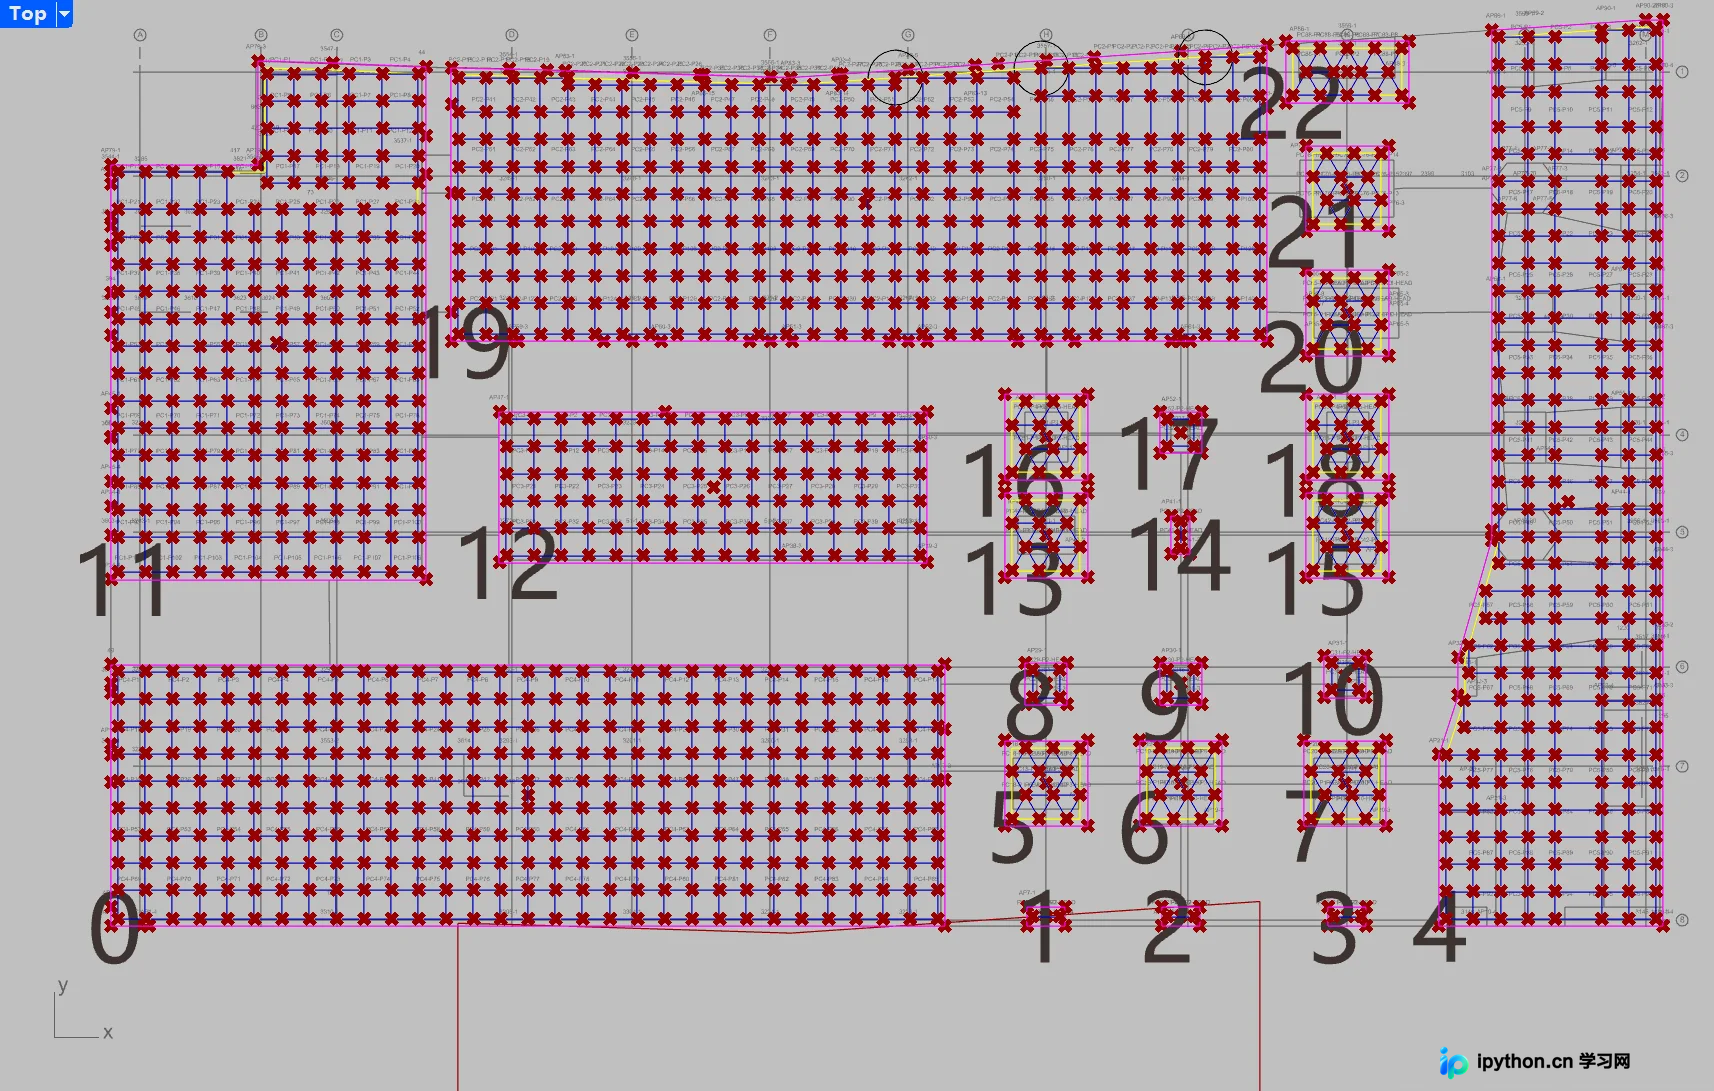
Z字形排序在三维空间处理中主要用于将分散的点列转化为规则的行列网格状输出。该脚本的核心目标是打破原始无序输入,按空间层次重新组织数据,并在变换过程中严格保留每个点的初始序列号,方便后续反向追踪或关联属性。运行后直接输出排序后的点集与对应的原始索引列表。
输入参数与运行环境
- 输入参数:
x:待处理的原始点集(Point List)t:Y轴方向分组容差阈值(Number),脚本默认设为 2000
- 输出参数:
a:完成Z字形排序后的新点集i:排序后各点所对应的原始序列索引
核心算法与完整代码
以下为可直接粘贴至Grasshopper Python节点的完整脚本。代码已修复原稿中存在的变量作用域断裂问题,并补充了完整的执行逻辑:
# 接收外部输入的点列表 x 与容差 t
points_with_index = list(enumerate(x))

def z_sort_points(pts, tol):
    # 整体按Y坐标升序打乱重排
    pts_y = sorted(pts, key=lambda pair: pair[1].Y)
    groups = []

    # 初始化当前分组
    current_group = [pts_y[0]]
    current_y = pts_y[0][1].Y

    # 遍历剩余点进行Y轴容差分组
    for p in pts_y[1:]:
        if abs(p[1].Y - current_y) <= tol:
            current_group.append(p)
        else:
            groups.append(current_group)
            current_group = [p]
            current_y = p[1].Y
    groups.append(current_group) # 追加最后一个分组

    # 组内按X排序,并同步提取点与索引
    sorted_pts = []
    sorted_idx = []
    for g in groups:
        g_x = sorted(g, key=lambda pair: pair[1].X)
        for idx, pt in g_x:
            sorted_pts.append(pt)
            sorted_idx.append(idx)

    return sorted_pts, sorted_idx

# 执行排序并赋给输出端
a, i = z_sort_points(points_with_index, t)
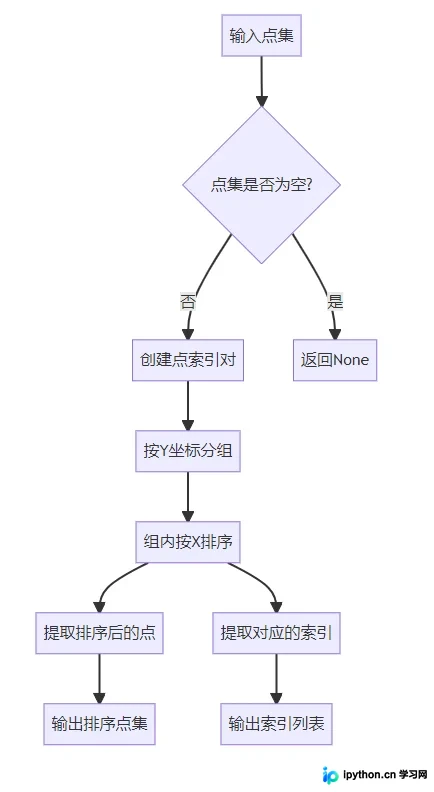
第1步:绑定原始索引并预处理数据
目的:防止排序过程中丢失点阵的初始位置信息。
入口:接收外部输入的 `x` 列表。
动作:调用 list(enumerate(x)) 生成 (原始索引, 点对象) 的元组对。后续所有排序操作均针对元组的第二项(点对象)进行坐标比较,而第一项(索引)作为附属数据跟随移动。
第2步:基于容差按Y坐标分组
目的:将空间高度相近的点归纳为同一行/层,形成Z字形排序的基础结构。
入口:传入已绑定的元组列表与容差值 t。
动作:先使用lambda表达式按Y坐标全局升序排列,随后遍历比对相邻点的Y差值。当差值小于等于容差时归入当前行;超出阈值则结束当前行记录并开启新行。此处需注意容差单位的物理意义,不同建模场景下数值差异较大。
第3步:组内按X排序并还原结果
目的:在同一水平行内完成从左到右的规则排列,最终展平数据供下游组件使用。
入口:第2步生成的分组列表。
动作:对每个子组内部再次调用排序逻辑,此时键函数切换为读取X坐标。遍历完所有分组后,利用元组拆包分别将点对象推入 a,索引推入 i,完成Z字形矩阵转换。
关键语法与数据结构解析
元组拆包与Lambda排序
脚本依赖Python内置的元组解构特性。例如 for idx, pt in g_x: 可直接将存储在一起的索引与点分离为独立变量,避免使用 pair[0] 或 pair[1] 带来的可读性损耗。配合 key=lambda pair: pair[1].X,能够以单行代码精确指定排序的比较基准,大幅提升遍历效率。
平行列表维护机制
为避免创建复杂的字典或类结构导致内存开销,本方案采用双列表并行追加策略(sorted_pts.append() 与 sorted_idx.append())。保持两个列表长度始终一致且索引一一对应,是Grasshopper数据流中最轻量、兼容性最高的状态保持方式。
常见问题与参数调整建议
- 排序错位或不连续:通常由于输入的容差阈值过小,导致本应属于同一行的点被拆分到了相邻组。可适当放大
t值,使同层点稳定落入同一批次。 - 空指针或越界报错:当输入点集为空(长度为0)时,直接访问
pts_y[0]会触发异常。在实际项目中建议在脚本顶部增加if not pts: return [], []的空值拦截判断。 - 坐标系方向影响:排序默认遵循屏幕坐标系(左到右为X正向,下到上为Y正向)。若绘图平面发生翻转,组内X排序方向可能呈现逆序,此时可将lambda比较符改为降序模式或提前对平面做镜像处理。
简要总结
通过绑定索引、Y轴容差分组、组内X轴排序三步操作,即可高效完成空间点集的Z字形重排。该方法无需依赖第三方几何库,仅凭基础数据结构与标准排序逻辑即可在Rhino环境中稳定运行,极大简化了阵列生成与数据回溯的开发成本。以上就是带索引的Z字形点集排序算法的详细内容,更多关于Grasshopper Python空间数据处理与参数化脚本开发资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









