

Python爬虫乱码处理实战:编码检测与转换技巧
本文探讨Python爬虫中常见的乱码问题,介绍如何利用chardet库自动检测网页编码,并通过unicode解码与encode编码将不同字符集(如Big5、GBK、EUC-JP)统一转换为UTF-8,确保数据顺利存入MySQL数据库。
2026-10-13
27

本文探讨Python爬虫中常见的乱码问题,介绍如何利用chardet库自动检测网页编码,并通过unicode解码与encode编码将不同字符集(如Big5、GBK、EUC-JP)统一转换为UTF-8,确保数据顺利存入MySQL数据库。
本文深入解析Python中常用的序列化工具,涵盖pickle、json及shelve模块。重点讲解如何在变量与文件中存储数据,以及如何处理自定义类的序列化与反序列化问题,包括使用default和object_hook参数解决JSON序列化报错,以及shelve模块的writeback机制,帮助开发者实现对象状态的持久化与恢复。
本文详细介绍如何使用Python脚本向微信公众号发送消息。相比Shell脚本,Python能更好地处理复杂格式和中文内容。文章涵盖获取Access Token、构造POST请求及发送消息的完整流程,并特别提示了2017年企业公众号迁移至企业微信后的接口调整注意事项,帮助开发者实现稳定的消息通知功能。
本文详细解析Python标准库urllib中urlopen()方法的使用。涵盖URL协议规范(http/ftp/file)、代理服务器配置技巧,以及通过data参数传递字典数据的方法。结合源码分析,说明Python 2.3后支持的代理功能及文件对象行为,帮助开发者掌握基础网络抓取与高级请求配置。
本文解析学习Python的七大理由:语法简洁易上手,代码高效构建功能,应用场景广泛覆盖Web与基础设施,拥有PyPI庞大库支持,在数据科学领域需求超越R语言,跨平台开源且灵活兼容多种语言实现。适合各阶段开发者掌握这一高价值技能。
本文详细介绍在Python中如何使用pymysql和redis模块连接并操作MySQL及Redis数据库。涵盖模块安装验证、MySQL的增删改查及游标控制,以及Redis中String和Hash类型的Set、Get、Delete操作。提供完整代码示例,包括连接配置、事务提交及异常处理,帮助开发者快速掌握数据库交互核心方法。
本文详细解析C++中引用(Reference)与const关键字的核心概念。通过别名机制理解引用的初始化与唯一性,掌握常引用防止修改数据的特性,以及常量指针在参数传递中的作用,帮助开发者写出更安全、高效的C++代码。
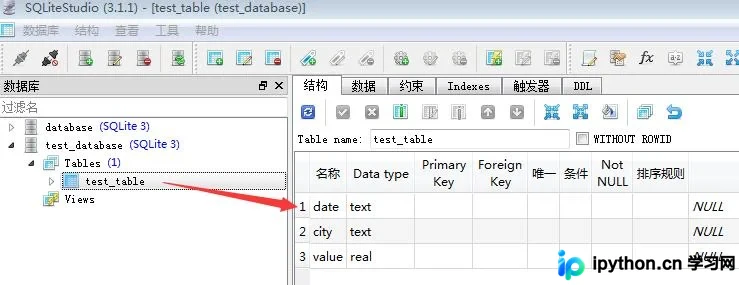
本文详细介绍如何使用Python标准库sqlite3创建和操作SQLite数据库,并通过pandas库高效读取数据。涵盖从建立连接、建表插入数据到使用read_sql_query获取DataFrame的完整流程,解决大数据量处理效率问题,附带可视化工具推荐。
本文深入解析Python作为强类型动态脚本语言的核心特性。详细阐述强类型禁止隐式类型转换、动态类型在运行时确定变量类型的机制,并对比静态与动态、强与弱类型语言在内存分配、编译检查及开发效率上的差异,帮助开发者准确理解Python的类型安全与灵活性。
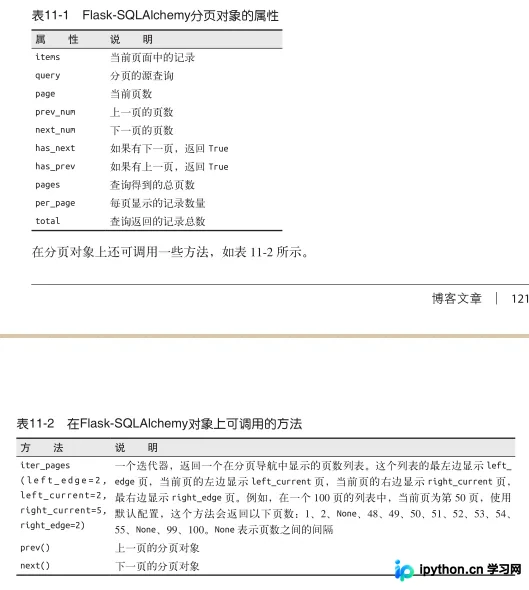
本文介绍如何在Python Flask框架中实现数据分页功能。通过Post.query.order_by(Post.publish_date.desc()).paginate(page, per_page=10,error_out=False)获取分页数据,并在模板中使用macros.html进行展示。文章详细讲解了分页逻辑、模板引用及循环处理,帮助开发者提升Web应用的数据展示效率。
本文详细介绍Python中实现字符串逆序输出的几种常用方法,包括利用索引切片、列表反转以及奇偶位字符提取。同时深入解析了Python中变量覆盖导致isinstance()报错的常见陷阱,强调规范命名的重要性,帮助开发者避免潜在的程序错误。
本文详细解析在 Flask 框架下如何处理文章与分类的多对多关系。通过定义中间关联表 post_class,利用 SQLAlchemy 的 secondary 参数建立双向引用,并演示如何通过分类对象直接获取其下的所有文章列表。