C#代码实现延时的四种常用方法
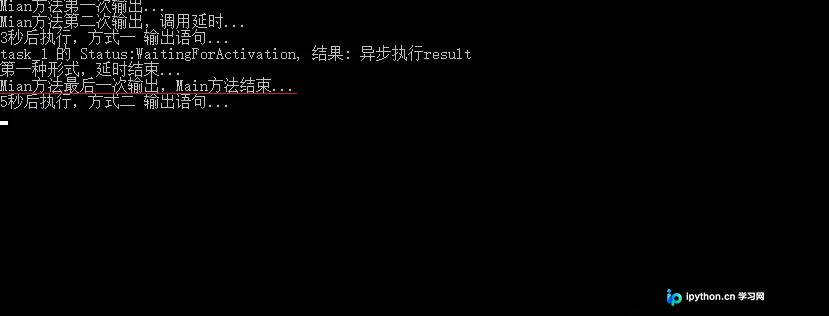
本文介绍在C#中实现代码延时的四种常用方法:通过Task.Delay进行异步等待、使用Thread.Sleep阻塞主线程、手动循环比对时间戳,以及结合定时器逻辑。详细列出各方法的代码示例及执行效果,帮助开发者根据同步或异步需求选择合适的延时方案。
2026-10-16
11

本文介绍在C#中实现代码延时的四种常用方法:通过Task.Delay进行异步等待、使用Thread.Sleep阻塞主线程、手动循环比对时间戳,以及结合定时器逻辑。详细列出各方法的代码示例及执行效果,帮助开发者根据同步或异步需求选择合适的延时方案。
本文总结了Java中将对象转换为String的四种常用方式:调用对象的toString()方法、强制类型转换(String)obj、使用String.valueOf()以及字符串拼接“”+obj。重点分析了各方法在处理null值和非法类型时的行为差异,特别是String.valueOf()和拼接法会将null转为字符串“null”而非抛出异常,这在实际开发中易引发逻辑错误,建议根据场景选择合适方法并做好判空检查。
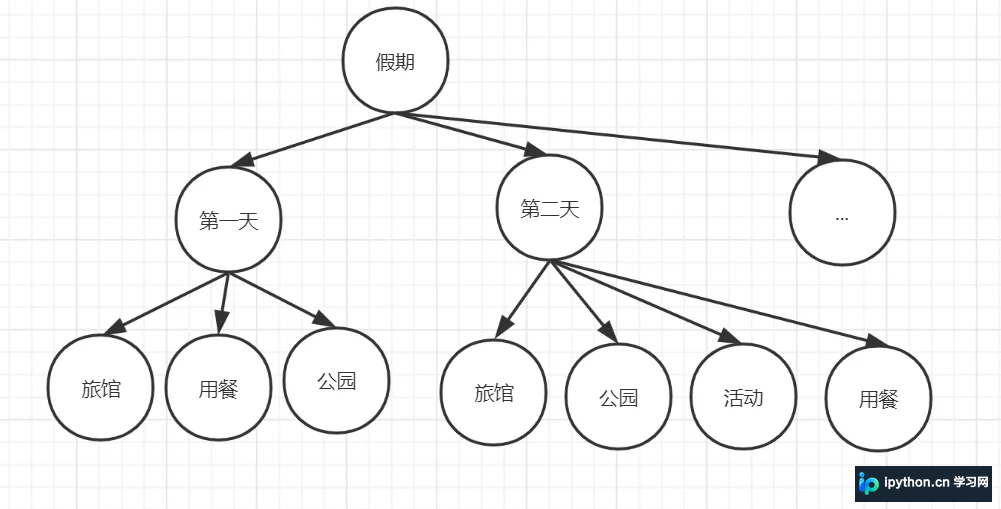
本文深入解析C#中的两种常用设计模式:生成器模式与责任链模式。通过构建度假计划和邮件处理的实际案例,详细展示了如何利用生成器模式分步构造复杂对象以封装创建过程,以及如何通过责任链模式解耦请求发送者与接收者,实现链式处理逻辑。文章附带完整类图说明与可运行的C#代码示例,帮助开发者掌握这两种模式在复杂业务场景中的具体应用。
本文深入解析Java SE 1.5引入的泛型机制。通过参数化类型,泛型在类、方法和接口中实现编译时类型检查,消除强制转换隐患并提升代码安全性。文章详细演示了泛型类的声明格式、泛型方法的调用优势及泛型接口的实现规范,帮助开发者掌握构建通用、可复用组件的核心技巧。
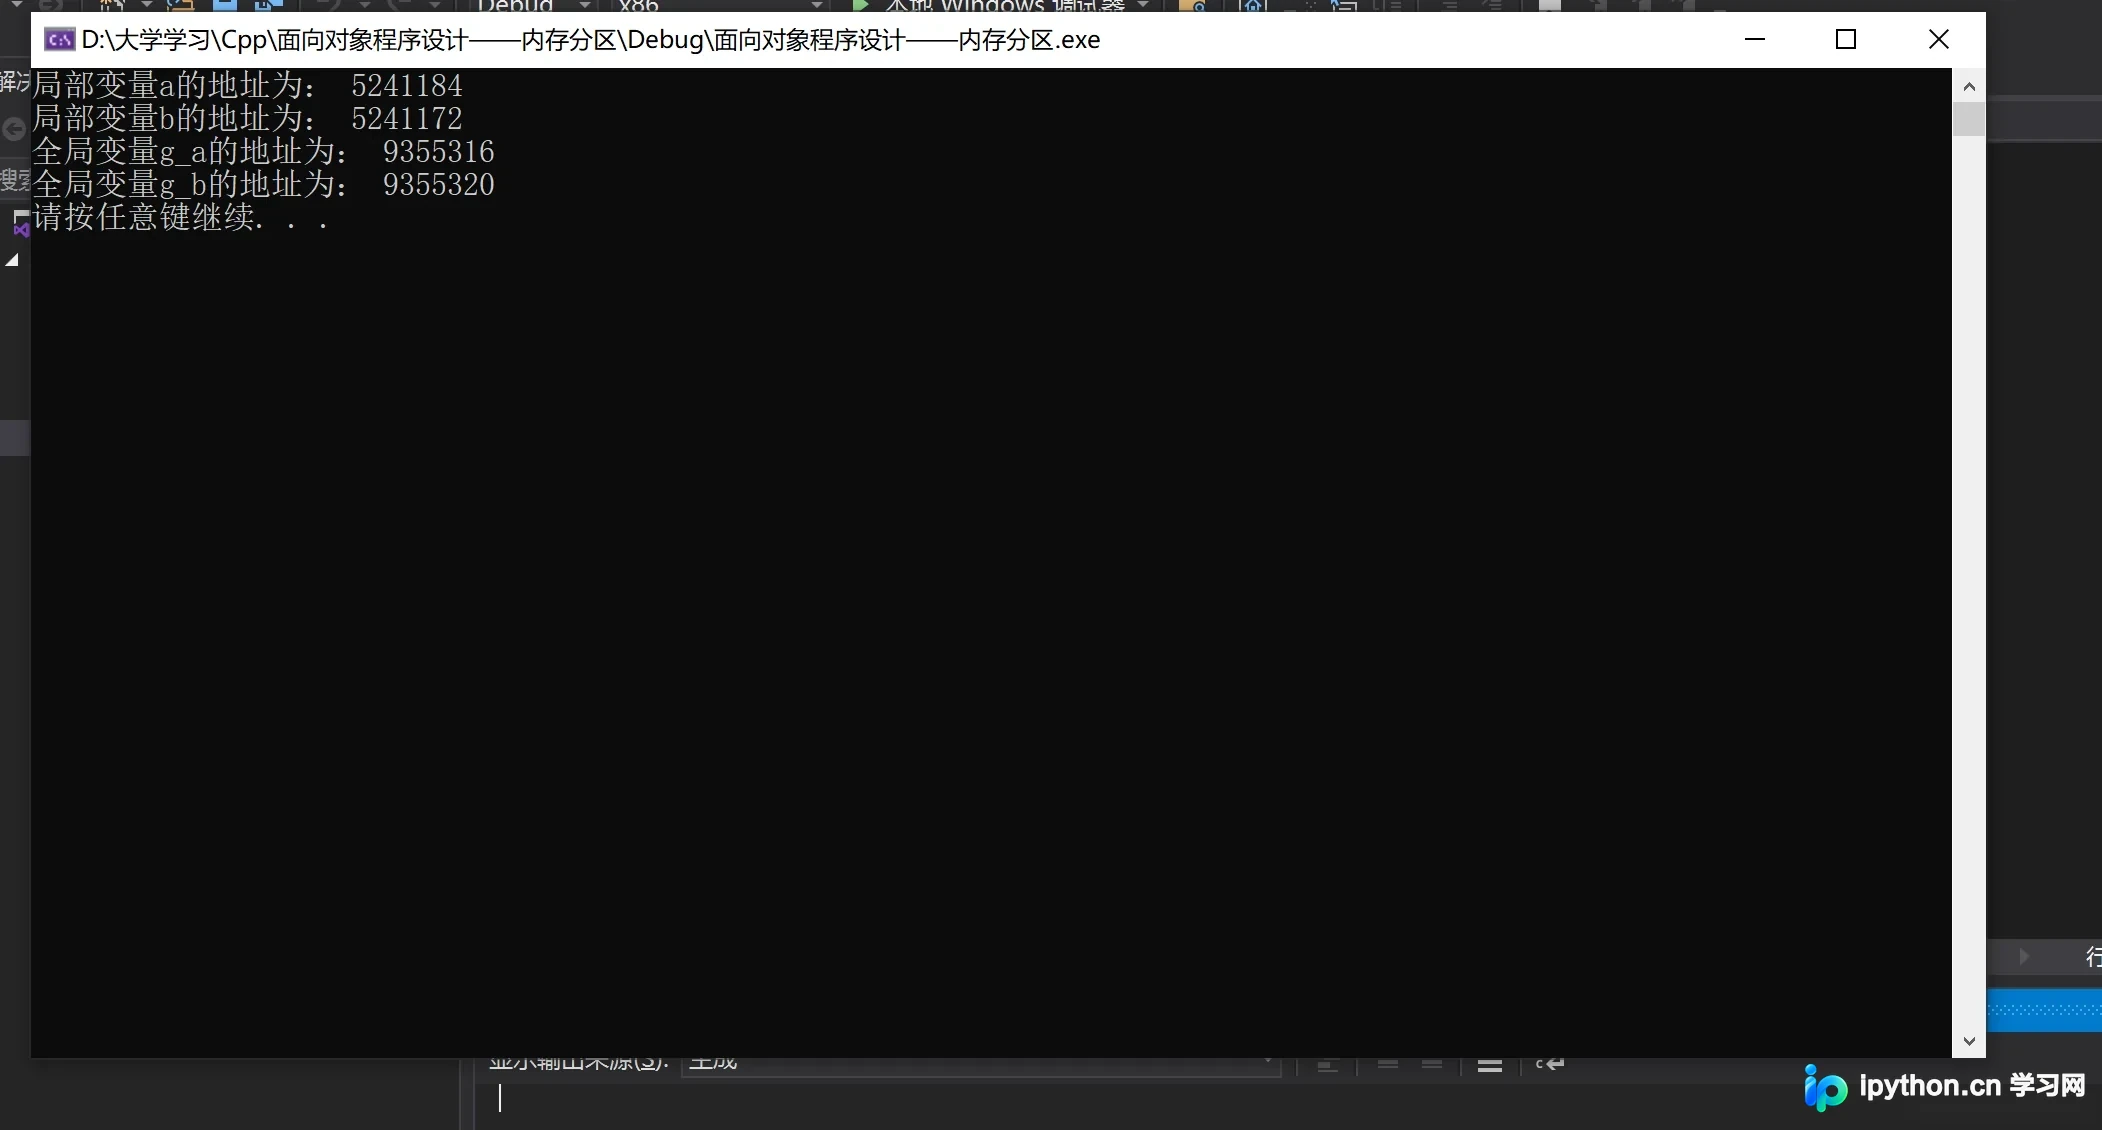
本文深入解析 C++ 程序的内存布局,详细阐述代码区、全局区、栈区和堆区的定义、特点及数据来源。通过对比局部变量与全局变量的地址分布,演示 const 常量的存储位置,并重点说明栈区自动释放与堆区手动 new 分配的机制差异,帮助开发者理解数据生命周期以避免内存错误。
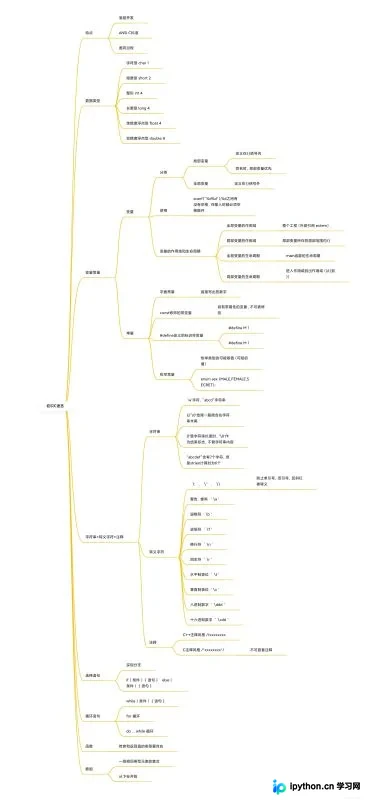
本文详细梳理C语言作为面向过程编程语言的基础知识,涵盖ANSI标准特性、六种基本数据类型及其大小计算、局部与全局变量的生命周期及作用域差异、字符串与转义字符处理规则,以及选择循环语句、函数传参和数组索引的使用逻辑。附带主流编译器列表及代码示例,帮助初学者快速建立核心概念框架。
本文深入解析MySQL触发器在数据库管理中的实际应用,以学校数据库(School)为例,演示如何创建BEFORE INSERT/UPDATE触发器。重点解决成绩范围(0-100)校验、学分上限(30分)控制、不及格记录保护、默认年龄填充以及自动计算学生平均成绩与等级评定等需求,确保数据的实时一致性与业务逻辑的自动化执行。
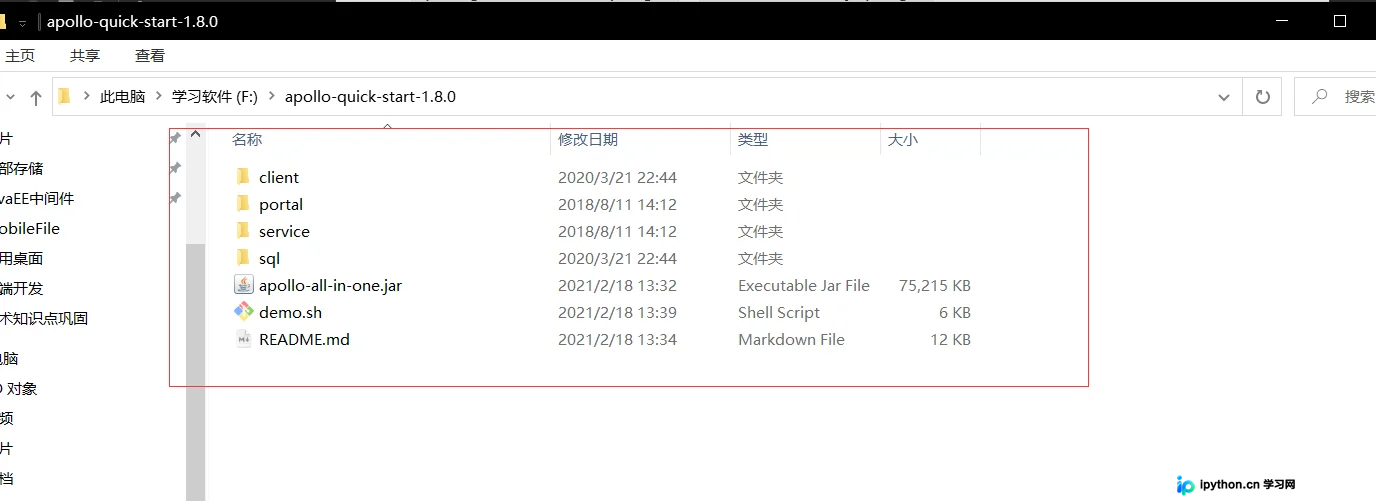
本文详细讲解如何从零搭建 Apollo 配置中心本地开发环境,包括数据库初始化、Quick Start 包打包启动及端口配置。同时演示如何将 Apollo 集成至 Spring Boot 项目,通过修改 pom.xml 引入 apollo-client 依赖,并配置 application.yml 实现配置的动态加载与管理,帮助开发者快速掌握分布式配置中心的搭建与应用。
本文详解PHP中array_pad()函数的使用方法。该函数用于将指定值插入数组以达到指定长度。核心规则在于第二个参数$size的正负号决定填充位置:正值在尾部追加,负值在头部插入;若绝对值小于原数组长度则不进行操作。文章提供多组代码实例与结果演示,帮助开发者快速掌握数组补齐技巧。
本文介绍C#中Span结构的特性及其在字符串处理中的性能优势。通过对比传统String拼接方式,展示利用span和String.Create实现敏感信息掩码的方法。测试结果显示,该方法能显著降低内存分配,提升执行效率,适用于需要高性能文本处理的场景。
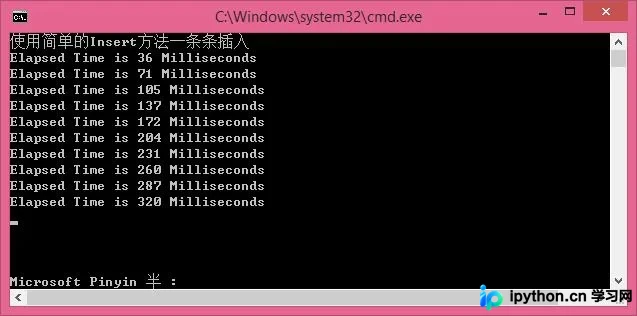
针对SQL Server中大量数据导入需求,传统单条INSERT效率低下。本文通过C#代码实证对比三种方法:普通循环插入、SqlBulkCopy批量复制及表值参数(TVP)。重点详解Bulk与TVP的配置步骤、代码实现及性能差异,提供从建库、定义类型到执行插入的完整流程,帮助开发者在高并发场景下选择最优数据写入策略。
本文详解C++中二叉树的两个核心操作:计算直径与合并二叉树。通过递归遍历获取左右子树深度,计算经过根节点的最大路径和来求解直径;对于合并操作,采用递归方式将重叠节点值相加,非空节点直接保留,从而构建新的合并二叉树。