

SQL Server 参数化 SQL 的 Parameter Sniff 问题与优化方案
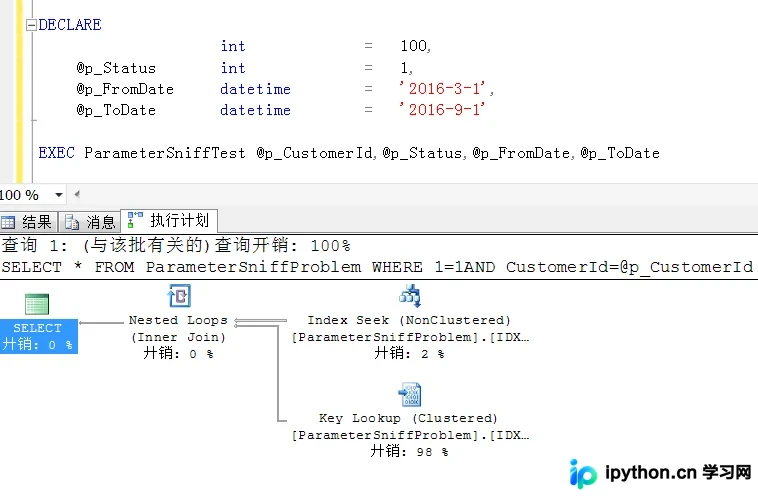
在 SQL Server 中,数据分布不均常导致参数化存储过程产生 Parameter Sniff(参数嗅探)现象,即错误的执行计划被重用。本文通过模拟测试展示了该问题的成因及表现,并提供了一种针对高风险参数的“混合参数化”解决方案:对易引发数据倾斜的参数直接使用字符串拼接以触发按需重编译,其余条件保持参数化以复用执行计划,从而在避免极端性能下降的同时平衡缓存效率。
2026-10-13
24

在 SQL Server 中,数据分布不均常导致参数化存储过程产生 Parameter Sniff(参数嗅探)现象,即错误的执行计划被重用。本文通过模拟测试展示了该问题的成因及表现,并提供了一种针对高风险参数的“混合参数化”解决方案:对易引发数据倾斜的参数直接使用字符串拼接以触发按需重编译,其余条件保持参数化以复用执行计划,从而在避免极端性能下降的同时平衡缓存效率。
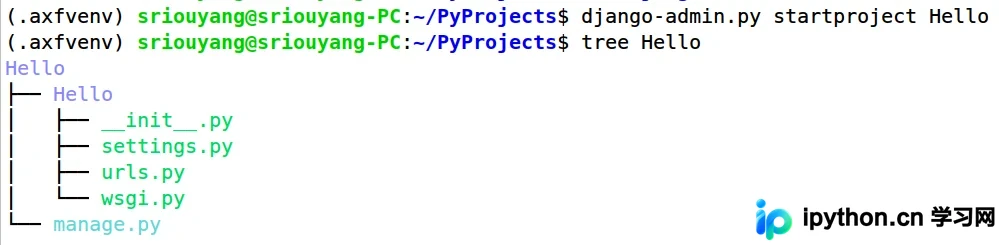
本文详细介绍如何使用Django框架从零开始创建HelloDjango项目。内容涵盖虚拟环境配置、MTV架构各文件作用、子应用创建与注册、数据模型定义、数据库迁移、静态资源配置及路由映射。通过完整代码示例,帮助开发者快速掌握Django核心功能并运行测试。
本文详细介绍如何使用Python的正则表达式(re模块)来匹配和提取IPv4及IPv6地址。内容涵盖简单与精确的IP验证方法,以及从长文本中高效提取IP地址的技巧,并提供完整的代码示例供参考。
本文介绍在数据已存在的情况下,如何安全地动态修改MySQL表中VARCHAR字段的长度。通过ALTER TABLE语句实现扩展,同时深入解析VARCHAR的最大容量限制,特别是UTF-8编码下汉字存储的字节计算逻辑,帮助开发者避免字符截断问题。
本文深入解析Python中的递归函数,通过基础求和与嵌套列表处理两个实例,展示递归在遍历未知结构时的优势。文章详细解释了递归出口、局部作用域及调用栈机制,并对比了递归与循环的实现逻辑,帮助读者掌握递归的核心概念与应用场景。
本文深入解析Python中re模块的核心功能,涵盖findall、search、match等查找方法的使用场景与返回值差异,以及split、sub、subn等字符串处理技巧。同时介绍compile编译优化与finditer迭代器节省内存的高级用法,帮助开发者高效处理文本匹配任务。
本文介绍使用Python处理常见Key-Value格式配置文件比对与合并的方法。针对Linux diff工具在复杂配置场景下的局限性,提供自定义脚本实现新增配置项的自动提取与追加。代码演示如何解析配置文件、过滤注释行,并将新文件中的差异配置项安全地合并至旧文件,适用于版本发布时的配置同步场景。
小程序云开发官方开放HTTP API,允许外部服务器通过标准HTTP请求访问云资源。本文以Python为例,演示如何获取Access Token,并调用接口对云数据库进行集合与数据的增、删、改、查操作,帮助开发者利用熟悉语言构建小程序后台应用。
本文详解Python3的自动内存管理机制。核心在于引用计数,通过计数器追踪对象引用数,归零即回收。然而,循环引用会导致引用计数无法归零,引发内存泄漏。Python通过引入标记-清除算法解决循环引用问题,并结合分代回收机制优化性能,确保内存高效利用。
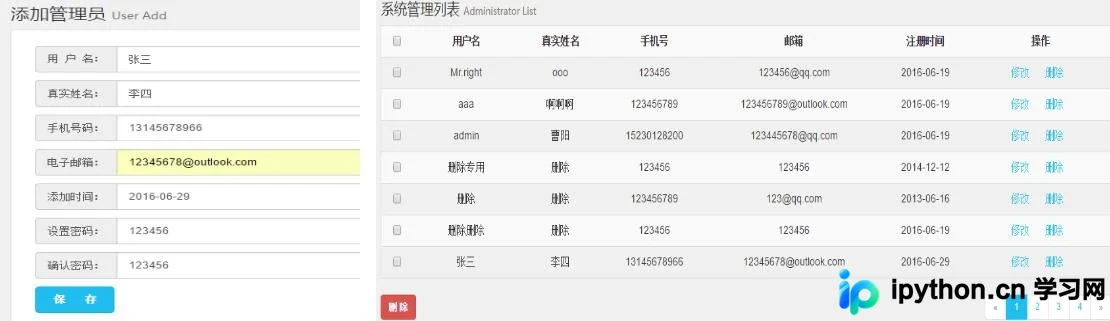
本文详细介绍使用ThinkPHP框架实现向数据库添加用户信息并在网页展示的全过程。涵盖基于MVC模式的视图表单设计、模型自动验证规则配置及控制器逻辑处理,帮助开发者快速掌握核心开发流程。
本文介绍如何在Django项目中利用Celery的Solo模式处理耗时且需串行的异步任务。通过配置Redis作为消息代理,并设置worker为solo模式,确保任务按序执行且不并发。文章涵盖环境安装、Celery应用创建、Django集成及日志配置,解决高负载下任务漏执行或并行冲突问题。
本文系统讲解Python中Lambda匿名函数、sorted排序、filter过滤、map映射四大高阶函数的语法与实战应用,深入解析递归调用的原理、限制及在遍历树形结构中的应用,并详细对比常规循环与递归两种二分查找算法的实现细节与性能特点,帮助开发者掌握高效数据处理与算法优化技巧。