

Python高效处理超大二进制浮点数据:从struct解析到split切割
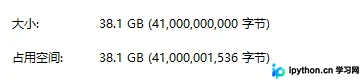
本文详解Python中利用struct包将二进制文件转换为浮点数的方法。针对小文件,演示一次性读取并reshape为矩阵;针对38.1G超大文件,提出结合Linux split命令按大小切割文件,再通过Python循环逐块使用struct.unpack解析并保存为.npy格式的高效处理方案,解决内存溢出问题。
2026-10-13
21

本文详解Python中利用struct包将二进制文件转换为浮点数的方法。针对小文件,演示一次性读取并reshape为矩阵;针对38.1G超大文件,提出结合Linux split命令按大小切割文件,再通过Python循环逐块使用struct.unpack解析并保存为.npy格式的高效处理方案,解决内存溢出问题。
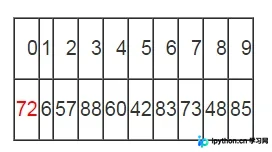
本文详解快速排序的核心思想,包括分治策略与“挖坑填数”的具体操作步骤。通过图解展示基准值选择、左右分区过程及递归逻辑,并提供完整的C#代码实现,帮助开发者掌握高效排序算法的原理与应用。
本文使用Python和Jupyter Notebook模拟时时彩尾号玩法,对比完全随机购买与基于前N期出现频率选择最小概率数字两种策略的长期胜率。通过10000次模拟实验,结果显示后者虽在统计上略微提升胜率,但无法改变期望值为负的数学本质。文章强调理性看待概率,珍爱生命,远离黄赌毒。

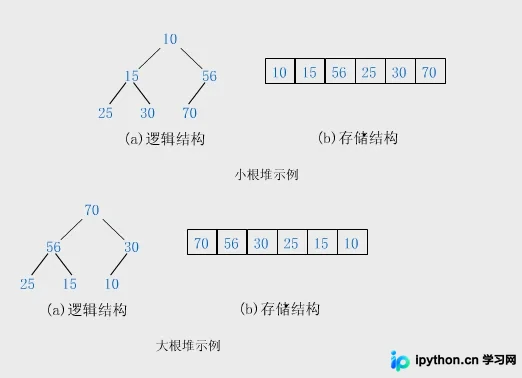
堆排序是一种利用二叉堆数据结构实现的比较排序算法。本文详细解析最大堆的定义、建堆过程及核心交换逻辑,并提供完整的C++代码示例。通过分析 max_heapify 与 build_max_heap函数的执行机制,阐明堆排序始终保持在 O(nlogn) 的时间复杂度及其 O(1) 的空间优势,适用于对稳定性无要求的高效率场景。
本文详细介绍Python中PIL库的安装方法,涵盖Linux、Mac及Windows平台的具体操作步骤。重点演示如何使用Pillow库进行图像缩放,提供从打开图片到保存缩略图的完整代码示例,解决常见安装报错问题。
本文深入解析Python中元类(Metaclass)的概念与工作原理。通过剖析type内置元类的行为,阐述__metaclass__属性的查找机制,并演示如何自定义元类以在类创建阶段自动修改属性。文章涵盖__new__与__init__方法的钩子使用,帮助开发者掌握Python面向对象的高级特性。
本文详细介绍了在C#/.NET环境中通过代码创建Excel和Access文件的主流方法。针对Excel,提供了基于OLEDB的轻量级创建法、纯文本制表符分隔法以及基于Excel COM对象的完整控制法;针对Access数据库,讲解了利用ADOX组件进行DDL操作以创建库、表及定义字段属性的实现步骤。内容涵盖连接字符串配置、关键API调用及注意事项。
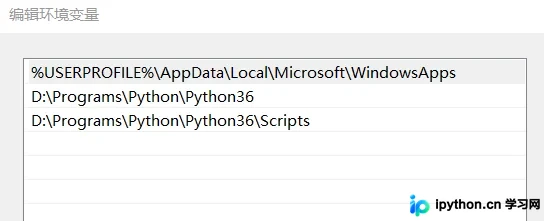
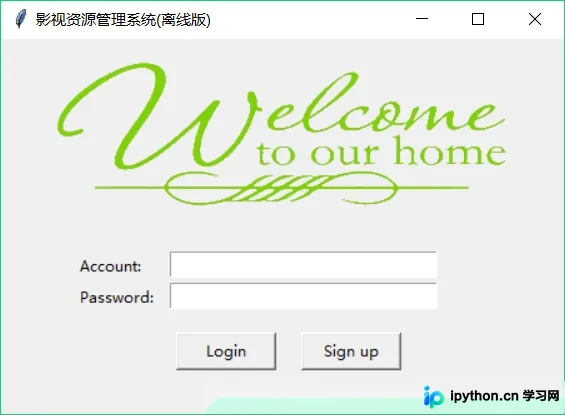
本文详细介绍如何使用Python3.6.5及内置Tkinter库开发图形化登录界面。内容涵盖环境配置、窗口创建、组件布局(Label、Entry、Button)及事件响应机制,并提供完整的代码示例与效果展示,适合Python初学者快速上手GUI开发。
本文详解在Python中如何在一个.py文件中调用另一个.py文件内的函数。针对同目录场景,介绍了直接import和from...import两种写法;针对跨目录场景,讲解了通过sys.path添加路径及使用imp模块加载源文件的方法。内容涵盖具体代码示例与注意事项,帮助开发者解决模块引用问题。
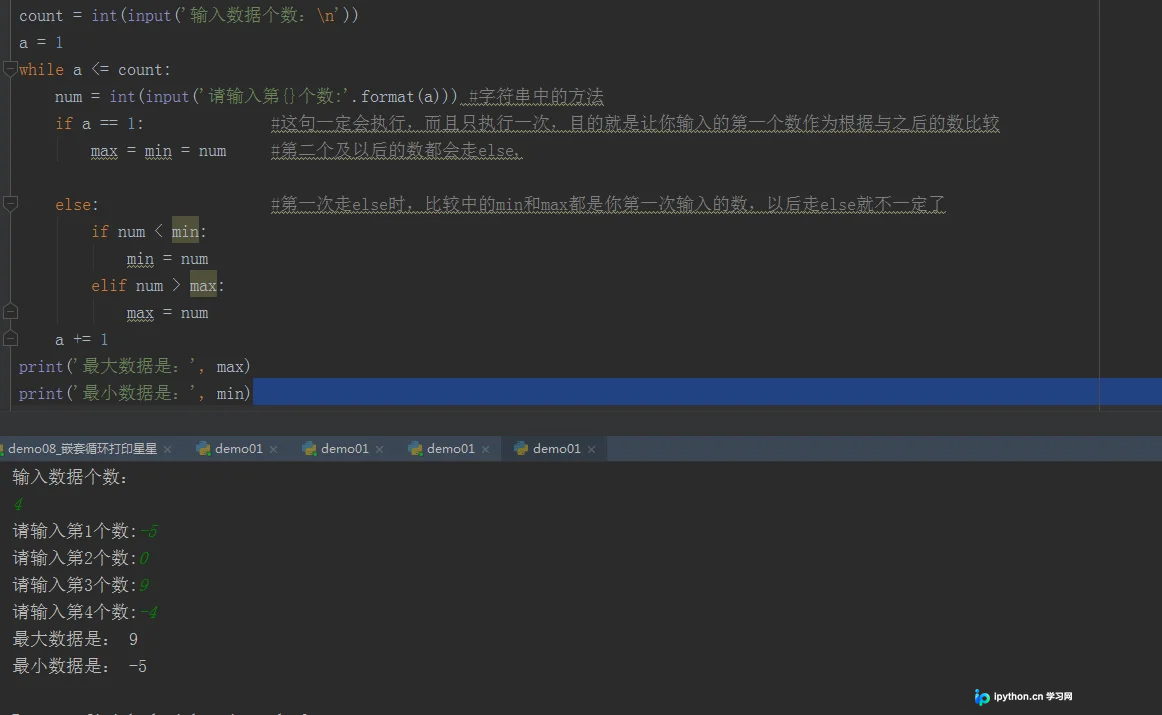
本文总结了Python中获取最大值和最小值的两种常见方法。第一种通过循环逐个比较输入数据,无需额外存储;第二种将所有数据存入列表后直接调用内置函数。两种方法均包含完整代码示例,适用于不同场景下的极值计算需求。
本文深入解析Python中单例模式的实现原理,重点区分__new__构造方法与__init__初始化函数的执行顺序与作用。通过代码示例展示如何利用__new__控制实例创建,确保类仅被实例化一次,并详细阐述类方法、元类编程中__new__的应用场景及与__init__的配合机制。
本文详细介绍Python中requests库的安装方法及基本使用。作为比urllib更简洁的第三方HTTP库,requests支持GET、POST等多种请求方式。文章通过具体代码示例,演示了如何发起基础请求、处理带参数URL、解析JSON响应以及上传文件,帮助开发者快速掌握网络交互的核心技能。