

图解堆排序原理:基于最大堆的C++实现与性能分析

堆排序通过构建最大堆并利用元素交换实现有序排列。本文深入解析最大堆的结构性质、自底向上建堆策略以及关键节点下沉机制,配合C++完整代码展示从建立堆到逐个取出最大值的全过程。无论最好或最坏情况,该算法均稳定保持 O(nlogn) 的时间复杂度,且无需额外内存空间。
堆排序的基本定义与核心概念
堆排序(Heap Sort)依赖于一种特殊的完全二叉树结构——堆。将 n 个关键字序列 K1, K2, …, Kn 视为完全二叉树的存储结构时,需满足以下堆性质之一:
- 小根堆(最小堆): 对于任意非叶子结点 i,满足 Ki ≤ K2i 且 Ki ≤ K2i+1(若子节点存在)。此时堆顶元素为整个序列的最小值。
- 大根堆(最大堆): 对于任意非叶子结点 i,满足 Ki ≥ K2i 且 Ki ≥ K2i+1(若子节点存在)。此时堆顶元素为整个序列的最大值。
例如,序列 (10, 15, 56, 25, 30, 70) 构成一个最小堆,而 (70, 56, 30, 25, 15, 10) 则构成一个最大堆。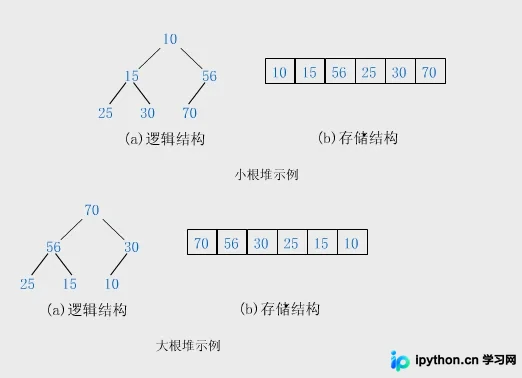 图中直观展示了这两种堆形态下父节点与子节点的大小关系。
重要性质:堆中的任一子树本身也必须是一个堆;上述讨论主要针对二叉堆,类似逻辑可扩展至多叉堆。
堆排序的执行流程
基于最大堆的堆排序主要包含以下步骤:
- 构建最大堆: 将待排序数组调整为满足最大堆性质的完全二叉树结构。
- 提取最大值: 交换堆顶元素(当前最大值)与数组末尾元素,此时最大值已就位。
- 调整堆结构: 忽略已排好序的末尾元素,对剩余的 n-1 个元素重新调用维护堆的函数,使剩余部分再次成为最大堆。
- 重复操作: 持续交换堆顶与当前未排序部分的末尾元素并调整,直至所有元素有序。
在代码实现中,第2步和第3步通常通过索引交换完成,无需真正“取出”节点。理解这一过程需掌握以下结论:
- 若数组下标从 0 开始,节点 i 的左子节点为 2i+1,右子节点为 2(i+1)。
- 大小为 n 的数组中,第一个叶子节点的下标为 ⌊n/2⌋,最后一个非叶子节点下标为 ⌊n/2⌋-1。
- 最大堆的根节点 A[0] 永远存储当前范围内的最大值。
C++ 核心组件实现
实现堆排序的关键在于两个辅助函数:max_heapify(维持堆性质)和 build_max_heap(初始建堆)。
第1步:实现 max_heapify 维护子堆结构
目的: 假设节点 node 的左右子树已经是最大堆,但 node 本身可能破坏了堆性质。该函数通过将 node “下沉”到合适位置,恢复局部最大堆性质。
// 宏定义计算子节点下标
#define LEFT(i) (2 * (i) + 1)
#define RIGHT(i) (2 * ((i) + 1))

/*
 * 将以此刻node为根的子树调整为最大堆
 * 前提:node的左右子树已是最大堆
 */
void max_heapify(int heap[], int heap_size, int node)
{
  int l_child = LEFT(node);
  int r_child = RIGHT(node);
  int max_value = node;

  // 检查左子节点是否存在且大于当前最大值
  if (l_child < heap_size && heap[l_child] > heap[max_value])
  {
    max_value = l_child;
  }
  // 检查右子节点是否存在且大于当前最大值
  if (r_child < heap_size && heap[r_child] > heap[max_value])
  {
    max_value = r_child;
  }
  // 如果最大值不是当前节点,则交换并递归调整
  if (max_value != node)
  {
    swap_val(heap + node, heap + max_value);
    // 递归处理被交换影响的子树
    max_heapify(heap, heap_size, max_value);
  }
}
参数说明: heap 为目标数组,heap_size 为参与调整的堆的有效大小,node 为当前处理的根节点索引。该过程最坏时间复杂度为 O(log n)。
第2步:实现 build_max_heap 自底向上建堆
目的: 将整个无序数组转化为一个合法的最大堆。由于叶子节点天然满足堆性质(视为单个元素的堆),我们从最后一个非叶子节点开始,向前逐个调用 max_heapify。
/* 将数组整体构造成最大堆 */
void build_max_heap(int heap[], int heap_size)
{
  if (heap_size < 2)
  {
    return;
  }
  // 找到第一个叶子节点的位置
  int first_leaf = heap_size >> 1;

  int i;
  // 从最后一个非叶子节点倒序遍历至根节点
  for (i = first_leaf - 1; i >= 0; i--)
  {
    max_heapify(heap, heap_size, i);
  }
}
性能分析: 虽然单次 max_heapify 为 O(log n),但由于越接近叶子节点的层数高度越低,实际总复杂度经数学推导后可优化至 O(n)。若数组原本降序排列,建堆耗时可缩短至 O(n)。
完整的堆排序主函数
目的: 结合建堆与反复交换提取最大值,完成最终排序。
/* 堆排序入口函数 */
void heap_sort(int heap[], int heap_size)
{
  if (heap == NULL || heap_size < 2)
  {
    return;
  }
  // 1. 构建初始最大堆
  build_max_heap(heap, heap_size);

  int i;
  // 2. 逐步将最大值交换至末尾
  for (i = heap_size - 1; i > 0; i--)
  {
    /*
     * 交换堆顶(最大值)与当前未排序部分的最后一个元素
     * 此时 heap[i] 已是正确位置的最大值,规模减1
     */
    swap_val(heap, heap + i);
    heap_size--;

    // 3. 对剩余部分重新维护最大堆性质
    // 注意:只有根节点破坏了堆性质,其他子树依然合法
    max_heapify(heap, heap_size, 0);
  }
}
算法性能总结与适用场景
通过上述实现可以清晰看出堆排序的性能特征:
- 时间复杂度: 建堆过程最坏 O(n log n),排序循环部分每次需 O(log n) 且执行 n 次,因此最好、最坏和平均时间复杂度均为 O(n log n)。这使得堆排序在处理大规模数据时表现稳定,不会像快速排序那样出现 O(n²) 的最坏情况。
- 空间复杂度: 仅使用常数级额外变量进行交换,空间复杂度为 O(1),属于原地排序算法。
- 稳定性: 堆排序是不稳定排序。交换过程中相同值的元素相对顺序可能改变。
综上,当需要严格的 O(n log n) 上限性能且内存受限,或无需保持相等元素原始顺序时,基于最大堆的堆排序是极佳选择。
以上就是基于最大堆的堆排序算法原理及C++实现的详细内容,更多关于C++基础算法与数据结构优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









