

Pandas遍历DataFrame元素的两种高效方法
本文介绍在Python中使用Pandas库遍历DataFrame每个元素的两种方法。第一种利用applymap函数结合逻辑索引,实现全表快速筛选;第二种通过遍历列名并使用Series.str.contains进行逐列处理。文章对比了两种方式的适用场景,并强调高阶函数在提升数据处理效率方面的优势。
2026-10-13
22

本文介绍在Python中使用Pandas库遍历DataFrame每个元素的两种方法。第一种利用applymap函数结合逻辑索引,实现全表快速筛选;第二种通过遍历列名并使用Series.str.contains进行逐列处理。文章对比了两种方式的适用场景,并强调高阶函数在提升数据处理效率方面的优势。
本文介绍如何在 Linux 环境下安装 Percona XtraBackup,并详细演示如何使用 innobackupex 命令对 MySQL 数据库执行全量备份、增量备份以及数据还原操作。文中涵盖了专用备份账号的创建、关键参数的设置及事务一致性准备等核心步骤。
本文详解Python3中如何实现List的多级排序。重点讲解sorted函数移除cmp参数后,如何通过key结合lambda表达式实现按多个元素排序。通过具体代码示例,展示如何自定义排序规则,如先按第一个元素再按第二个元素排序,并提供完整的代码实现与输出结果分析。
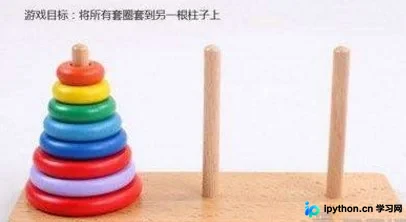
本文详细介绍使用Python实现汉诺塔算法的方法。文章阐述了汉诺塔的三条基本规则,并通过三阶汉诺塔的具体案例,深入解析了递归函数的调用逻辑与执行步骤。提供了完整的Python代码示例及程序运行结果,帮助读者理解形参与实参的区别,掌握递归在解决复杂移动问题中的应用。
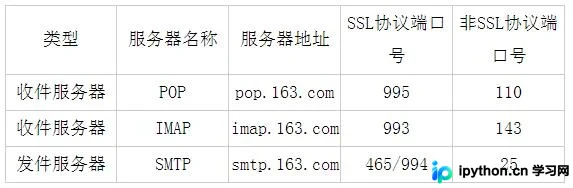
本文详细讲解在ThinkPHP框架中使用PHPMailer库通过SMTP协议发送电子邮件的方法。涵盖163和QQ邮箱的前期准备(开启服务与获取授权码)、核心配置文件参数设置、公共函数据调用逻辑以及表单测试验证步骤,帮助开发者快速解决服务器邮件发送需求。
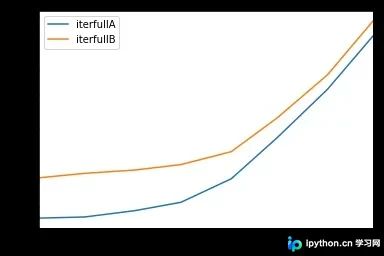
本文详细解析在 Pandas 中遍历 DataFrame 行的多种方法。重点对比了 iterrows()、itertuples()、apply() 以及 iloc 的性能差异与适用场景。文章指出 itertuples() 通常比 iterrows() 更快,并强调避免在迭代中修改数据的重要性,同时提供自定义 namedtuple 迭代器以进一步提升处理效率。
本文总结了MySQL查询优化的五个实用技巧,包括避免使用NULL并选择合适的数据类型、小心字符集转换开销、合理选择COUNT(*)与汇总表、将子查询转换为连接查询以提高效率,以及在无重复需求时使用UNION ALL替代UNION。通过调整数据结构与查询逻辑,可显著提升数据库处理速度。
本文介绍了一个轻量级的PHP类,利用GB2312编码特性将中文字符串转换为对应的拼音字符串。该类通过预定义的汉字区位码映射表,兼容UTF-8与GB2312环境,适用于需要拼音索引或搜索功能的Web应用开发。
本文介绍在Python Pandas中处理包含Tuple元素的DataFrame的高效方法。针对Word2vec输出的相似度数据,通过applymap结合lambda函数提取元组首个元素,并利用reset_index和rename重构数据结构,实现从索引提取关键词及过滤相似度值,提供比常规循环更优的性能方案。
本文详细解析Java中使用JDBC API连接数据库的标准流程,涵盖驱动注册(Class.forName与DriverManager)、URL配置及Connection对象创建。通过Oracle与MySQL的双重示例代码,演示了从建立连接到执行查询、处理ResultSet结果集及安全关闭资源的完整操作,帮助开发者掌握原生JDBC编程要点。
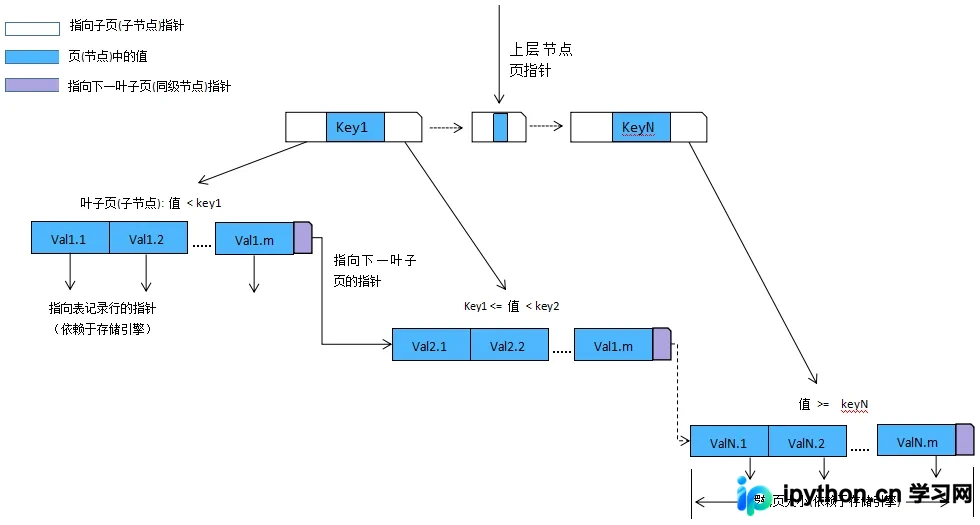
深入解析MySQL InnoDB引擎的B+树索引结构,详解聚簇索引与辅助索引差异。掌握复合索引的最左前缀匹配原则、范围查询对后续列的影响以及覆盖索引(Covering Index)的应用。通过explain工具中的key_len字段分析索引使用细节,结合页分裂与哈希索引特性,提供高效的SQL调优策略。
PHP原生不支持方法重载,可通过__call()魔术方法结合参数类型判断间接实现。方法覆盖(重写)则要求子类方法与父类同名同参且访问权限不低于父类。本文解析两者原理、代码示例及实际开发中的多态应用价值。
