Python解决大文件多次循环读取与定时任务执行方案
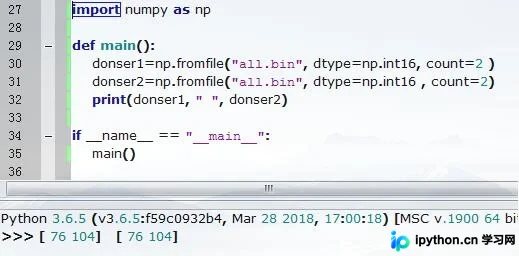
本文针对Python中numpy.fromfile无法追加读取大文件的问题,提供了基于生成器的分块读取解决方案,支持自定义包头包尾处理。同时介绍了利用死循环结合time.sleep实现每隔固定时间执行函数的简单方法,适用于接口数据定时获取与入库场景。
2026-10-13
19

本文针对Python中numpy.fromfile无法追加读取大文件的问题,提供了基于生成器的分块读取解决方案,支持自定义包头包尾处理。同时介绍了利用死循环结合time.sleep实现每隔固定时间执行函数的简单方法,适用于接口数据定时获取与入库场景。
本文介绍如何在C#中通过System.Diagnostics.Process调用WinRAR.exe命令行工具,实现文件夹及文件的加密压缩(.rar或.zip格式)和带密码的解压缩操作。详细解析a、m、x命令参数及密码设置方法,提供完整代码示例。
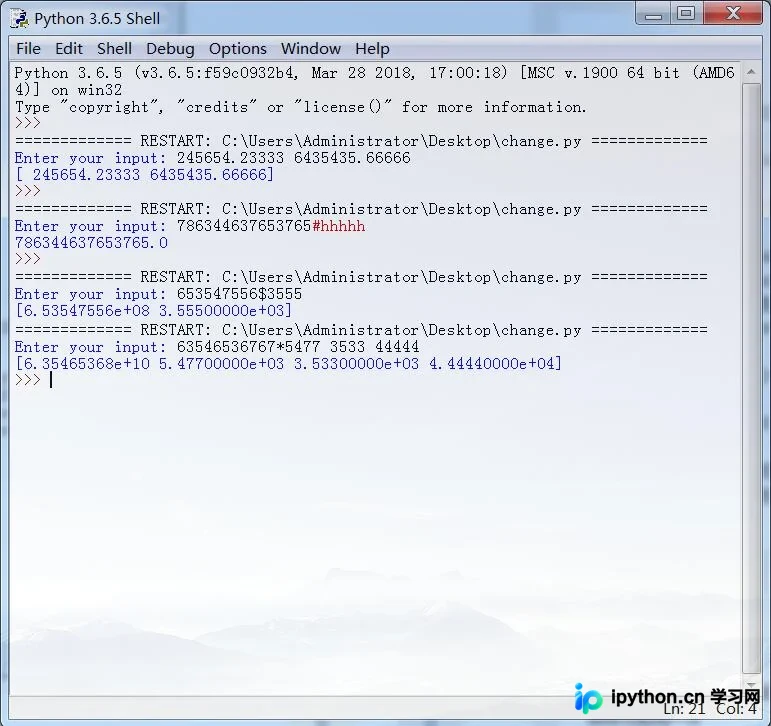
本文介绍了一个Python工具函数,用于将包含空格、特殊符号及注释的字符串转换为NumPy浮点数组。该函数通过正则表达式清理非数字字符,移除注释行,并处理小数点与科学计数法符号,最终返回一维数组。此外,还简要补充了使用astype()将浮点型转换为整型的方法,为数据预处理提供实用参考。
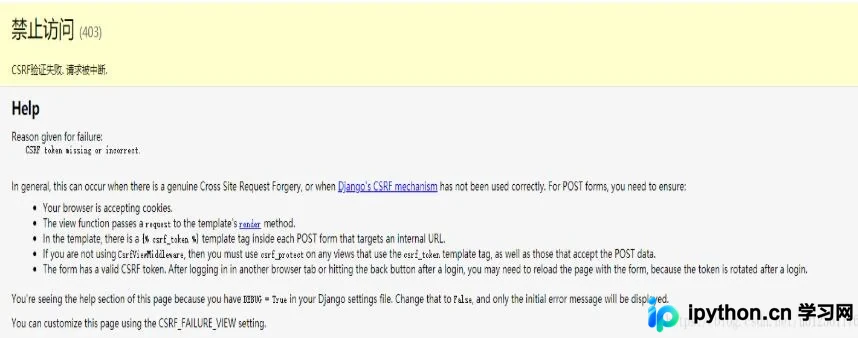
本文详细解析Django中常见的CSRF token missing or incorrect报错原因及解决方案。涵盖检查settings.py中的中间件配置、在模板中添加{% csrf_token %}标签,以及深入剖析Django CSRF验证机制中Secret与Token的关系,帮助开发者快速定位并修复跨站请求伪造保护相关的错误。
本文介绍使用 Python 的 Selenium 库抓取页面点击后弹出的窗口信息。通过 Firefox 浏览器配合 GeckoDriver,利用 XPath 定位元素并切换窗口句柄获取数据。针对自动化测试中点击按钮弹窗不显示的问题,提供使用模拟键盘 Enter 键替代 click() 的解决方案,并附带完整代码示例。
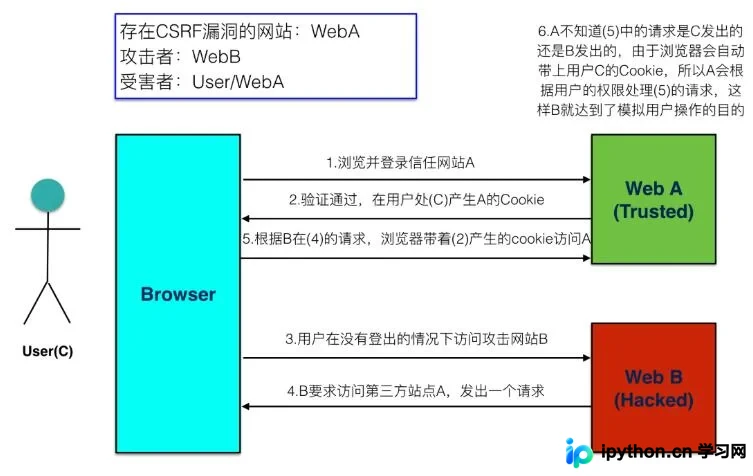
本文详解Django中预防CSRF(跨站请求伪造)攻击的机制。通过后端在Cookie中设置csrf_token,前端表单提交时携带该Token,服务端比对两者一致性来验证请求合法性。文章包含具体代码示例及URL重定向配置,帮助开发者保障用户隐私与财产安全。
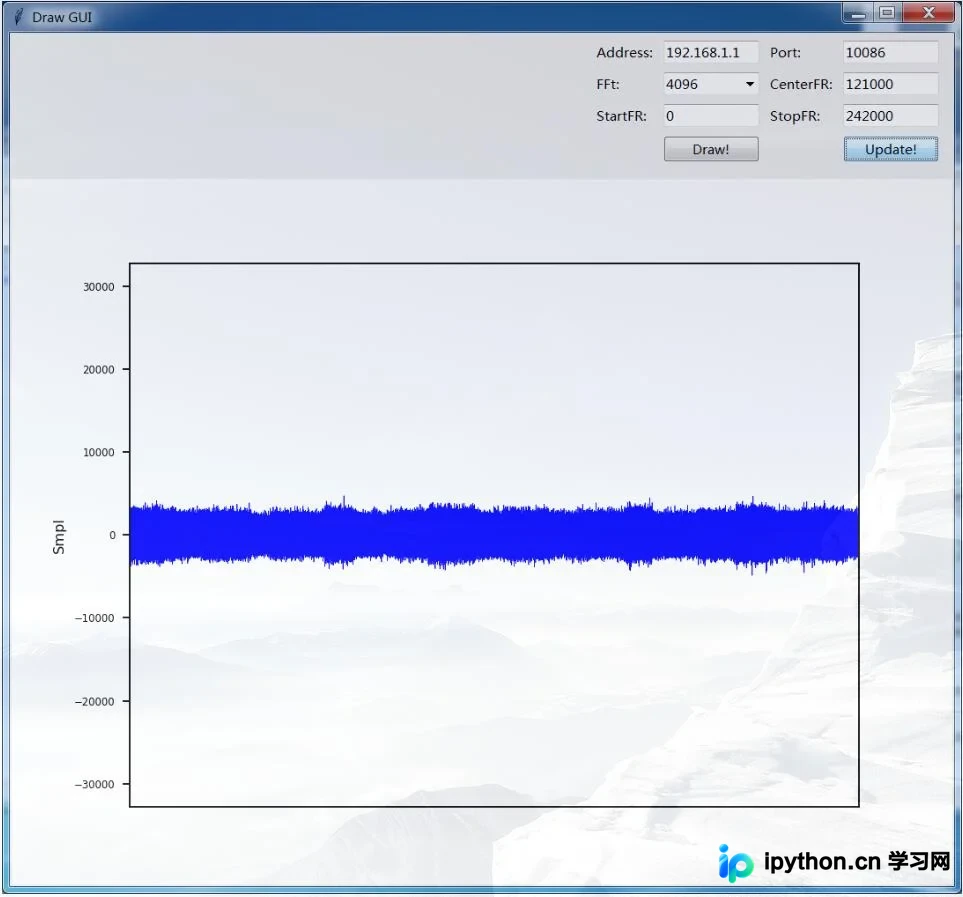
本文介绍使用Python Tkinter库构建简单图形界面,并解决多图片同时显示受限的问题。通过引入更新按钮机制,实现点击后自动切换显示不同图片(如降雨、示波、频谱图)。代码示例展示了如何结合PIL库加载图片并动态刷新标签控件,适用于需要定期更新可视化数据的轻量级桌面应用开发。
本文介绍在PHP中实现全角字符转换为半角字符的多种方法。涵盖基于字节偏移的正则替换(适用于GBK等双字节编码)、使用UTF-8多字节匹配的正则回调,以及通过数组映射进行字符串替换的通用方案。同时分析了不同编码环境下的兼容性问题,提供完整代码示例供开发参考。
本文介绍利用Python实现爬虫自动获取下一页内容的两种常见方法。第一种基于lxml和requests库,通过XPath定位下一页链接并循环下载图片;第二种结合BeautifulSoup与lxml,演示如何解析网页并提取下一页URL进行持续抓取。代码包含完整的请求头设置、异常处理及文件保存逻辑,适用于静态网页的数据采集场景。
本文详解在Django项目中实现Excel文件导出的完整流程,重点解决百万级数据下载时的MemoryError和Nginx超时问题。通过对比FileResponse与StreamingHttpResponse,深入解析使用SSDictCursor流式游标结合fetchone迭代生成的优化方案,确保大文件传输的稳定性和一致性。
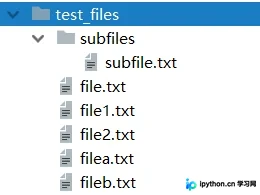
本文深入解析Python3标准库glob模块的文件名模式匹配机制。glob遵循UNIX路径扩展规则,支持星号(*)匹配多字符、问号(?)匹配单字符及字符区间[0-9]等用法。文章通过具体代码示例演示如何递归查找子目录文件,并介绍利用glob.escape()处理包含特殊元字符的文件名,帮助开发者高效实现文件系统扫描与文件筛选。
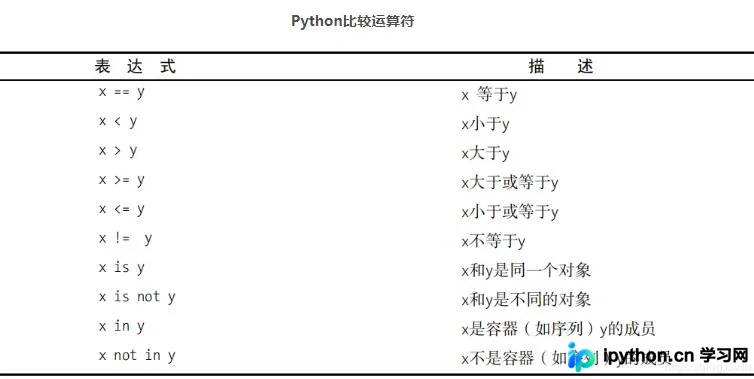
本文解析Python中一个常见误区:为何两个不相等的字符串在if语句中会被判定为True。通过对比错误写法`if str == 'a' or 'b'`与正确写法,深入讲解Python的真值测试机制、布尔运算符的短路逻辑以及`==`与`is`的区别,帮助开发者避免此类逻辑错误。