

pandas DataFrame 中的 explode 函数用法详解
本文详解pandas中explode函数的用法,该函数可将包含列表或元组的列展开为多行。文章提供了两种手动实现列内字典/列表拆分的方法,包括使用pd.Series转换和concat拼接,并附带完整代码示例与结果展示,帮助开发者高效处理复杂数据结构。
2026-10-13
26

本文详解pandas中explode函数的用法,该函数可将包含列表或元组的列展开为多行。文章提供了两种手动实现列内字典/列表拆分的方法,包括使用pd.Series转换和concat拼接,并附带完整代码示例与结果展示,帮助开发者高效处理复杂数据结构。
本文介绍在网页开发中,如何通过JavaScript结合jQuery实现类似Excel的Shift+Click多选和反选功能。通过记录最后点击项并计算范围,自动勾选或取消中间选项,提升用户交互体验。
本文介绍如何在Python中实现Hive中类似lateral view explode的功能,将包含多个标签的字符串拆分为多行数据。通过具体示例展示Hive SQL与Python代码的实现方式,并补充相关理论知识,帮助读者理解列转行的数据处理方法。
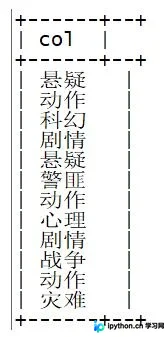
本文介绍如何在Python中使用Pandas库实现数据框的长格式与宽格式相互转换。通过stack和unstack方法,可将键值对形式的堆叠数据重塑为宽表,反之亦然。文章提供完整代码示例,涵盖从CSV读取、PeriodIndex构建到最终pivot和unstack操作的全过程,帮助开发者处理数据库交互中的常见数据结构转换需求。
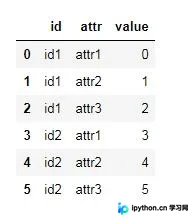
本文详解Python中json模块的使用,涵盖dumps和loads函数的基本用法,演示如何将Python数据结构转换为JSON字符串及反向解析。内容还包括使用indent参数美化输出、处理非标准数据类型、通过object_hook自定义解码逻辑,以及实现对象实例的序列化方法,帮助开发者高效处理JSON数据。
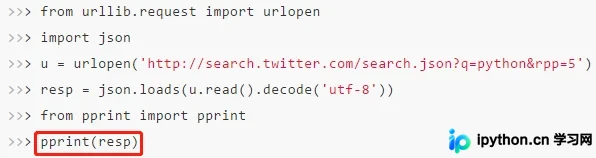
本文介绍了在C#中通过System.Diagnostics.Registry类读取和写入Windows注册表的实现方法。涵盖了打开指定注册表项、获取键值以及设置新值的步骤,同时包含必要的异常处理机制以确保代码稳定性,适用于需要配置系统信息的开发场景。
本文详细介绍如何解决Jupyter Notebook内核指向的Python路径与CMD命令行环境不一致的问题。通过对比sys.executable输出,定位并修改kernel.json文件中的解释器路径,确保Jupyter Notebook使用正确的Anaconda虚拟环境Python版本,从而解决库调用错误。
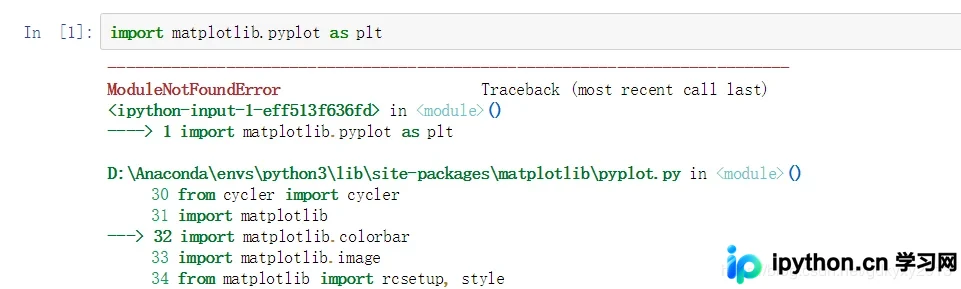
在Python开发中,简单的print打印无法提供足够的调试信息。本文介绍了利用logging.exception以及traceback模块(如print_exc、format_exc等)和sys.exc_info()获取完整异常堆栈信息的方法,帮助开发者快速定位代码错误位置。
本文探讨在Python程序打包为exe时,try-finally结构中异常信息未正常显示的问题。分析发现这是由于标准输出非异步导致堆栈信息延迟打印。通过引入traceback库并调整代码顺序,可确保异常堆栈被正确捕获和输出,解决“死掉后”不报错的现象。
本文深入解析Django ORM中F对象的核心用法。通过实例演示如何利用F对象进行字段值的原子加减、比较及乘积排序,避免内存读写开销。同时涵盖常规排序、随机排序及关联表字段排序等多种场景,提供高效的数据查询方案。
本文详细介绍如何在Python中使用Pandas进行分组求和与分组累加求和,涵盖groupby、count、cumsum及merge等关键操作。同时解析Django中利用aggregate与annotate函数对数据库字段进行条件求和的正确姿势,对比两种实现方式的输出差异,帮助开发者准确获取统计结果。
本文详细解析Go语言中Interface接口的核心机制,包括隐式实现、类型断言、空接口应用及接口组合等特性。通过具体代码示例展示如何定义接口、实现方法、使用逗号ok模式进行安全类型转换,以及利用switch-case处理多种类型,帮助开发者掌握Go语言多态编程的关键技术。