Python使用re模块爬取豆瓣Top250电影实战指南
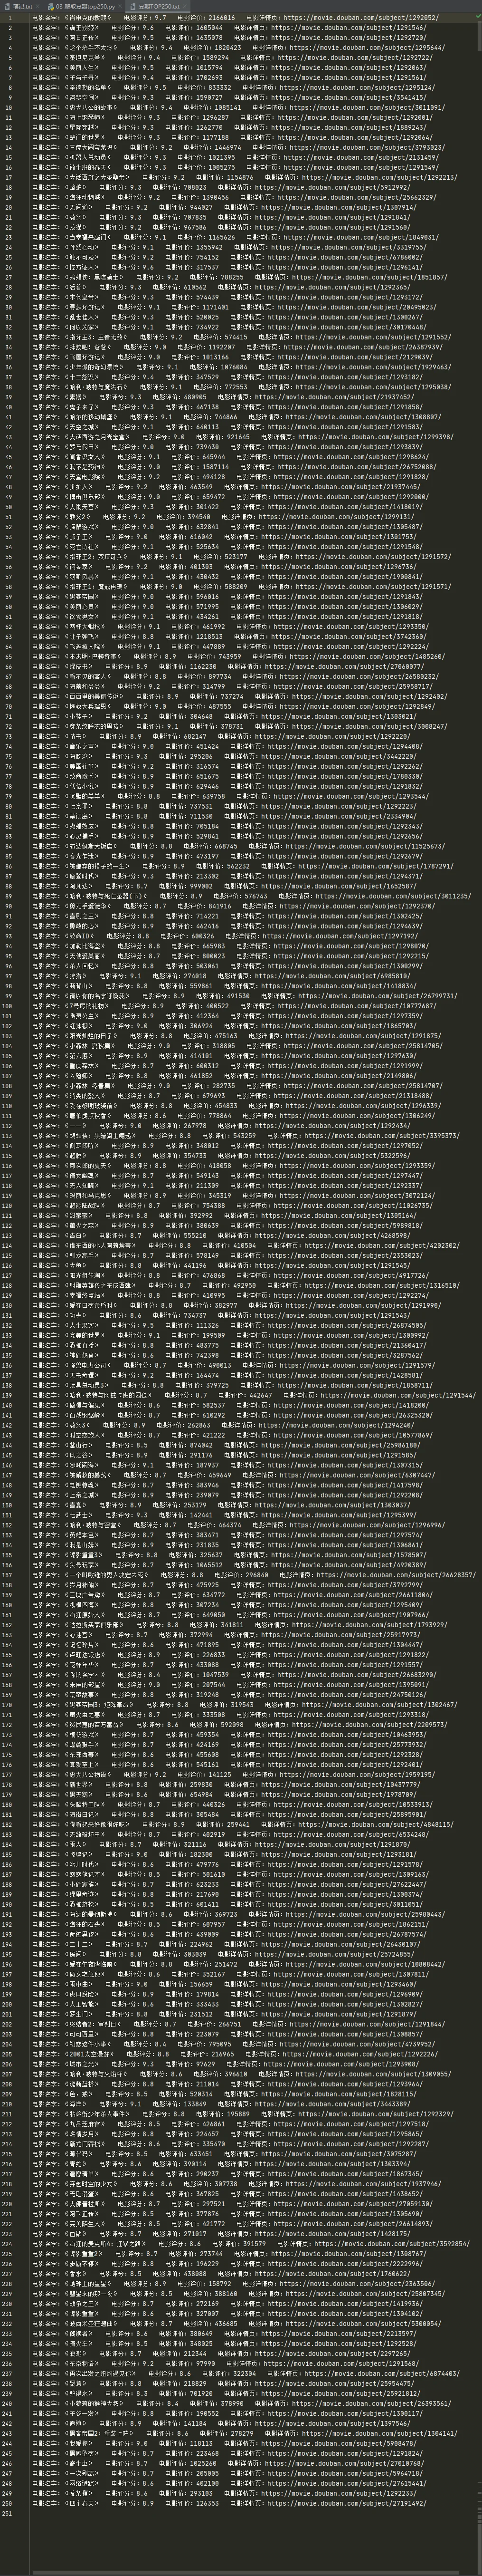
本文详细介绍使用Python爬取豆瓣电影Top250的完整流程。通过requests发送请求并设置User-Agent避免封禁,利用re模块正则表达式精准提取电影名称、评分及评价人数,最后将结果保存至本地文件。代码包含完整的请求、解析与保存逻辑,适合Python初学者学习网络爬虫基础。
2026-10-14
27

本文详细介绍使用Python爬取豆瓣电影Top250的完整流程。通过requests发送请求并设置User-Agent避免封禁,利用re模块正则表达式精准提取电影名称、评分及评价人数,最后将结果保存至本地文件。代码包含完整的请求、解析与保存逻辑,适合Python初学者学习网络爬虫基础。
本文详细介绍Python中JSON字符串与字典、字典与YAML字符串之间的相互转换方法。重点解析PyYAML 5.1版本后yaml.load()弃用原因及FullLoader安全加载器的使用,提供BaseLoader、SafeLoader等加载方式对比,确保数据解析安全性。
本文介绍在C#中获取上个月第一天和最后两天的具体实现方案。通过逻辑判断处理跨年场景,或利用DateTime类的DaysInMonth与AddDays方法进行简捷计算,帮助开发者快速解决日期范围查询问题。
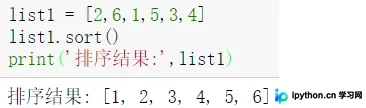
本文详细介绍Python3中list内置方法sort()的用法。该方法直接修改原列表,不返回新对象。重点解析key参数用于指定排序依据,以及reverse参数控制升序或降序排列。通过默认升序和降序实例,展示如何对列表进行高效排序操作。
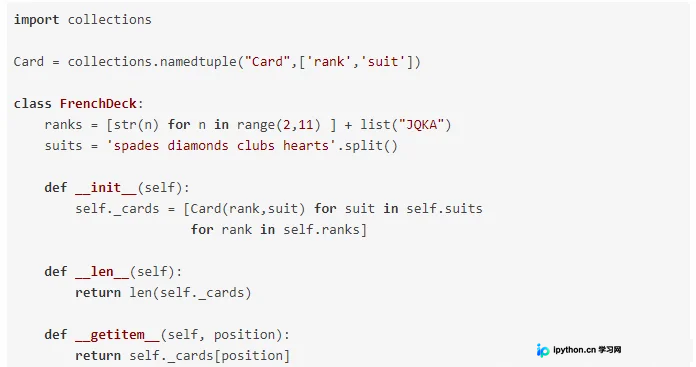
本文详解如何使用Python类属性构建52张标准扑克牌。通过collections.namedtuple定义纸牌结构,利用__getitem__实现索引与切片,结合random模块完成随机抽牌。重点解析基于花色权重映射的排序逻辑,以及通过实现__setitem__使不可变类支持洗牌操作的方法,并提供可视化扩展思路。
本文详细解析 JavaScript 中 map() 方法的语法、参数传递机制及执行特性,通过颜色对象转换实例展示其替代传统 for 循环的优势。同时深入剖析 map 结合 parseInt 时的常见 NaN 错误原因,并提供兼容 IE8 以下浏览器的解决方案,帮助开发者高效进行数组映射操作。
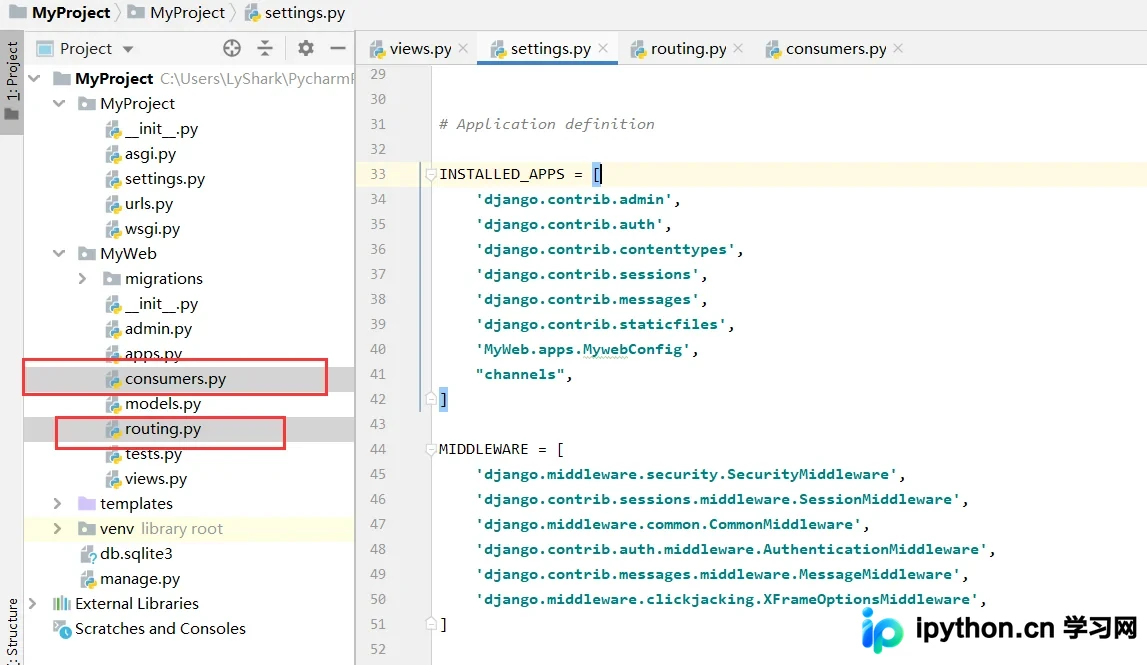
本文详细介绍如何在 Django 项目中集成 Channels 库以实现 WebSocket 实时通信。内容涵盖依赖安装、settings.py 配置、Redis 服务部署、路由文件 routing.py 与消费者 consumers.py 的编写,以及通过 Django Shell 验证通信链路的完整步骤,帮助开发者快速搭建基于 Django 的即时通讯应用。
本文介绍如何在 ThinkPHP 中结合自定义 where 条件与内置分页功能。通过 $Model->count() 获取数据总量,实例化 Page 类设置每页条数,构建包含 session 用户ID等的 map 数组作为查询条件,最后调用 findAll() 配合 limit 完成数据获取与分页渲染,确保列表准确显示当前用户相关记录。
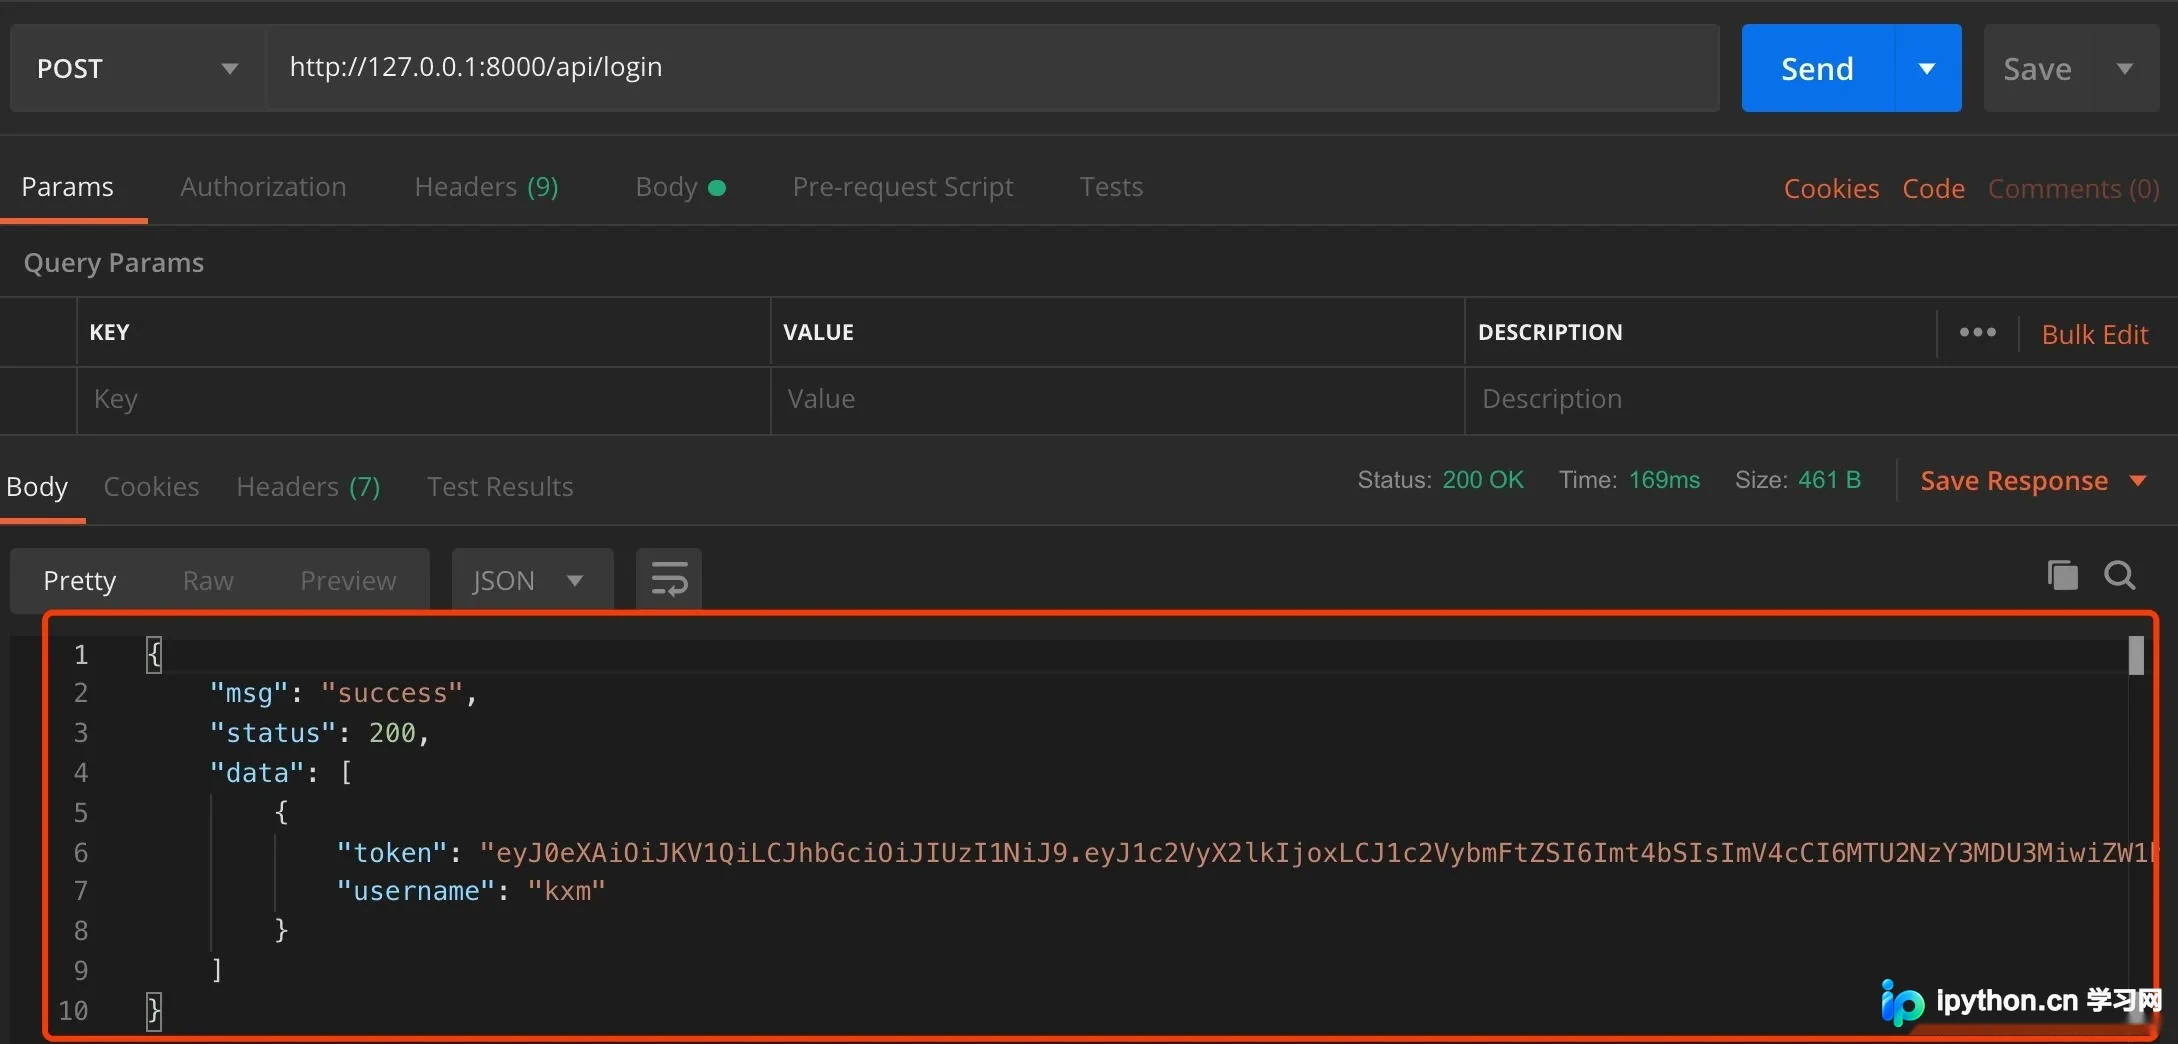
本文详细介绍如何在Django中使用rest_framework_jwt库时,自定义登录成功和失败的返回数据结构。通过配置settings.py中的JWT_RESPONSE_PAYLOAD_HANDLER和JWT_RESPONSE_PAYLOAD_ERROR_HANDLER,并重写视图函数,可实现对登录成功及认证失败(如用户名密码错误)时返回JSON格式的完全控制,提升API接口的友好性和一致性。
本文详解Python中Mock模块的使用,涵盖Python 2与3的差异。通过FastAPI模拟第三方接口,演示如何在单元测试中隔离外部依赖。重点介绍两种Mock方法:直接赋值Mock对象与使用@patch装饰器,帮助开发者在依赖服务不可用或复杂时,专注于核心逻辑测试。
本文解析了JavaScript中相等符号(==)与严格相等符号(===)的区别。==在比较时会自动进行类型转换,可能导致意外结果和性能损耗;===则要求值和类型都相同。对于对象比较,两者均比较引用地址。推荐使用===以确保代码逻辑清晰和运行效率。
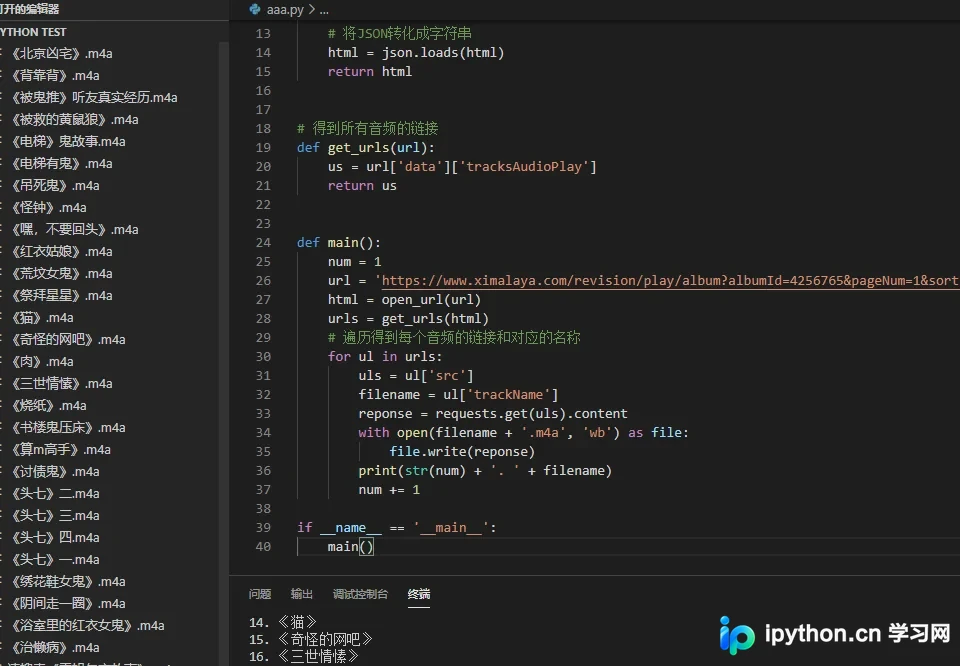
本文介绍如何使用Python编写脚本,从喜马拉雅网站抓取鬼故事专辑的音频文件。通过解析动态生成的JSON数据获取音频链接,并利用requests库实现批量下载保存为m4a格式。代码包含完整的请求头设置、URL解析及文件写入逻辑,适合初学者学习网络爬虫与文件处理。