

Python自动化提取Jira Bug列表:从基础到一键生成的完整方案
本文介绍如何使用Python自动化从Jira系统提取Bug列表并生成CSV文件。内容涵盖三个版本的迭代开发:基础版、增加日期差异处理版以及最终优化的一键提取版。文章提供了完整的Python代码示例,包括JQL查询配置、登录认证、数据解析逻辑,以及配套的Windows批处理文件(.bat)用于环境初始化和程序执行,帮助开发者实现日报自动化的需求。
2026-10-14
19

本文介绍如何使用Python自动化从Jira系统提取Bug列表并生成CSV文件。内容涵盖三个版本的迭代开发:基础版、增加日期差异处理版以及最终优化的一键提取版。文章提供了完整的Python代码示例,包括JQL查询配置、登录认证、数据解析逻辑,以及配套的Windows批处理文件(.bat)用于环境初始化和程序执行,帮助开发者实现日报自动化的需求。
本文分析Python中使用logging模块时常见的日志重复打印问题。由于每次调用日志函数都会重新添加Handler,导致控制台和文件输出重复。文章提供了两种解决方案:一是使用单例模式预先实例化Logger对象;二是在添加Handler前判断handlers列表是否为空,从而避免重复注册。
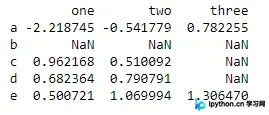
本文详细介绍Pandas库中pd.dropna()函数的用法,用于过滤DataFrame中的缺失数据(NaN)。文章解析了axis、how、thresh、subset和inplace等关键参数的具体含义,并通过多个代码示例演示了按行或列删除含空值数据、设定非空元素最低数量、指定子集判断以及原地修改等操作,帮助开发者高效进行数据清洗。
本文详细介绍如何使用C#和WinForms开发一款字幕滚动的屏幕保护程序。内容涵盖满足系统要求的窗体属性配置、基于Timer的字幕移动算法、鼠标键盘退出检测机制,以及响应Windows控制面板参数的处理。最后通过csc命令将代码编译为.exe并转换为标准的.scr格式进行部署。
本文详细解析PHP文件上传时$_FILES数组中error字段的各类返回状态码。涵盖从成功(0)到服务器配置限制、表单大小超限、临时目录缺失及写入失败等常见错误,帮助开发者快速定位并解决文件上传异常问题。
本文介绍在Python中使用pandas将数据中的NaN值转换为None的方法。通过df.where(df.notnull(), None)实现精准替换,解决接口接收数据时的类型兼容问题。同时补充了处理数据库读取后None转0.0时的常见误区,指出需区分NaN与None类型,并给出fillna的正确用法。
本文详解如何在C语言中通过结构体和函数指针实现面向对象的三大特性。利用嵌套结构体达成继承,通过虚函数表机制实现多态,结合命名规范与静态作用域完成封装。文中提供完整的Shape、Triangle等类层次结构代码,展示对象创建、析构及方法调用的真实操作过程。
本文介绍了在Python中获取Numpy数组前N个最大值及其索引的两种常用方法。首先通过numpy.argsort函数对数组排序获取索引,再反向切片得到Top N结果;其次利用heapq模块的nlargest函数直接提取最大值及其对应索引。文章包含具体代码示例与输出结果分析,适用于数据筛选与排序场景。
在使用数据库进行开发时,经常遇到需要同时修改关联表的多个字段的需求。通过JOIN语法结合UPDATE语句,可以在一个事务内完成多表数据的同步更新,既提高了效率,又避免了因多条语句执行失败导致的数据不一致问题。本文详细介绍MySQL中实现该功能的具体语法、参数配置及潜在风险。
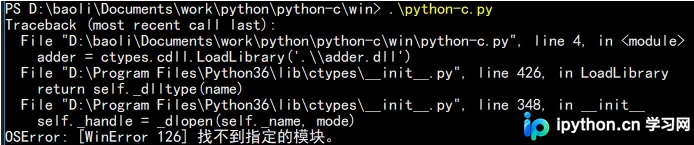
本文详细记录在Linux和Windows环境下,Python3通过ctypes模块调用C语言代码的完整流程。涵盖从编写C源文件、编译生成so或dll库,到Python中加载库、处理数据类型转换及解决Windows依赖问题的具体操作步骤与代码示例。
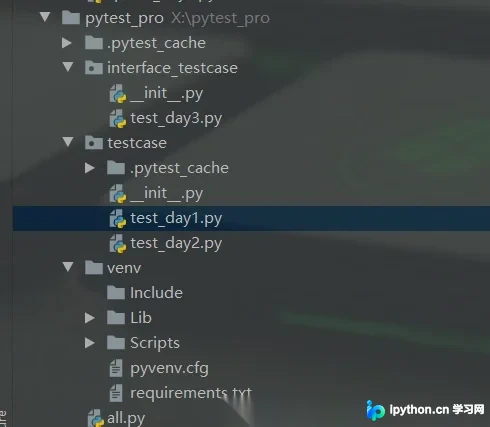
本文详细介绍Pytest测试框架的三种核心执行方式:通过pytest.main()在代码中调用、命令行参数指定模块或目录、以及利用pytest.ini配置文件统一管理。内容涵盖常用参数如-s、-v、-n及失败重跑机制,帮助开发者灵活控制测试流程并提升自动化测试效率。
本文分享一个用于C#操作Access数据库的封装类。通过配置web.config中的连接字符串,结合ConnDbForAcccess类提供的ExeSQL、ReturnDataSet等方法,实现安全的数据库连接、事务执行及数据读取,简化常规CRUD操作。