TensorFlow 固定随机种子实现可复现训练
本文介绍在 TensorFlow 中通过固定随机数种子来确保神经网络训练结果可复现的方法。针对参数初始化和数据读取中的随机操作,使用 tf.set_random_seed 函数设置统一种子,从而在输入数据相同的情况下获得一致的训练输出。
2026-10-13
6

本文介绍在 TensorFlow 中通过固定随机数种子来确保神经网络训练结果可复现的方法。针对参数初始化和数据读取中的随机操作,使用 tf.set_random_seed 函数设置统一种子,从而在输入数据相同的情况下获得一致的训练输出。
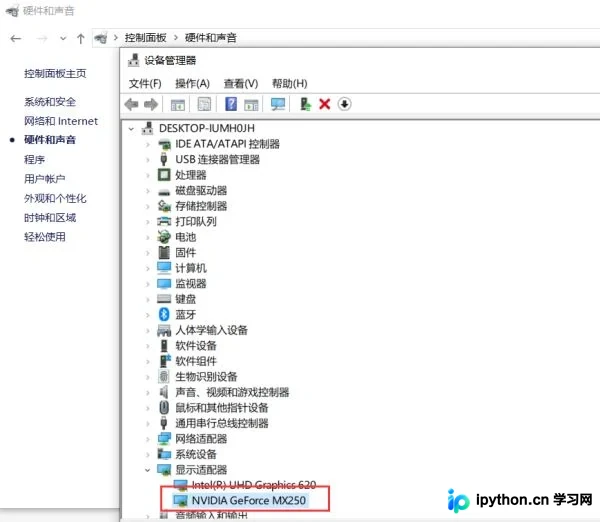
本文详细记录了在Windows 10系统中为NVIDIA MX250显卡配置TensorFlow GPU环境的全过程。针对旧版tensorflow-gpu 1.8.0,文章指导用户正确安装CUDA 9.0及对应版本的cudnn,并解决Anaconda版本兼容性问题。通过Python 3.6环境下的实际测试,展示了GPU加速训练带来的显著速度提升,为使用较老硬件进行深度学习开发提供了参考方案。
本文分析了在使用Keras(后端为TensorFlow)进行实验时,因版本不匹配导致服务器端实验结果异常的问题。通过对比不同环境下的版本组合,发现将服务器端的Keras降级至2.0.8并与TensorFlow 1.4.0配合使用可恢复正常运行。文章提供了版本兼容性参考链接,并强调了CUDA、cuDNN及库版本匹配的重要性。
本文详细介绍TensorFlow 2.0中矩阵与向量的基本运算方法。涵盖矩阵加法、乘法、减法及标量除法的具体实现,重点解析矩阵乘法中数据类型一致性要求及axes参数配置,提供完整代码示例与注意事项,帮助开发者快速掌握基础张量操作。
本文针对TensorFlow在批量测试时因sess.run导致的内存溢出问题,分析发现根源在于for循环内部动态创建tf操作节点,导致计算图无限膨胀。通过将resize_bilinear和argmax等Op移出循环至初始化阶段,可有效防止图节点重复增加,显著降低内存占用并提升推理速度。
本文深入解析TensorFlow中两种常用的梯度下降优化技术:指数衰减学习率与滑动平均参数更新。通过tf.train.exponential_decay函数实现学习率的动态调整,结合tf.train.ExponentialMovingAverage保持模型稳定性,帮助开发者提升模型收敛速度与泛化能力。
本文通过TensorFlow代码实例,演示如何使用tf.gradients函数计算梯度。以矩阵乘法为例,解析变量w1对结果res的导数计算过程,并展示梯度裁剪的实现方式,帮助开发者理解梯度反向传播的基本原理。
本文介绍在TensorFlow中通过tf.gradients()函数查看梯度的方法。针对模型训练时Loss不收敛的情况,分析梯度消失(趋近0)和梯度爆炸(数值过大)的原因,并给出调整权重初始化或使用ResNet等结构的建议。
本文详细介绍如何使用TensorFlow构建简单的多层神经网络来解决XOR(异或)线性不可分问题。通过定义输入输出、权重初始化、ReLU激活函数及Adam优化器,逐步演示模型训练过程。文章包含完整Python代码示例,并分析学习率与迭代次数对损失函数的影响,帮助初学者理解神经网络的基本原理与调参技巧。

本文介绍验证TensorFlow是否成功调用GPU的两种方法。一是通过配置log_device_placement=True查看启动日志,若显示GPU设备信息则表明已启用;二是运行高负载计算任务后,使用nvidia-smi命令监控显存占用情况。
本文通过TensorFlow代码示例,深入解析梯度下降法中var_list参数的作用。默认情况下,优化器会同时更新权重矩阵W([784,10])和偏置b。实验对比显示,若仅更新权重W,模型准确率约为0.9187,影响有限;而若仅更新偏置b,准确率骤降至0.1135,效果显著变差。这证明了在Softmax回归中,合理分配W和b的更新策略对模型性能至关重要。
本文深入解析TensorFlow中张量的提取与赋值操作。详细讲解tf.gather和tf.gather_nd从指定位置收集数值的方法,以及tf.scatter_nd和tf.scatter_nd_update将更新值写入张量的机制。通过函数原型、参数说明及代码示例,阐明索引维度与输出形状的关系,帮助开发者掌握高效处理张量数据的核心技巧。