基于Azure AI Search构建企业级RAG知识库:权限控制与检索实战指南
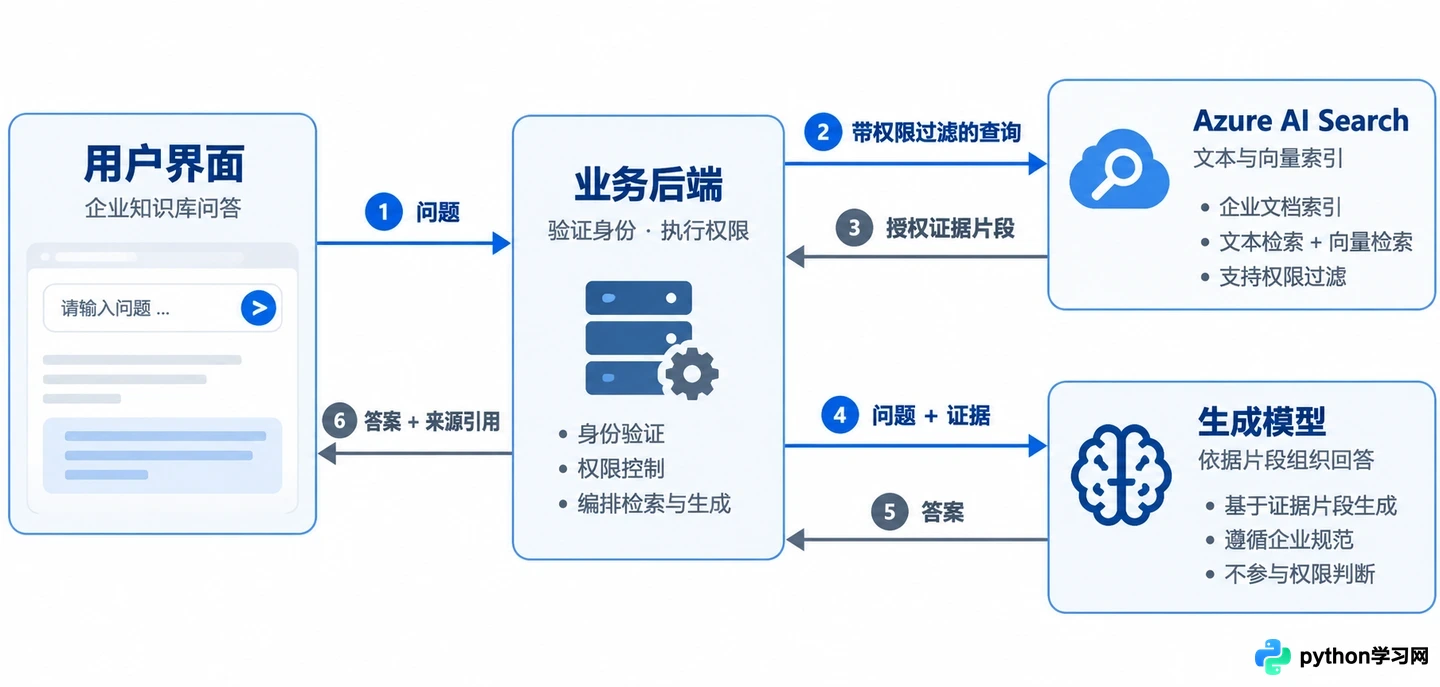
本文以Azure AI Search为例,详解如何构建具备权限控制的企业级RAG知识库。涵盖从数据分块索引、混合检索验证、安全过滤到生成回答的全流程,强调检索与生成的职责分离及权限前置原则,确保回答有据可依且符合企业安全规范。
2026-11-01
10
本文以Azure AI Search为例,详解如何构建具备权限控制的企业级RAG知识库。涵盖从数据分块索引、混合检索验证、安全过滤到生成回答的全流程,强调检索与生成的职责分离及权限前置原则,确保回答有据可依且符合企业安全规范。
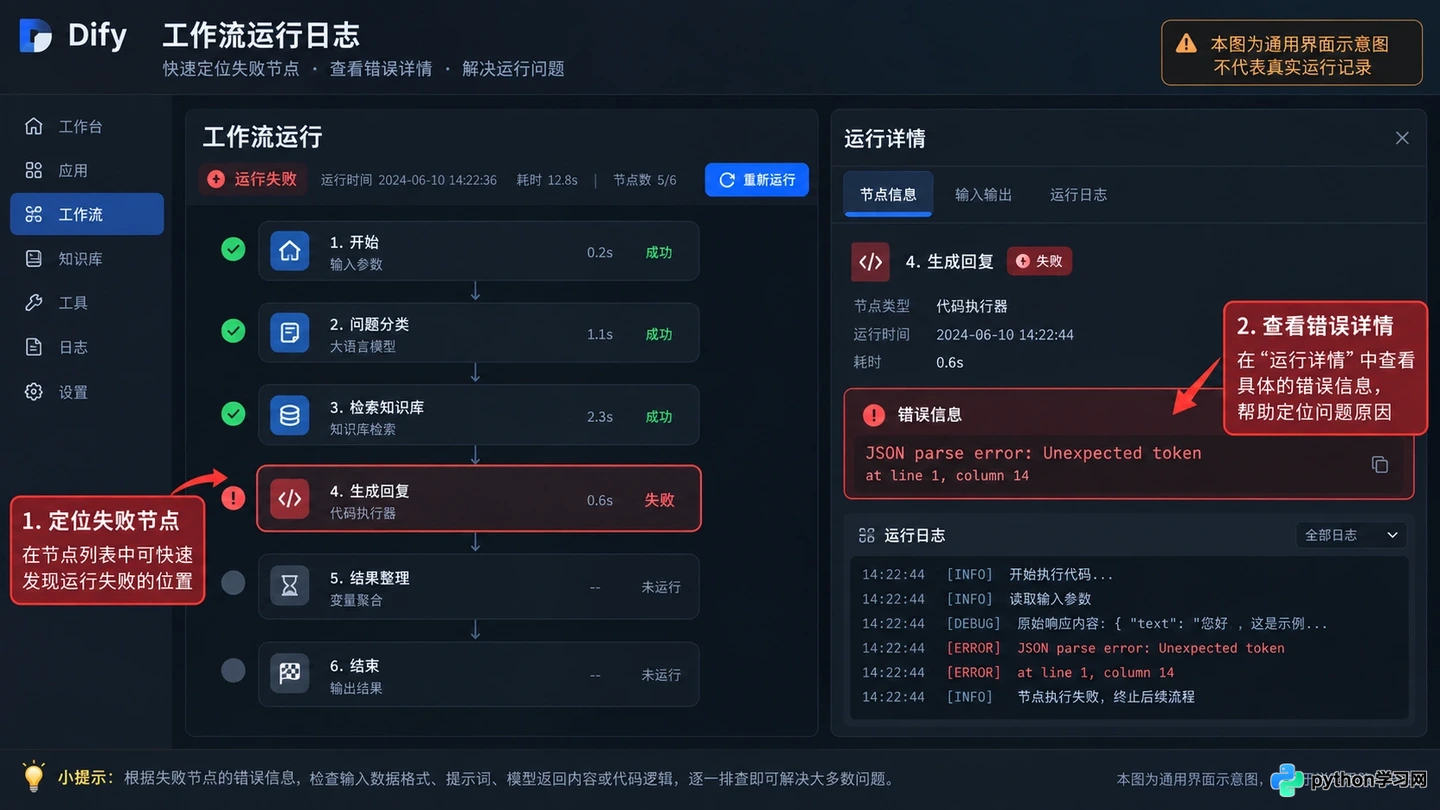
本文针对Dify工作流执行中常见的JSON解析错误、节点超时及API连接失败问题,提供基于日志查看和参数调整的具体排查步骤,帮助用户快速定位并修复工作流故障。
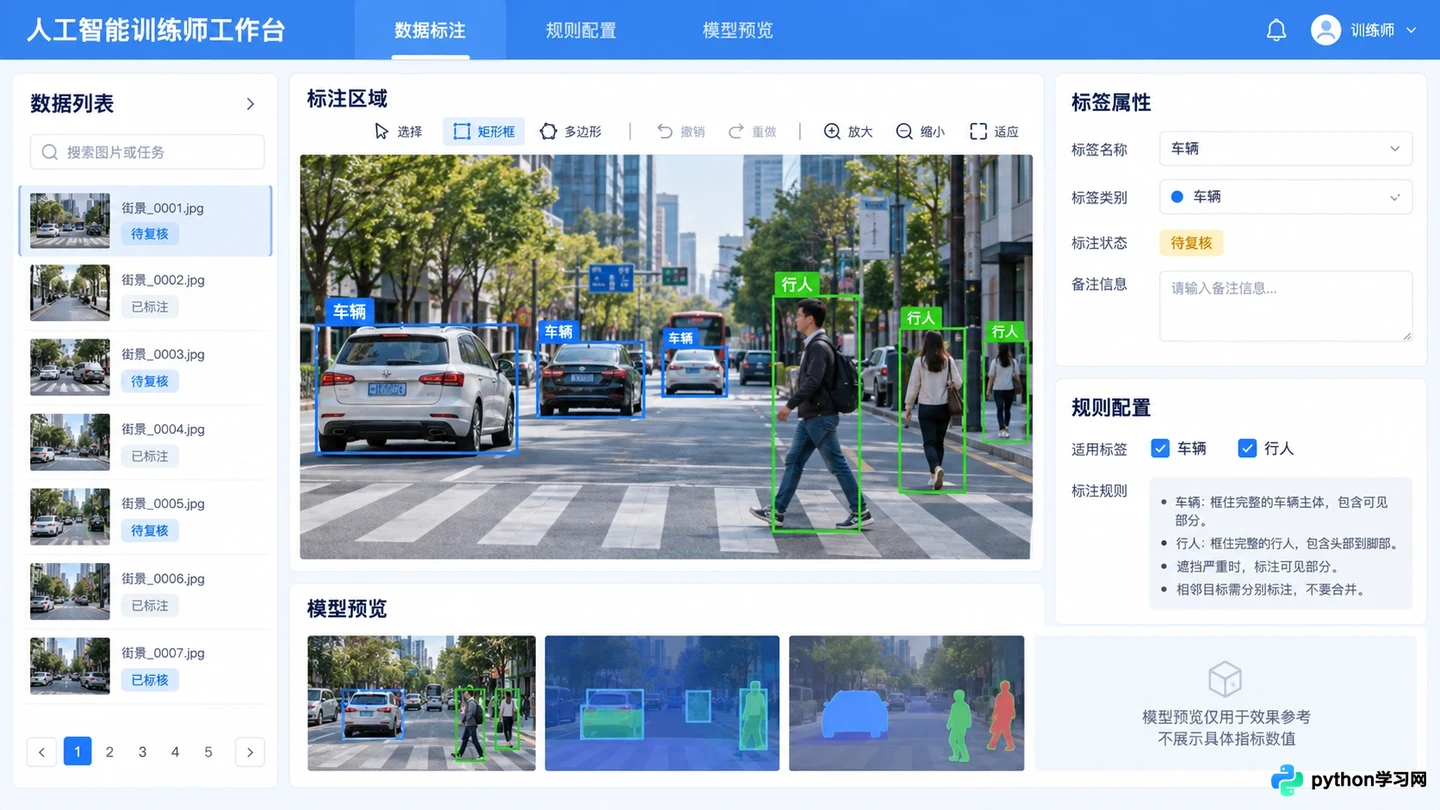
本文介绍人工智能训练师的职业定义,解析数据标注、模型调优及效果评估等核心工作内容,梳理所需的数据处理与业务理解技能,并明确其在AI产业链中的桥梁定位。
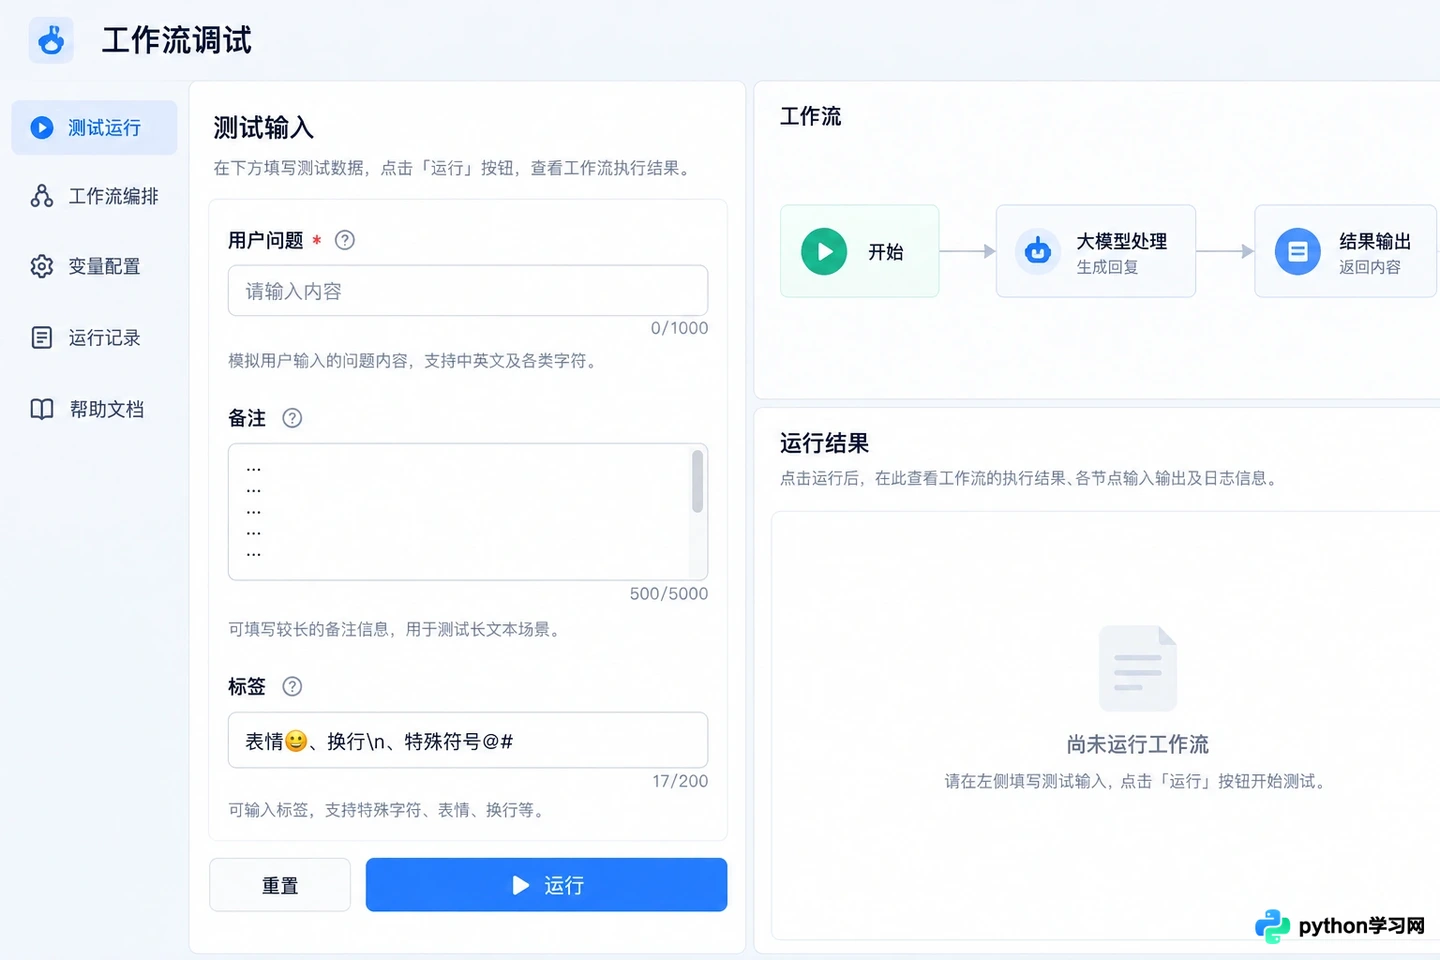
本文深入解析Dify工作流开发中的调试痛点,通过测试面板的输入模拟、单步执行和日志查看功能,帮助开发者快速定位LLM调用失败、变量传递错误及条件分支逻辑漏洞,提升应用构建效率。
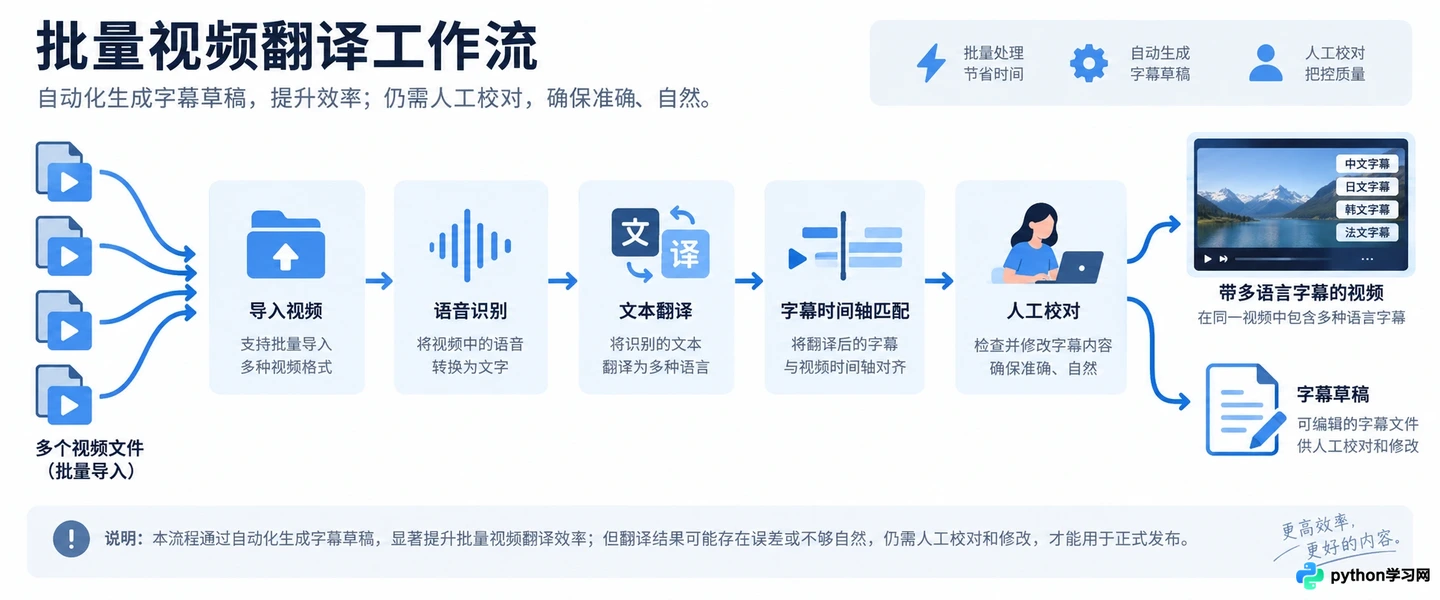
本文介绍如何利用AI工具实现视频文件的批量翻译,通过自动化工作流提升多语言内容制作效率,重点讲解文件预处理、批量导入及后期校对的关键步骤。
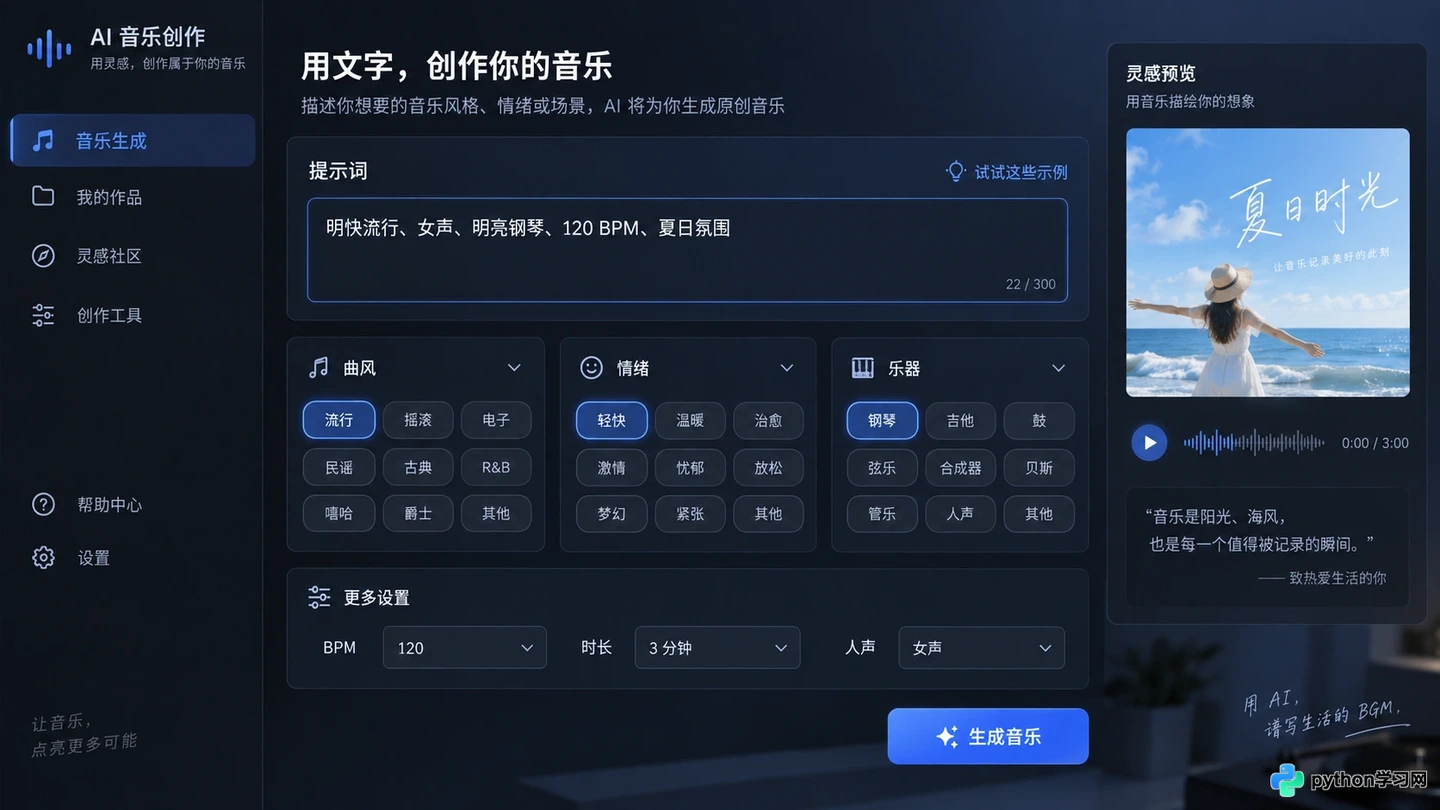
本文摒弃枯燥的参数罗列,以观点驱动的场景评析方式,深入探讨AI音乐创作的核心逻辑。文章从提示词工程的精准构建切入,解析如何通过风格标签与结构指令控制生成结果;进而分析在缺乏乐理基础的情况下,如何利用AI工具进行片段拼接与后期微调;最后梳理从多轨编辑到母带处理的导出规范。旨在帮助创作者理解AI并非替代者,而是将抽象灵感转化为具体音频的高效协作伙伴,明确其能力边界与最佳实践路径。
本文筛选了Suno、Udio等支持免费试用的AI音乐生成平台,从创作门槛、版权归属和生成质量三个维度进行场景化评析,帮助零基础用户在不付费的前提下体验AI作曲的核心乐趣与局限。
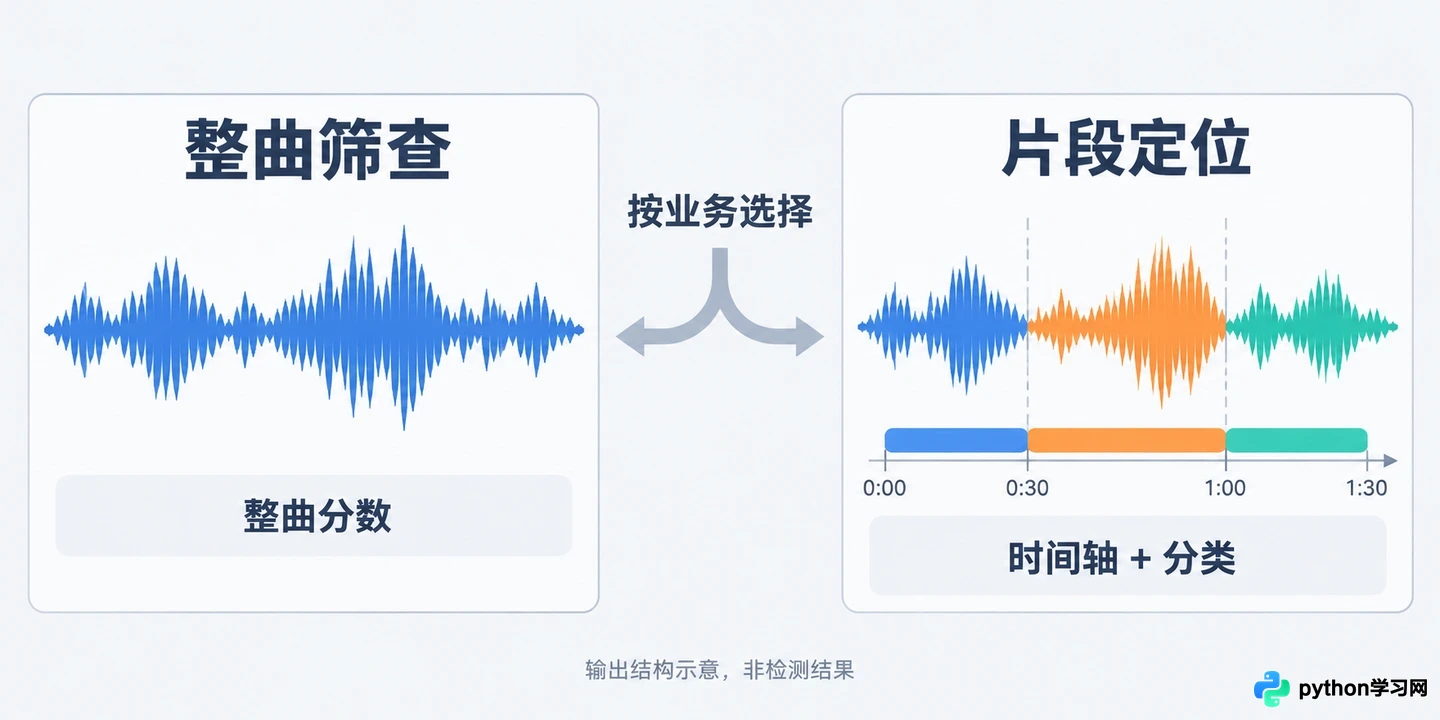
本文针对开发者将AI音乐检测接入自有应用的需求,解析Resemble、Pex和Hive三家主流API的集成逻辑。文章从业务场景切入,区分整曲判断与分段定位的不同需求,详细讲解各平台的认证方式、异步处理机制及结果解读误区,帮助开发者构建可复核、低风险的审核工作流。
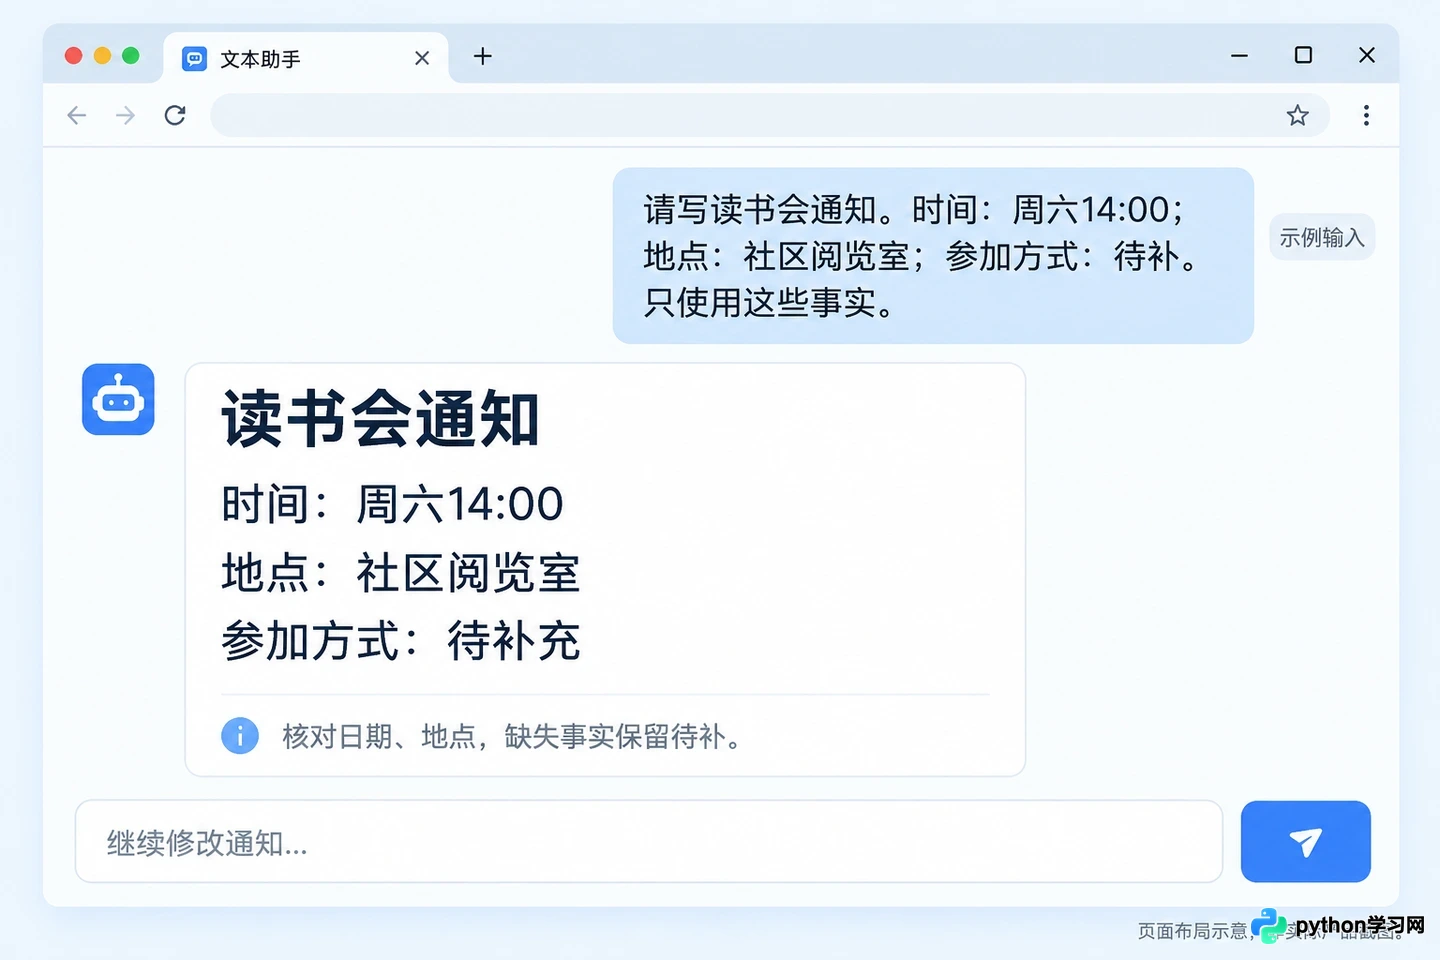
面对琳琅满目的AI工具,用户常因功能混淆而陷入选择困难。本文摒弃性能排名,从实际产出结果出发,将主流工具划分为文本、图像和视频三类。通过具体场景演示,介绍Kimi、DeepSeek在文本梳理上的应用,Adobe Firefly在视觉草图与局部修改中的优势,以及可灵AI等工具在视频片段生成中的定位。文章强调“组合使用”而非“单点依赖”,指导读者建立包含脚本整理、视觉设计和动态素材的工作流,避免盲目注册和无效试用。
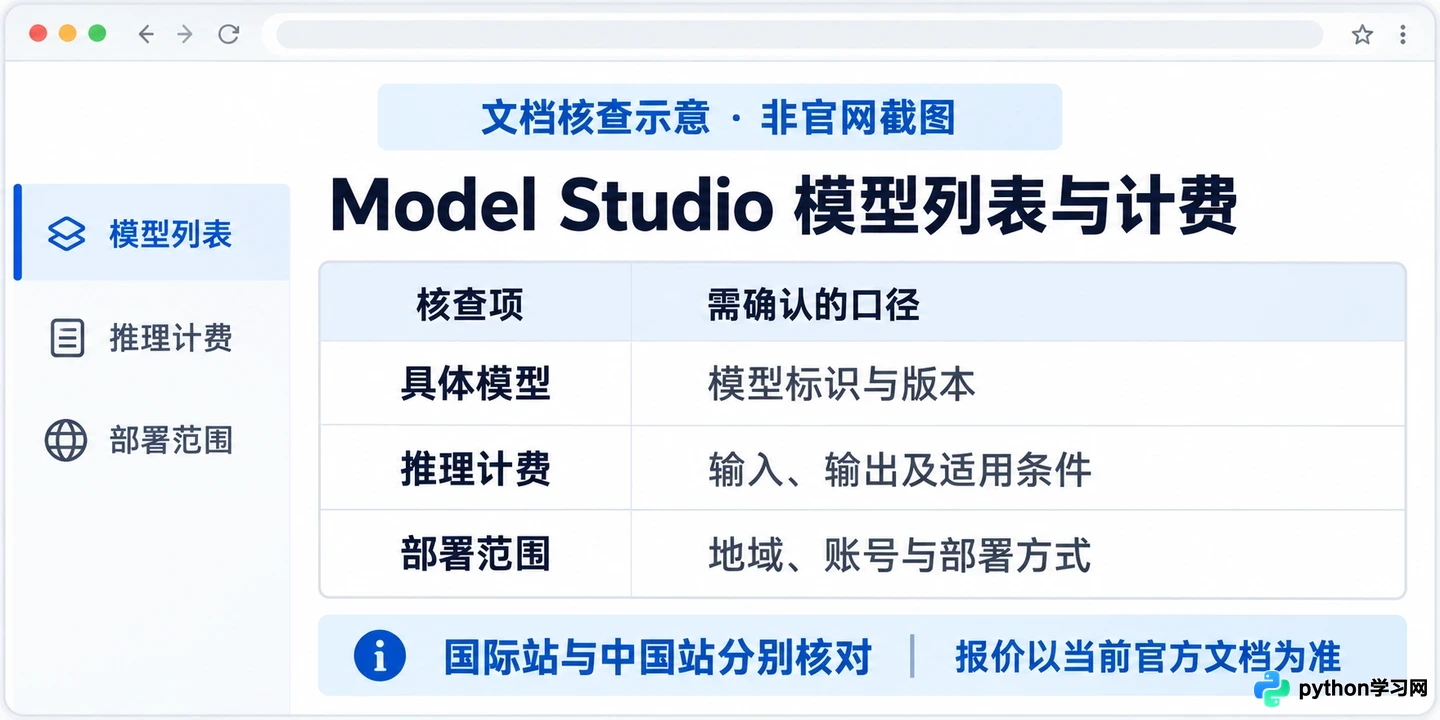
本文提供企业级大模型平台的选型核查框架,从官方文档入口出发,重点分析数据隐私边界、定制微调能力及真实计费模式。通过阿里云 Model Studio、Amazon Bedrock 和 Microsoft Foundry 的文档路径示例,指导用户在不上传生产数据的前提下,完成安全合规与成本效益的初步评估,避免仅凭营销标签做出采购决策。
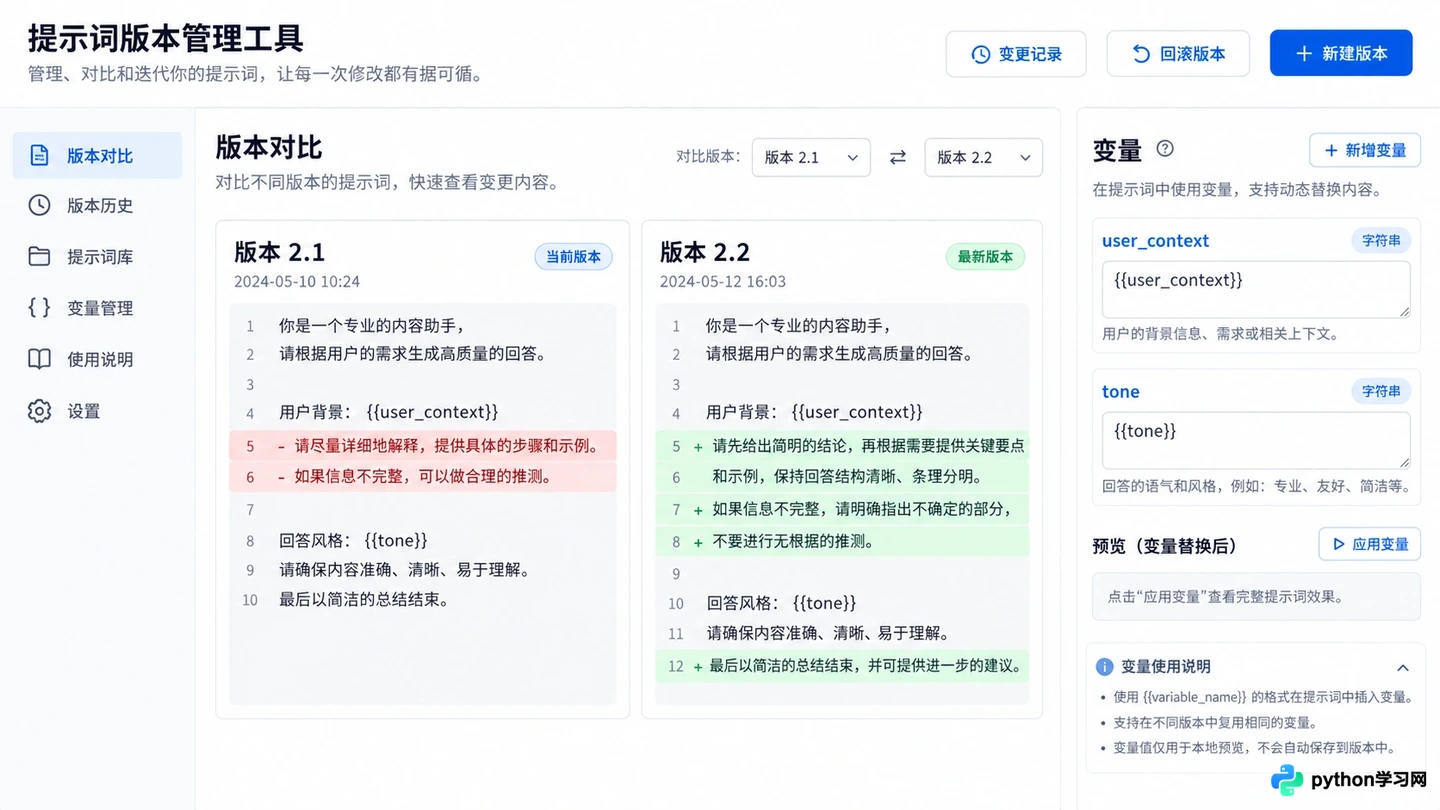
本文介绍高级AI提示词管理工具的核心价值,从提示词版本、测试实验、评分复核到运行监控四个维度,解析如何建立可追踪、可评估的提示词工作流,避免仅将工具作为文本存储库。
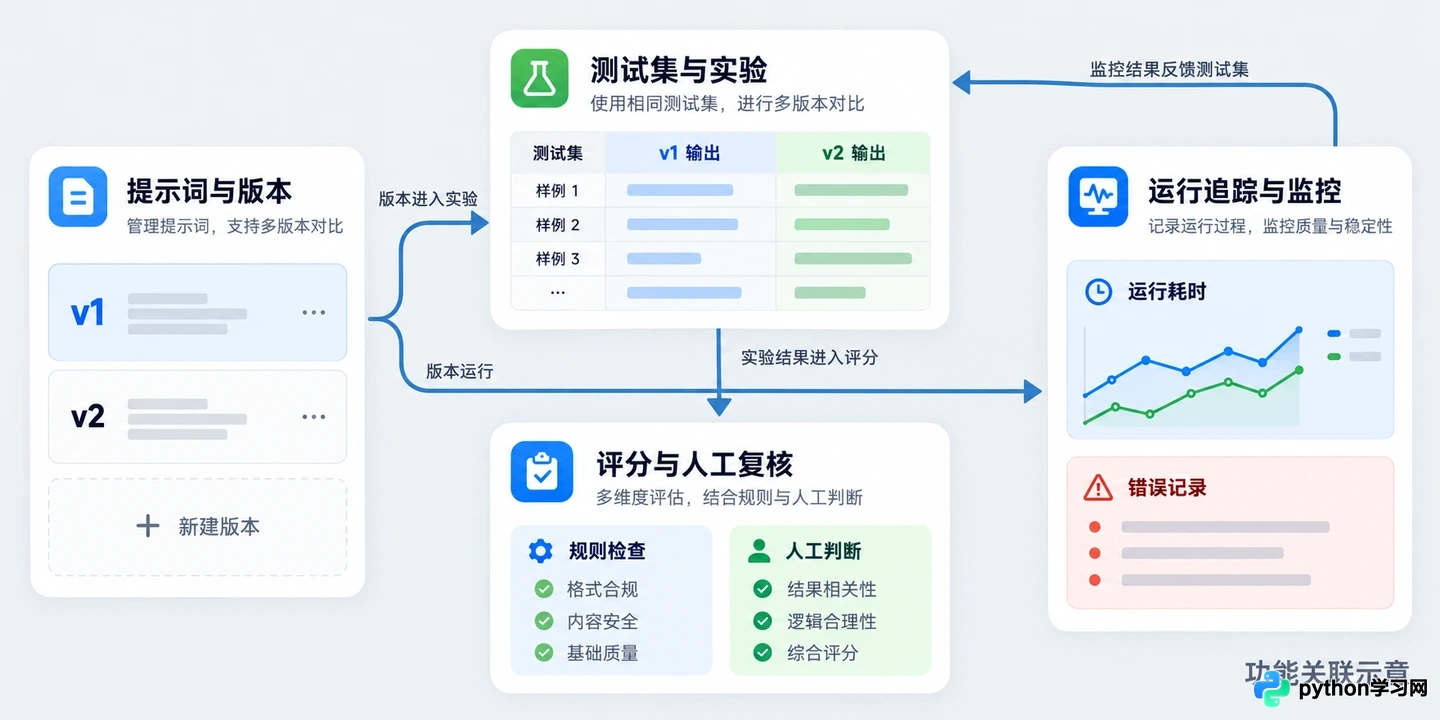
本文从实际工作场景出发,评析主流AI提示词管理工具的优劣。不罗列参数,而是聚焦于版本控制、团队协作和效果迭代三个核心痛点,帮助读者判断哪些工具能真正提升Prompt工程效率,哪些只是锦上添花。