

TF-IDF算法原理详解与Python代码实现

本文深入解析TF-IDF(词频-逆文档频率)算法的核心原理,阐述如何通过词频与逆文档频率计算关键词重要性。结合Python中的[[wp:a3]]分词与[[wp:a4]]计数工具,提供完整的代码实现示例,帮助开发者掌握文本挖掘中的关键词提取技术。
算法原理
TF-IDF(Term Frequency-Inverse Document Frequency,词频-逆文档频率)是一种用于信息检索与文本挖掘的统计方法,其核心目标是在文章集中识别出每篇文章的关键字,即评估文章中哪些词汇最具代表性。
该算法主要从两个维度进行考量:一是词语在单篇文章中的出现频率,二是该词语在整个文章集合中出现的普遍程度。
1、TF(Term Frequency)词频
首先解释第一个维度,即统计一篇文章中各个词语出现的频率。
直观来看,如果某个词语在一篇文章中出现的频率很高(排除“的”、“是”、“你”等常见助词),那么可以初步认为该词是这篇文章的关键词。
其数学表达公式如下:
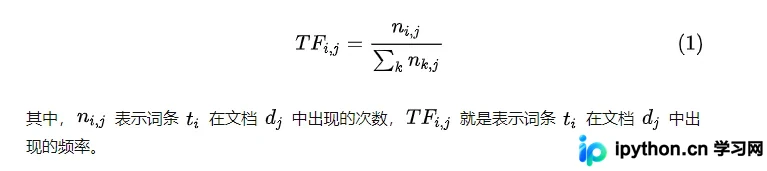
当某词在文章中出现次数较多时,TF值较大;出现较少时,TF值较小。需要注意的是,计算前需过滤掉“的”、“是”、“你”、“我”等无实际语义的助词和人称代词。
2、IDF(Inverse Document Frequency)逆文件频率
接着解释第二个维度,即考察该词语在哪些文章中出现过。在文章集合中,我们的目标是找出每篇文章特有的、能反映其独特性的关键词。通常,这类具有区分度的词语不会在其他文章中频繁出现;如果某个词在所有文章中都很常见,它对区分文章关键信息的作用就会减弱。因此,这一维度的目的是寻找那些在本篇文章中出现,但在其他文章中很少出现的词语。
其数学表达公式如下:
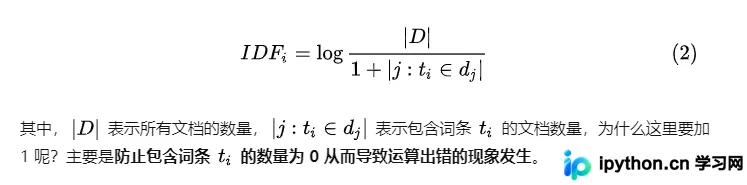
采用逆文档频率,若该词在文档集合中出现的文档数量较少,则IDF值较大;若该词在其余文档中出现较多,则IDF值较小。
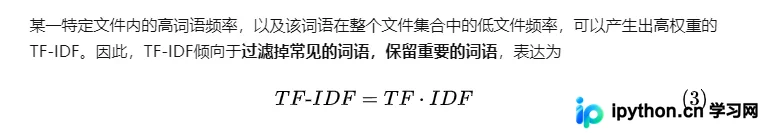
最后,将TF与IDF相乘,得到文章中每个词的TF-IDF值。该值越大,表明该词在文章中的重要程度越高,越适合作为文章的关键词。
Python实现
在本实现中,主要使用jieba进行中文分词处理,并利用Counter进行词频计数统计。
# -*- coding: utf-8 -*-

import math
import jieba
from collections import Counter
from collections import defaultdict


def TFIDF(dataset):
    # 统计每个文章中每个词语的tf
    j = 0
    doc_len = len(dataset)
    cntr = [0] * doc_len          # Counter每个文章
    total = [0] * doc_len          # 获取每个文章中各自的词语总数
    word_tf = [0] * doc_len          # 获取每个文章中每个词语的tf
    for sent in dataset:
        iters = jieba.cut(sent)
        cntr[j] = Counter(iters)
        total[j] = sum(cntr[j].values())
        word_tf[j] = defaultdict(int)
        for i in cntr[j].keys():
            word_tf[j][i] = cntr[j][i] / total[j]
        j += 1


    # 构建词汇表和总词频
    word_cnt = defaultdict(int)
    for word_list in word_tf:
        for word in word_list:
            word_cnt[word] += 1

    # 统计词汇在文档中的频率
    doc_tf = defaultdict(int)
    for word in word_cnt:
        for article in dataset:
            if word in article:
                doc_tf[word] += 1

    # 构建词汇的idf
    word_idf = {}
    for word in doc_tf:
        word_idf[word] = math.log(doc_len / (doc_tf[word] + 1))

    # 构建每篇文章中词的tf-idf
    t = 0
    word_tf_idf = [0] * doc_len
    for article in word_tf:
        word_tf_idf[t] = defaultdict(int)
        for word in article:
            word_tf_idf[t][word] = article[word] * word_idf[word]
        t += 1

    # 对每篇文章每个词的tf-idf进行由大到小排序
    t = 0
    for i in word_tf_idf:
        for j in i:
            word_tf[t] = dict(sorted(word_tf[t].items(), key=lambda x:x[1], reverse=True))
            word_tf_idf[t] = dict(sorted(word_tf_idf[t].items(), key=lambda x:x[1], reverse=True))
        t += 1

    return word_tf_idf, word_tf


if __name__ == '__main__':

    dataset = ["中国的北京是中国的首都","那里有一句话叫做“北京欢迎您”,北京啊北京",
               "北京欢迎您!相信梦想,梦,相信有梦就会有奇迹"]
    word_tf_idf,word_tf = TFIDF(dataset)

    print("=============tf-idf=============")
    for i in word_tf_idf:
        print(i)
    print("=============tf=============")
    for i in word_tf:
        print(i)
注:此代码旨在展示TF-IDF的实现逻辑,未对标点符号等进行停用词过滤处理。
总结
以上为个人经验分享,希望能为大家提供参考,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









