


在 Linux 上做高并发网络服务时,很多人都会先遇到同一个问题:线程模型写起来直观,但连接数一上来,CPU 时间和内存很快就被线程切换、栈空间和锁竞争吃掉。Rust 异步 I/O 常被当成性能答案,不过它并不是简单地“把阻塞改成非阻塞”,而是把编译器生成的状态机、运行时调度和内核事件机制组合到一起。理解 Future 怎么被编译、Tokio 怎么驱动任务,以及 epoll 与 io_uring 各自适合什么场景,才能判断该不该用、该用到什么程度。
线程模型为什么会先撞到天花板
在 Linux 上写高并发网络服务时,“每连接一线程”通常最先失效。连接数一旦过万,线程上下文切换和每个线程的栈内存开销都会迅速放大,系统资源会被非业务逻辑消耗掉。
把模型改成线程池,问题也不会自动消失。线程数量虽然受控了,但锁竞争、条件变量唤醒延迟,以及任务在多个工作线程之间来回调度,依然会限制吞吐量。
这也是 epoll 出现后长期成为 Linux 网络编程标配的原因。它把事件监听从“扫描所有连接”变成“只处理活跃连接”,系统调用复杂度从 O(N) 压到 O(活跃连接数)。但这里要分清一点:epoll 解决的是事件通知效率,不是数据读写本身的成本。应用拿到“可读/可写”通知后,仍然需要再调用 read/write 完成数据拷贝。
Rust 异步 I/O 则是在这个基础上继续往前走。它把 async/await 编译成状态机,让协程切换尽量发生在用户态,再由 Tokio 之类的运行时负责调度和事件驱动。这样做的核心价值,不只是语法更像同步代码,而是把高并发场景下最昂贵的线程切换成本,尽量替换成更轻的任务挂起与恢复。
Future 状态机如何接上事件循环
要理解 Rust 异步为什么能兼顾抽象能力和性能,关键就在于它不是在运行时解释 async 逻辑,而是在编译期直接把异步函数改写成显式状态机。
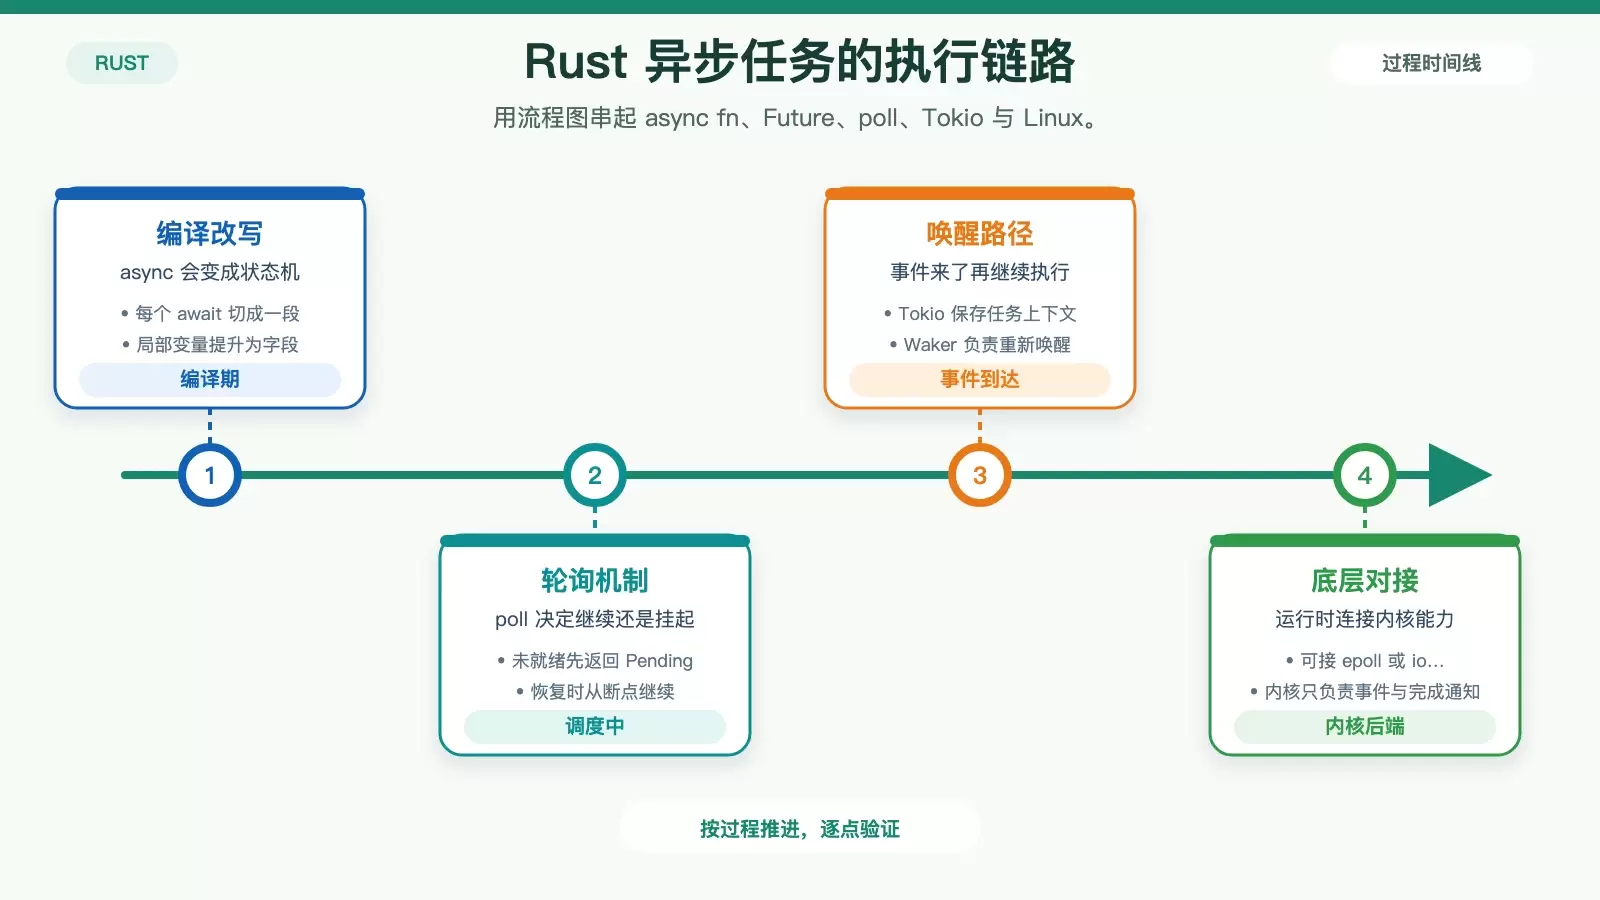
应用代码(async fn)
    ↓ 编译
状态机 Future
    ↓ poll()
Tokio 运行时
    ↓ 注册 fd
epoll/io_uring
    ↓
Linux 内核
这条链路里,应用代码不会直接“睡眠等待 I/O”,而是通过 poll 把执行权交给运行时。如果数据还没准备好,poll 返回 Pending,Tokio 就把当前任务挂起;等内核通过 epoll_wait 或其他后端通知事件已就绪,Tokio 再唤醒对应的 Waker,继续执行同一个 Future。真正读到数据后,才会返回 Poll::Ready。
async fn 是怎么编译成状态机的
编译器遇到 async fn 时,会把原函数体转换成一个实现了 Future trait 的匿名结构体。每一个 .await 都会成为一个状态切换点,相当于把函数拆成多段,等下一次 poll 时从断点继续往下跑。
也就是说,Rust 异步并不是“保存线程栈”,而是把原本在线程栈上的局部变量提升为状态机结构体的字段。只要这些变量要跨越 .await 存活,它们就必须被放进 Future 内部,等待下一轮恢复执行时继续使用。
这也是 Pin 变得重要的根本原因。状态机一旦持有跨 .await 的内部引用,就可能形成自引用关系;如果这个 Future 在内存中被移动,内部指针就会失效。Pin 的作用,就是保证这类对象在被固定后不再随意移动,维持状态机恢复执行时的内存安全前提。
从性能角度看,这种模式的优势在于:协程切换不需要像线程切换那样保存和恢复完整上下文,也不需要为每个任务额外准备一块独立栈空间。抽象层面是 async/await,落到机器执行层面接近手写状态机,因此常被称为“编译器驱动的并发”。
epoll 和 io_uring 到底差在哪
Tokio 在 Linux 上默认使用 epoll 作为 I/O Driver 后端。它的工作方式是“就绪通知”:内核负责告诉应用哪些文件描述符已经可读、可写,但真正的数据收发还是要由应用自己发起系统调用。
这意味着一次典型 I/O 路径里,应用至少会经历“等事件”加“做读写”两个阶段。原文中的表述很直接:每次 I/O 至少两次系统调用,即 epoll_wait 加上 read。
io_uring 的设计思路则明显不同。它通过共享环形缓冲区让用户态和内核态交换请求与结果:应用把 I/O 操作提交到提交队列(SQ),内核完成后再把结果写入完成队列(CQ)。这种模型尽量绕开传统“每一步都要一次系统调用”的交互方式,把系统调用开销压得更低。
从理解上可以把二者概括为:
epoll更像“先通知你可以做,再由你自己去做”。io_uring更像“先把要做的事交给内核,做完后直接告诉你结果”。
这也是为什么在高吞吐、短连接、I/O 非常密集的场景下,io_uring 往往更有吸引力。它减少的不只是等待时间,更是 I/O 路径上的内核切换成本。
实际代码怎么写:Tokio 与 io_uring 两种方式
理解模型之后,再看代码会更清楚:Rust 异步网络服务的主体并不复杂,复杂的是运行时和内核替你承担了多少底层工作。
Tokio 异步 TCP 服务
use tokio::net::{TcpListener, TcpStream};
use tokio::sync::Semaphore;
use tokio::io::{AsyncReadExt, AsyncWriteExt};
use std::sync::Arc;
use std::time::Duration;
struct ServerConfig {
    max_connections: usize,
    read_buffer_size: usize,
    write_timeout: Duration,
}
async fn handle_connection(
    mut stream: TcpStream,
    config: Arc<ServerConfig>,
) -> Result<(), Box<dyn std::error::Error + Send + Sync>> {
    let mut buffer = vec![0u8; config.read_buffer_size];
    loop {
        let n = tokio::time::timeout(
            Duration::from_secs(30),
            stream.read(&mut buffer)
        ).await??;
        if n == 0 {
            break;
        }
        tokio::time::timeout(
            config.write_timeout,
            stream.write_all(&buffer[..n])
        ).await??;
    }
    Ok(())
}
async fn run_server(config: ServerConfig) -> Result<(), Box<dyn std::error::Error + Send + Sync>> {
    let listener = TcpListener::bind("0.0.0.0:8080").await?;
    let config = Arc::new(config);
    let semaphore = Arc::new(Semaphore::new(config.max_connections));
    println!("服务启动,最大并发连接: {}", config.max_connections);
    loop {
        let (stream, addr) = listener.accept().await?;
        let permit = semaphore.clone().acquire_owned().await?;
        let config = config.clone();
        tokio::spawn(async move {
            let _permit = permit;
            if let Err(e) = handle_connection(stream, config).await {
                eprintln!("连接 {} 处理异常: {}", addr, e);
            }
        });
    }
}
#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error + Send + Sync>> {
    let config = ServerConfig {
        max_connections: 10000,
        read_buffer_size: 8192,
        write_timeout: Duration::from_secs(10),
    };
    run_server(config).await
}
这段代码保留了典型的 Tokio 服务端结构:
- 监听地址是
0.0.0.0:8080。 - 最大并发连接数通过
Semaphore控制为10000。 - 读缓冲区大小是
8192字节。 - 读取加了
Duration::from_secs(30)超时保护。 - 写回超时使用配置项中的
Duration::from_secs(10)。
这里最值得注意的不是 tokio::spawn 本身,而是 Semaphore 的背压作用。每个新连接都要先拿到一个 permit,任务结束后 permit 自动释放。这比“无限接入然后等系统扛不住”更适合作为生产环境默认策略。
另一个工程上很实用的细节,是对 read 和 write_all 分别套上 tokio::time::timeout。在网络服务里,真正拖垮资源的往往不是高峰流量,而是长时间不释放的慢连接。超时机制本质上是在用时间约束换资源稳定性。
io_uring 后端示例
use tokio_uring::net::TcpListener;
use tokio_uring::buf::IoBufMut;
async fn handle_connection_uring(
    stream: tokio_uring::net::TcpStream,
) -> Result<(), Box<dyn std::error::Error + Send + Sync>> {
    let buffer = vec![0u8; 8192];
    loop {
        let (n, buffer) = stream.read(buffer).await?;
        if n == 0 {
            break;
        }
        let (n, buffer) = stream.write_all(buffer[..n]).await?;
        drop(buffer);
    }
    Ok(())
}
#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error + Send + Sync>> {
    let listener = TcpListener::bind("0.0.0.0:8081").await?;
    println!("io_uring 服务启动");
    loop {
        let (stream, addr) = listener.accept().await?;
        tokio_uring::spawn(async move {
            if let Err(e) = handle_connection_uring(stream).await {
                eprintln!("连接 {} 处理异常: {}", addr, e);
            }
        });
    }
}
这段代码展示的是另一种思路:监听地址改为 0.0.0.0:8081,并使用 tokio_uring 来直接对接 io_uring 后端。
和 Tokio 常规异步 I/O 相比,这里最需要留意的是 buffer 的所有权模型。原文强调,io_uring 模式下 buffer 需要通过 IoBufMut 注册,因为内核要固定 buffer 地址,才能支持直接 DMA。也正因如此,read 和 write 完成时,会把 buffer 的所有权一并返回给调用方,而不是沿用传统 &mut [u8] 那套借用方式。
这类接口设计看上去比普通 Tokio 更“别扭”,但它反映的是底层机制差异:为了减少拷贝和调用开销,运行时必须更明确地管理内存位置与生命周期。对开发者来说,性能收益和心智负担通常是一起到来的。
高性能之外,Rust 异步 I/O 还要付出哪些工程代价
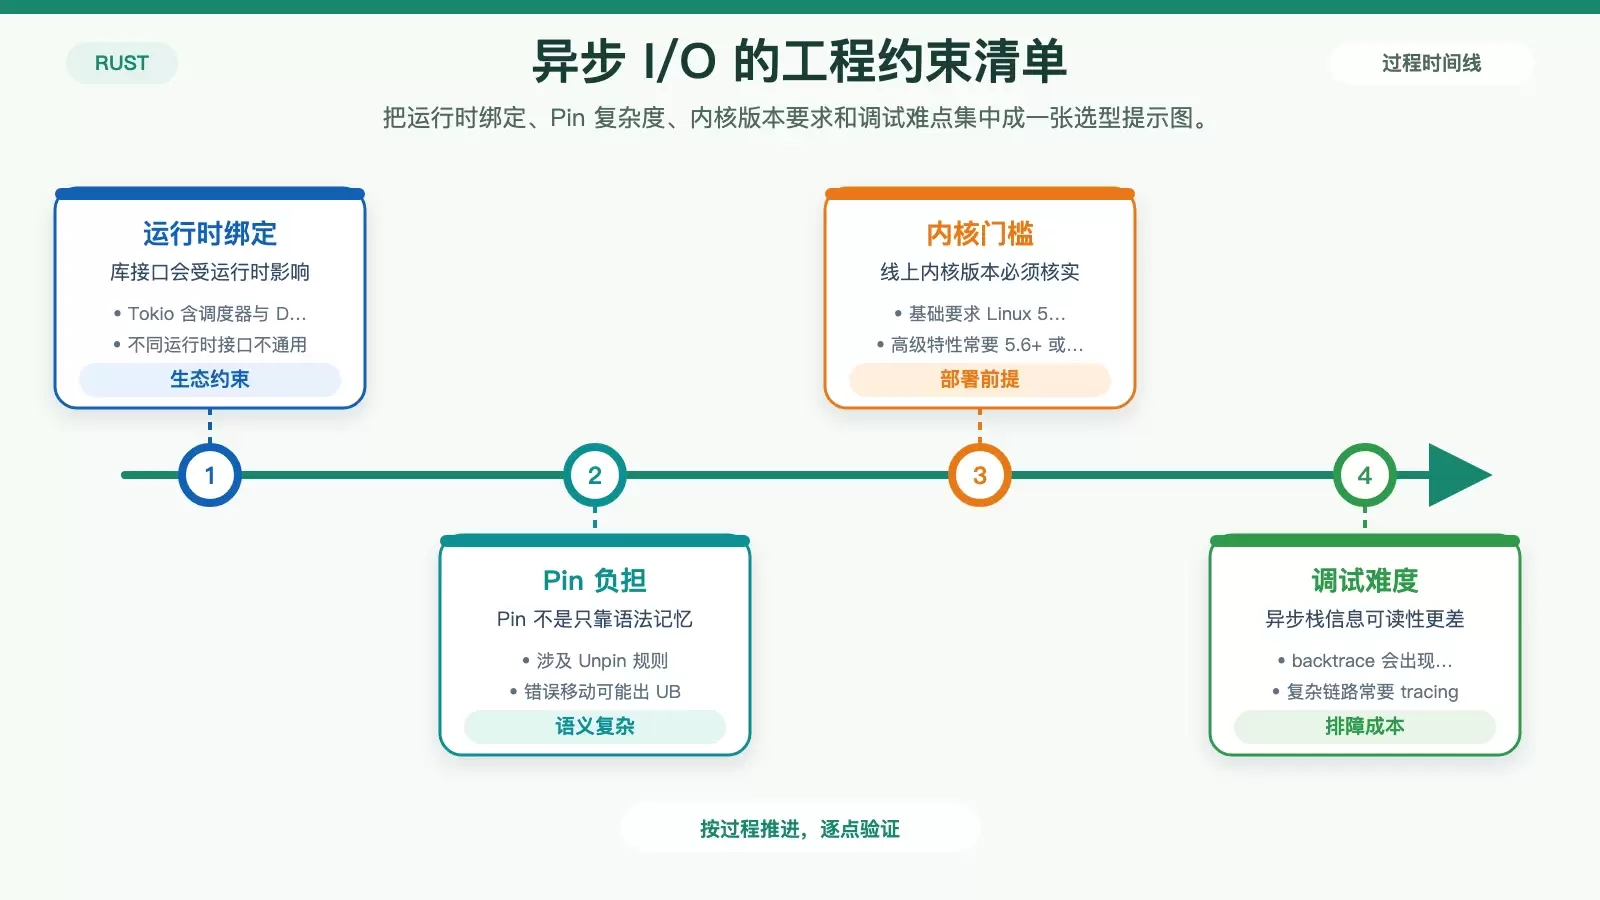
Rust 异步 I/O 的优势很明显,但把它放进真实项目时,不能只看压测数字。它的代价主要集中在运行时绑定、类型系统复杂度、部署前提和调试体验上。
运行时绑定不是小问题
Tokio 并不是一个只有事件循环的轻量组件,而是一整套运行时基础设施,包含任务调度器、I/O Driver、定时器堆等。项目一旦围绕 Tokio 写开,很多能力都会自然依赖它的生态接口。
这在应用层通常问题不大,但对库作者会更敏感。比如一个库如果直接暴露依赖特定运行时行为的 async fn 接口,下游就可能被迫接受同一套运行时选择;原文给出的例子是,Tokio 的 spawn 无法在 async-std 运行时中工作。
因此,涉及公共库设计时,更稳妥的思路往往不是急着暴露具体运行时能力,而是优先保持接口抽象边界清晰,把运行时选择权尽量留给下游。
Pin 的认知负担确实高
Pin 是 Rust 异步模型正确性的基础,但也是很多人真正卡住的地方。只会使用 async/await 不等于理解了 Future;一旦要手写自定义 Future、处理自引用结构体,或者面对底层库中的固定地址约束,Pin、Unpin 和安全不变量就绕不过去。
这部分难点不是语法,而是规则一旦用错,后果可能非常严重。原文特别提到:如果违反 Pin 契约,例如在 Pin<&mut T> 上调用 mem::swap,就可能进入未定义行为,而这类问题编译器也无法保证都在编译期拦住。
io_uring 有明确的内核门槛
io_uring 并不是“开箱即用的通用加速器”。它要求 Linux 5.1+ 内核,而一些高级能力,例如固定文件描述符、注册 buffer,则需要 5.6+ 甚至 5.10+。
在容器化部署中,这个问题会更现实,因为能否使用并不只取决于镜像环境,还取决于宿主机内核版本。如果线上环境不满足条件,就必须回退到 epoll 后端。也就是说,想吃到 io_uring 的性能红利,往往要同时接受额外的能力检测、兼容路径和部署验证成本。
异步调用栈更难读
同步代码出问题时,backtrace 通常能比较直接地反映调用路径;异步代码则不同,经过状态机改写后,栈信息里会出现大量编译器生成的中间类型,问题定位常常没那么直观。
Tokio 确实提供了 #[track_caller] 和 RUST_BACKTRACE=full 这类辅助手段,但在复杂异步链路里,很多团队最终还是要依赖 tracing 框架做链路追踪,才能把“哪一个任务、在哪一段 await、因为什么被卡住”真正串起来。
怎么选型更稳:epoll 先上,io_uring 按场景加
把前面的机制、代码和代价放在一起看,Rust 异步 I/O 的定位其实很清楚:它通过编译器生成状态机,给出了接近手写状态机性能的协程抽象,让高并发服务既能保留较好的代码结构,又不会轻易掉进线程模型的资源陷阱。
在后端选择上,epoll 依然是通用场景下更稳妥的基础方案,成熟、兼容性好、调试手段也更完整;io_uring 则更适合 I/O 极其密集、对系统调用开销敏感的高吞吐短连接场景。原文给出的经验值是:通过减少系统调用,I/O 路径的 CPU 占用可降低 30%-50%。
因此,更实际的落地建议是:
- 新项目优先用 Tokio +
epoll,先把稳定性、生态和可维护性拿到手。 - 确认内核版本满足要求,且性能瓶颈确实落在 I/O 路径后,再考虑引入
tokio-uring做针对性优化。 - 在库设计层面,优先暴露基于
Futuretrait 的接口,而不是过早把运行时选择写死在公开 API 上。
换句话说,Rust 异步 I/O 的重点从来不只是“更快”,而是你能不能判断:当前瓶颈到底是不是线程切换、系统调用和 I/O 路径本身;如果不是,再先进的异步模型也不会自动替你解决所有问题。









