


CentOS 上的 Rust 项目要想真正做到可恢复,不能只备份源码目录。除了代码本身,依赖锁定文件、数据库导出文件以及环境配置也必须一起保存,恢复时才能尽量接近原来的运行状态。下面按“备份什么、怎么恢复、哪些地方最容易出错”三个层次展开,方便你把这套流程直接落到服务器维护里。
备份时必须覆盖的 4 类内容
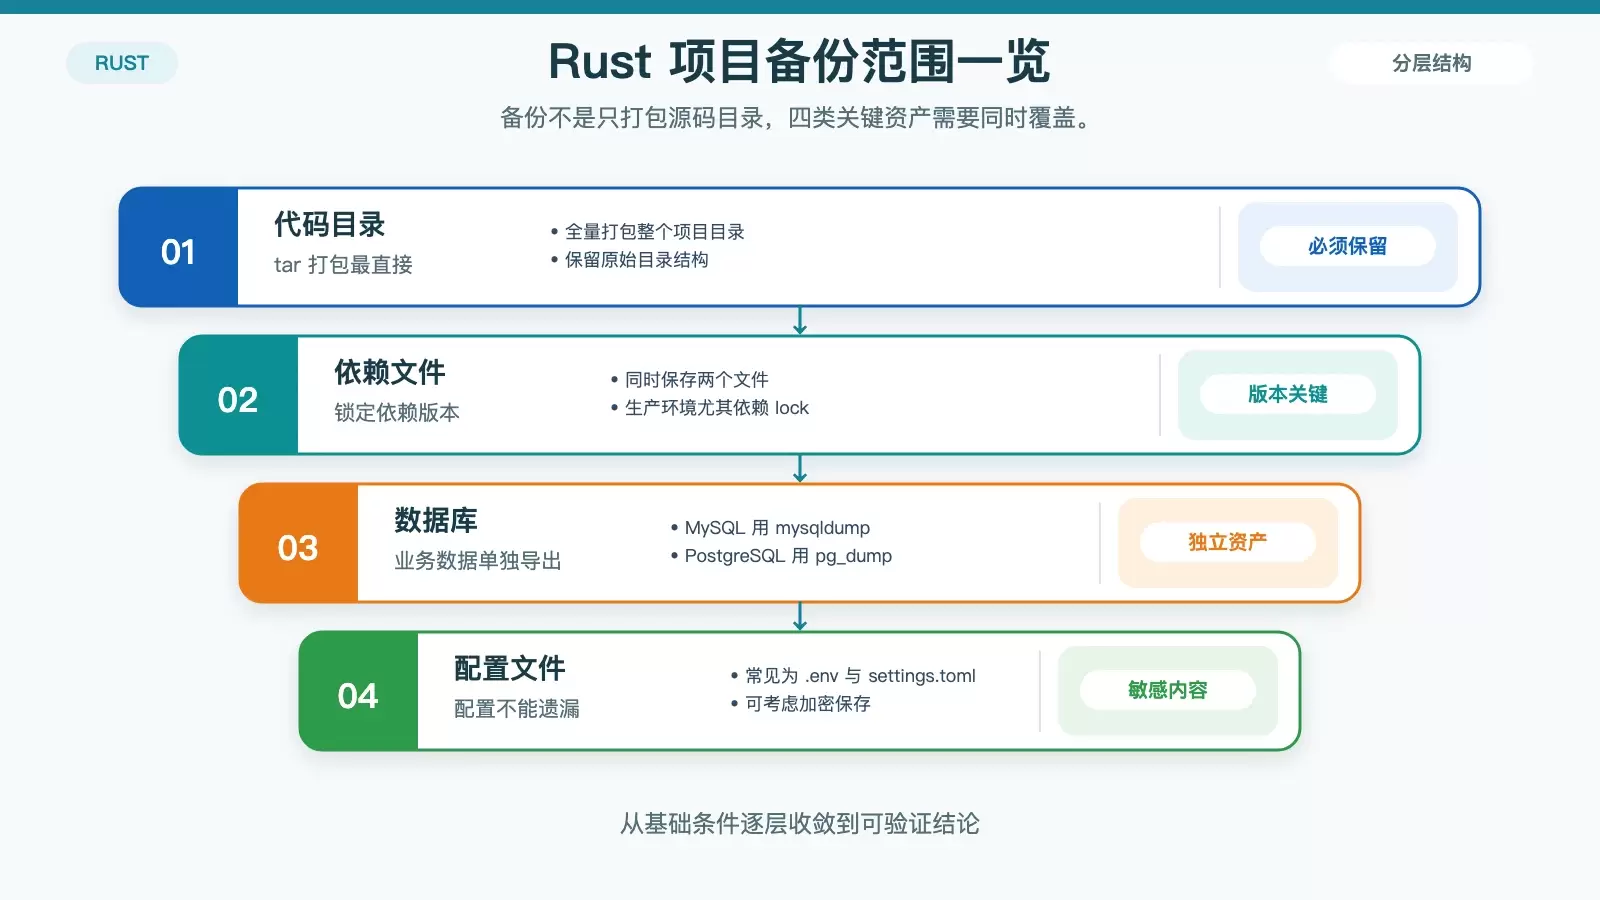
Rust 项目在 CentOS 上运行时,至少有四类内容需要纳入备份范围:代码、依赖、数据库和配置文件。少掉其中任何一项,恢复出来的项目都可能只能“看起来完整”,却无法真正编译或运行。
代码目录:先保证项目文件结构完整
最直接的做法是使用 tar 对整个项目目录做一次全量打包,这样目录结构、源码文件和常见资源文件都会一并保留下来:
tar -czvf project_backup.tar.gz /path/to/your/project这条命令适合大多数场景,优点是简单、完整、恢复时也容易还原原始目录结构。如果你对备份体积或内容范围有更细的要求,也可以只打包指定目录,但从稳定性角度看,全量打包通常更省心。
依赖文件:Cargo.toml 和 Cargo.lock 都要单独留存
Rust 项目的依赖信息主要由 Cargo.toml 和 Cargo.lock 两个文件控制。前者定义依赖,后者锁定具体版本。尤其在服务器环境里,Cargo.lock 是否保留,往往决定了恢复后能否得到一致的构建结果。
cp Cargo.toml Cargo.lock /path/to/backup/location如果只保留 Cargo.toml,恢复后重新拉取依赖时可能拿到更新版本,结果就会出现“项目能下载依赖,但构建结果与原环境不一致”的问题。生产环境备份里,这两个文件都不应缺席。
数据库:有状态数据必须单独导出
如果你的 Rust 项目连接了 MySQL、PostgreSQL 等数据库,那么项目目录的压缩包并不能覆盖业务数据。以 MySQL 为例,可以使用 mysqldump 导出数据库:
mysqldump -u username -p database_name > database_backup.sql如果使用 PostgreSQL,则应改用 pg_dump。这里的核心不是工具名称,而是要把数据库视为与源码并列的重要资产。实践中,数据库备份文件最好与代码压缩包分开存放,便于管理,也能降低单点损坏带来的风险。
配置文件:决定项目能否连上外部环境
很多 Rust 项目会使用 .env、settings.toml 之类的配置文件,它们通常保存数据库连接串、服务地址、API 密钥或运行参数。这类文件如果缺失,哪怕代码和数据库都恢复成功,应用也未必能启动。
cp .env settings.toml /path/to/backup/location由于配置中常常包含敏感信息,如果这些文件没有进版本控制,备份时就更要单独确认;如果已经纳入 Git 等版本控制,也要注意敏感字段不要明文泄露,必要时应配合加密存储。
恢复流程怎么走,才能尽快把项目拉起来
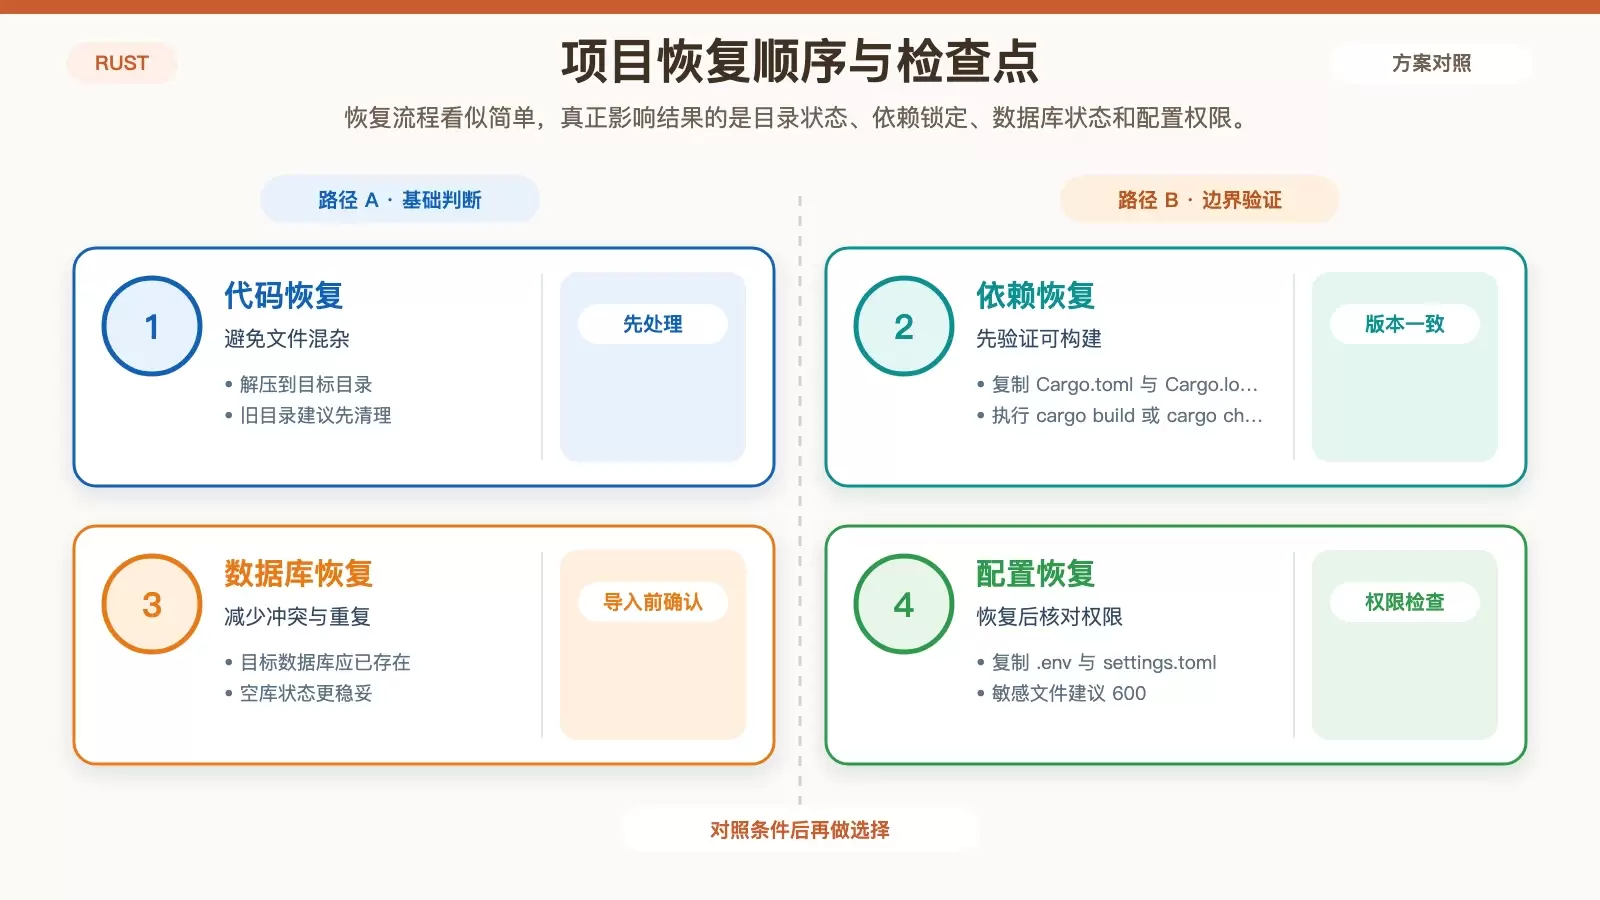
恢复过程基本上是备份动作的逆向执行,但真正影响结果的,往往是目标目录是否干净、依赖版本是否锁定、数据库是否提前准备好,以及配置文件权限是否正确。
恢复代码:先解压到明确的目标位置
代码恢复通常从解压备份包开始:
tar -xzvf project_backup.tar.gz -C /path/to/target/location如果目标目录已经存在旧文件,建议先清理干净,或者直接换到新的目录中恢复。这样做的目的,是避免旧文件与备份内容混在一起,导致排查问题时难以分辨哪些是新恢复的内容、哪些是历史残留。
恢复依赖:复制锁文件后执行构建
将备份好的 Cargo.toml 和 Cargo.lock 放回项目目录后,可以通过 cargo build 或 cargo check 验证依赖是否能够被正确解析:
cp /path/to/backup/location/Cargo.toml Cargo.lock /path/to/your/project
cargo build
Cargo.lock 在这一步的价值很明显:它能让 Cargo 按原来的锁定版本下载依赖,避免恢复时出现意外升级。若你只是想先验证依赖和语法是否完整,cargo check 也可以作为更轻量的检查方式。
恢复数据库:导入前先确认目标库状态
数据库恢复通常是将导出的 SQL 文件重新导入到目标数据库中:
mysql -u username -p database_name < database_backup.sql这里最需要注意的是,目标数据库最好提前创建好,并尽量保证为空库状态。否则在已有表结构或旧数据的情况下导入,容易触发主键冲突、重复数据或结构不一致等问题。对于结构较复杂的项目,先在测试环境完整导入一遍,会比直接上生产环境稳妥得多。
恢复配置:复制完成后别忘了检查权限
配置文件恢复本身很简单,关键在恢复后的权限和内容确认:
cp /path/to/backup/location/.env /path/to/your/project
cp /path/to/backup/location/settings.toml /path/to/your/project
尤其是 .env 这类文件,恢复后建议立即检查权限,避免敏感信息被不必要地暴露。原文提到将其设置为 600 权限,这在多用户服务器场景里尤其重要。
实战中最容易忽略的几个点
只会执行备份和恢复命令还不够,真正决定这套方案是否可靠的,往往是日常维护习惯。
版本控制负责追踪,备份负责兜底
把代码放进 Git 或 SVN 这类版本控制系统,能解决历史追踪、差异比较和快速回滚的问题。备份文件则更像灾难恢复手段,两者职责不同,不能互相替代。对于 Rust 项目来说,版本控制管源码变化,备份负责在服务器损坏、误删文件或环境迁移时兜底。
定期备份之外,还要验证备份可用性
通过 cron 任务每天或每周自动备份是常见做法,但自动化不等于可靠。备份文件生成成功,只能说明任务跑完了,不能说明文件一定完整、可解压、可导入、可构建。真正稳妥的做法,是定期抽样检查备份包和数据库导出文件,确认它们确实能用于恢复。
恢复流程一定要在测试环境先走一遍
很多问题只有在恢复动作真正执行时才会暴露出来,比如路径填写错误、数据库权限不足、目标环境缺少依赖、锁定版本无法拉取,或者配置文件内容与新环境不匹配。提前在测试环境演练一次,可以把这些问题留在可控范围内,而不是等线上故障发生后再临时排查。
一套能落地的 CentOS Rust 备份思路
总结来看,CentOS 上的 Rust 项目备份与恢复并不复杂,关键是别把它理解成“只压缩一个项目目录”。代码决定项目主体,Cargo.toml 与 Cargo.lock 决定依赖一致性,数据库决定业务状态,配置文件决定项目能否接入原有运行环境。
只要这四部分一起纳入备份,并在恢复时按顺序验证代码、依赖、数据库和配置,整个流程就会清晰很多。对线上项目来说,真正有价值的不是“做过备份”,而是你能不能在需要时把项目完整、稳定地恢复出来。









