


很多人提到 Rust 安全,第一反应都是“它天生就更安全”。这话没错,但放到 Debian 服务器上,真正决定结果的往往不只是编译器,还包括系统配置、依赖更新和运行期审计。下面按“语言机制、系统加固、项目实践”三层来拆解,帮助你判断哪些措施是基础项,哪些才是把安全做扎实的关键动作。
Rust 自带的安全机制,能解决哪些核心问题
Rust 之所以在系统编程领域被反复讨论,核心原因是它把很多常见风险前移到了编译阶段处理,而不是等程序上线后再靠排查和补救。
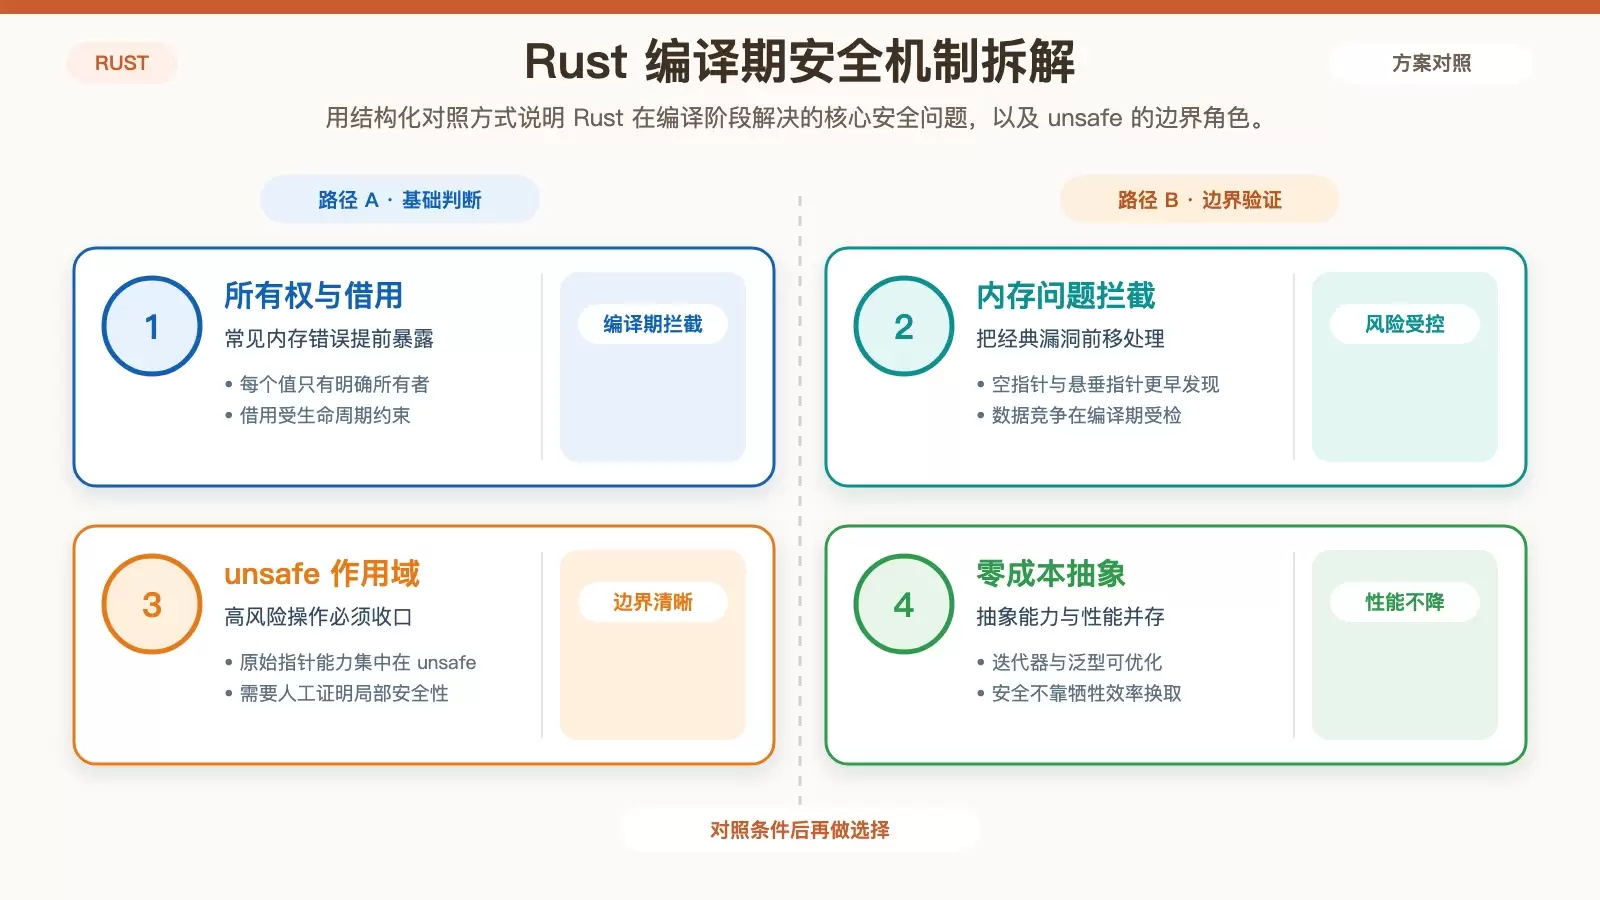
所有权与借用把常见内存错误拦在编译期
Rust 的所有权与借用系统,本质上是在强制数据访问规则:每个值只有一个明确的所有者,借用必须遵守生命周期约束。这样一来,数据竞争、空指针解引用、悬垂指针等经典问题,往往在代码还没运行前就会被编译器指出。
这也是 Rust 和传统 C/C++ 项目在安全治理上的一个明显差异。很多在后者里需要靠人工代码审查、运行时检查工具甚至线上事故才暴露的问题,在 Rust 里通常会更早出现,而且错误边界更清楚。
unsafe 不是禁区,但必须被严格收口
Rust 并不是完全不允许底层操作,而是把高风险能力集中放进 unsafe 代码块。安全代码默认不能随意操作原始指针,也不能绕过编译器的关键约束,这就减少了因内存误用导致的漏洞入口。
真正需要注意的是,unsafe 并不等于“不安全”,而是表示“这部分安全性需要开发者自己证明”。因此在 Debian 环境部署 Rust 服务时,unsafe 最好控制在少量、可审计、带注释说明的局部区域,而不是扩散到业务逻辑里。
安全和性能不必二选一
Rust 的零成本抽象,让迭代器、泛型等高级特性能在编译后被优化成接近 C++ 水平的机器码。对服务端程序来说,这一点很重要,因为它意味着你不需要靠牺牲安全边界去换取性能表现。
换句话说,Rust 提供的是一种更适合长期维护的起点:在不明显增加运行开销的前提下,把大量内存安全问题提前消化掉。
Debian 侧要补上的安全加固项
Rust 能保证程序本身少踩内存坑,但服务最终还是跑在 Debian 上。系统默认配置通常偏向通用可用,而不是面向公网暴露场景的强加固状态,所以主机层面仍然要做基本收口。
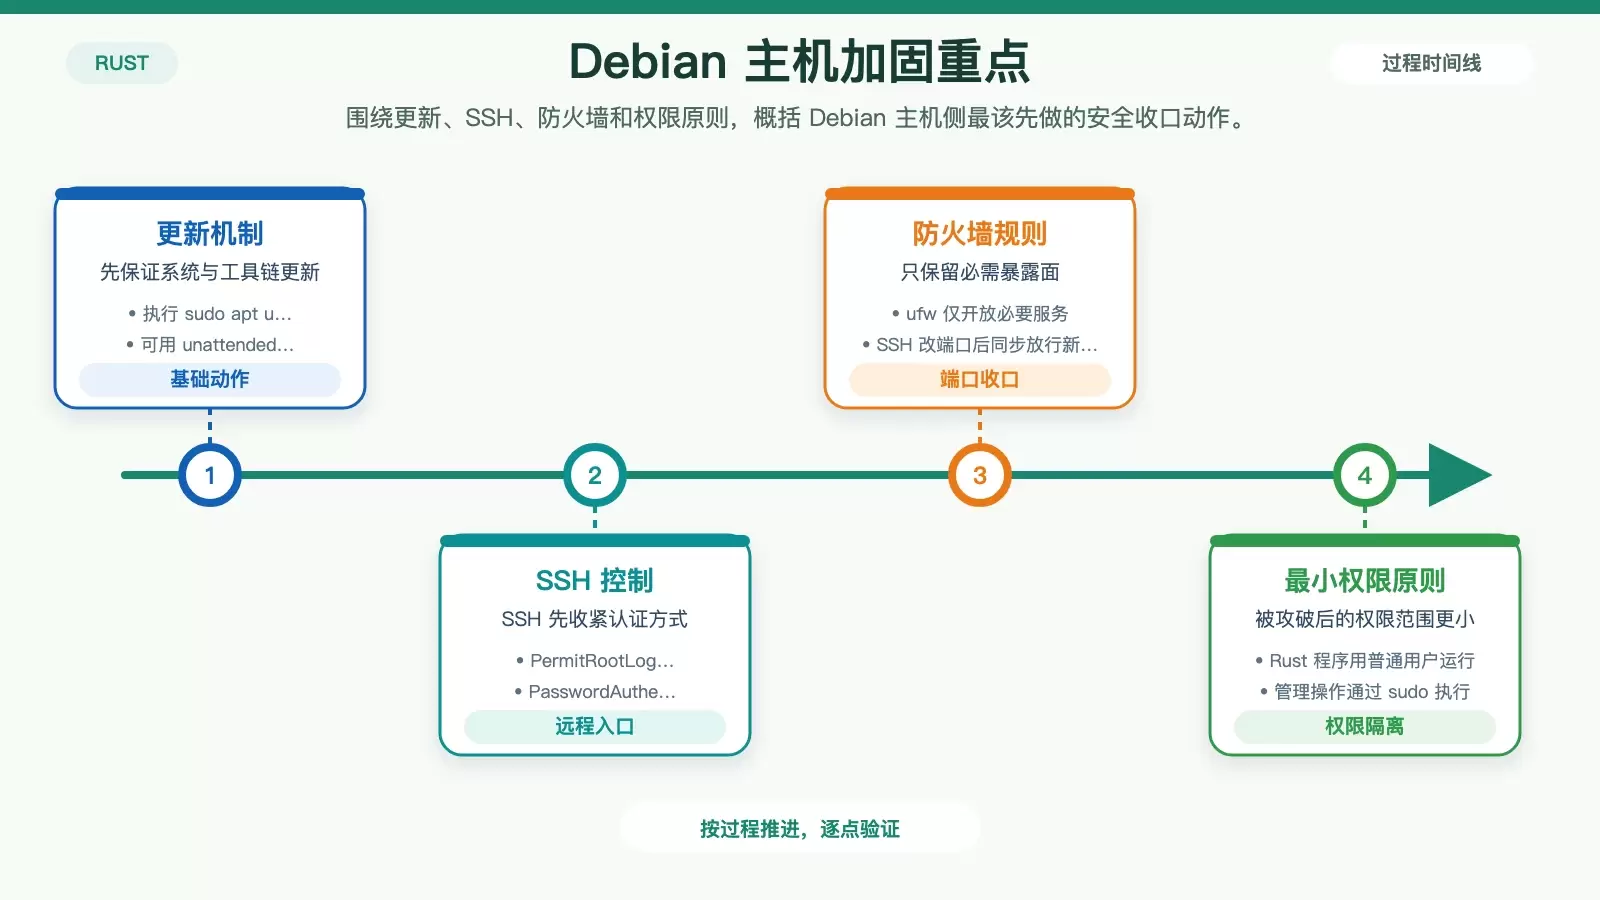
先把系统和工具链更新机制建立起来
最基础的一步,是定期更新系统与依赖。常用命令仍然是:
sudo apt update && sudo apt upgrade -y如果希望减少人工维护压力,可以使用 unattended-upgrades 自动安装安全补丁。这里不仅包括 Debian 本身的补丁,也包括 Rust 工具链和常用库的版本维护,比如 rustc、cargo 以及 serde、tokio 等项目常见依赖。很多已知漏洞的修复,第一时间就是通过更新落地的。
SSH 访问控制必须先收紧
如果服务器允许远程登录,/etc/ssh/sshd_config 是必须检查的文件。比较关键的几项包括:
PermitRootLogin设为no,禁止 root 直接远程登录。PasswordAuthentication设为no,只保留密钥认证。- 按需修改默认端口,例如设置
Port 52222,降低自动化暴力扫描的命中率。
这里要注意,改端口并不是核心防线,它只能减少噪声;真正有效的还是禁用 root 直登和关闭密码认证。也就是说,端口调整是辅助项,认证方式收紧才是主项。
防火墙和权限边界要跟着服务一起收口
Debian 上很常见的做法是用 ufw 只开放必要端口,例如 SSH、80、443。示例命令如下:
sudo ufw allow OpenSSH && sudo ufw enable如果 SSH 已经改端口,就应同步放行新端口,而不是继续保留默认 22 端口的暴露面。Web 服务也同样遵循最小开放原则,不需要的端口不要留下。
同时,Rust 程序本身应尽量以普通用户身份运行,管理操作通过 sudo 完成,而不是直接让服务进程带着 root 权限启动。这样即使应用层出现问题,攻击者可利用的系统权限也会被压缩在较小范围内。
Rust 项目开发与运维阶段,重点盯哪些环节
语言和系统只是底盘,项目真正长期暴露出来的风险,往往还是出在依赖管理、编码习惯和上线后的可观测性上。这部分做不好,前面的优势也会被抵消。
依赖版本要明确,漏洞扫描要常态化
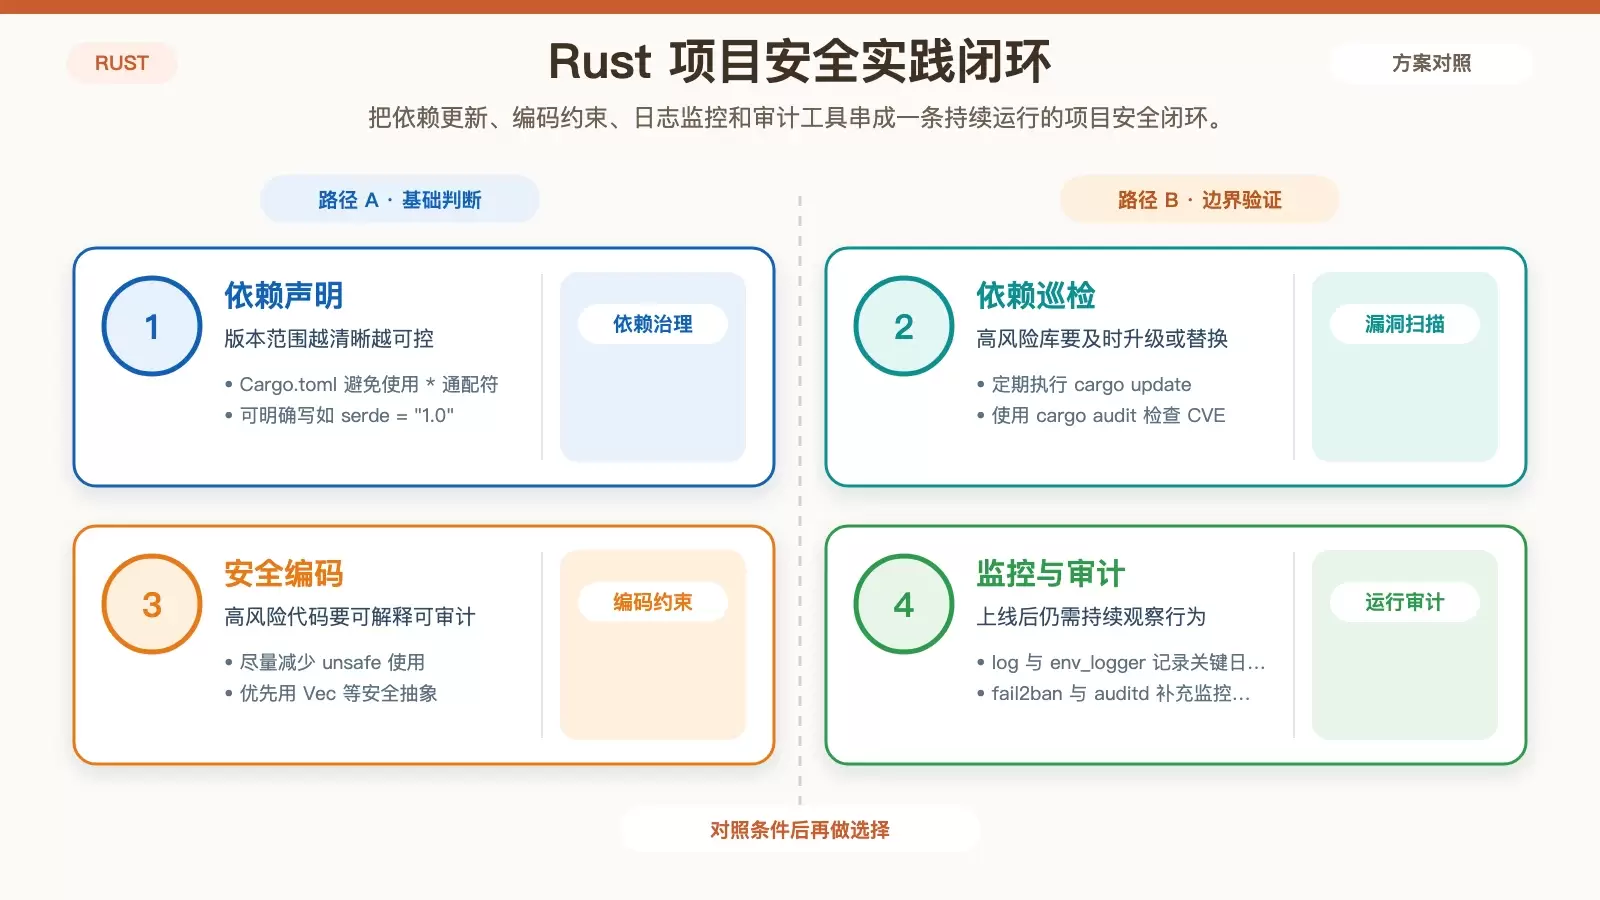
在 Cargo.toml 中,依赖版本应尽量写得明确,例如:
serde = "1.0"不要直接使用 * 这样的通配符。版本范围过宽,会让构建结果变得不可控,也会增加引入不兼容更新或已知漏洞版本的概率。
日常维护里,可以定期执行 cargo update 更新依赖,并使用 cargo audit 扫描已知漏洞(CVE)。如果某个库被标记为高风险,优先处理方式通常是升级;如果上游长期无人维护,再考虑替换成维护更活跃、社区反馈更快的库。
编码时少碰高风险能力,把验证逻辑写清楚
Rust 并不会自动让所有代码都安全,尤其是在项目引入底层优化、FFI 或特殊内存操作时,unsafe 仍然可能成为薄弱点。所以实践上应遵循两个原则:一是尽量少用,二是用了就把边界和理由写清楚。
在普通业务开发里,也应优先使用 Rust 已经提供的安全抽象,例如用 Vec 替代裸指针数组,通过所有权模型和标准容器降低内存泄漏、越界访问和生命周期错误的概率。这样的收益很直接:代码更容易审计,也更容易交接维护。
上线后要有日志、封禁和审计三道补位措施
运行期安全的重点不只是“有没有报错”,而是出了异常能不能尽快发现、定位并止损。Rust 项目可以通过 log 和 env_logger 记录关键日志,例如启动信息、异常栈和重要错误路径,方便后续排查。
如果服务跑在对外开放的 Debian 主机上,可以再配合 fail2ban 监控 SSH 登录日志,自动封禁多次失败的 IP。进一步需要系统级追踪时,则可用 auditd 记录关键系统调用,用来确认程序是否出现了超出预期的行为。
这几项工具并不能替代编码安全和系统加固,但它们能明显提升发现问题和追踪问题的能力。对线上环境来说,这种“可看见、可定位、可追责”的能力,本身就是安全体系的一部分。
把三层措施叠起来,才是 Debian 上 Rust 的完整安全方案
回到最初的问题:Debian 环境下,Rust 的安全性如何保障?答案不是依赖某一项单点能力,而是三层协同。
- Rust 语言层,负责把大量内存安全问题前移到编译阶段。
- Debian 系统层,负责收紧远程入口、端口暴露和权限边界。
- 项目与运维层,负责依赖治理、风险编码控制以及运行期监控审计。
只有把这三层叠起来,Rust 的“安全基因”才能真正落到 Debian 的实际生产环境中。单看语言特性,结论通常会过于乐观;把系统和运维一起纳入,才更接近真实的安全水平。









