


日志配置在 Rust 服务里往往不是“能打出来就行”这么简单。开发阶段要看得清,生产阶段要稳得住,接入 ELK、Loki 或 OpenObserve 这类平台时还得方便检索和聚合。下面按“从本地调试到生产运维”的顺序梳理一遍,帮助你判断什么时候该用 env_logger,什么时候该上 log4rs,以及结构化日志适合放在哪一步。
先搭起最基础的日志输出:log + env_logger
如果你只是想让 Rust 程序先具备统一的日志接口,通常从 log 和 env_logger 这组组合开始就够了。
为什么先用 log 门面
log 是 Rust 生态里最常见的日志门面库,提供了 info!、error!、debug!、warn!、trace! 这些宏。业务代码只负责调用这些宏,至于日志最终输出到终端、文件还是其他地方,交给底层实现决定。
env_logger 则是这一层实现里最常用的入门方案,默认输出到终端,适合本地开发和命令行程序排错。
基础启用方式
- 在
Cargo.toml里加入log = "0.4"和env_logger = "0.10"。 - 在
main.rs里调用env_logger::init()。 - 默认只输出
info及以上级别的日志,例如info!("Program started")。
这里的版本号应以 Crates.io 上的最新可用版本为准,但原始示例使用的是 0.4 和 0.10。
用 RUST_LOG 动态控制级别
这套方案最方便的地方,是无需改代码就能调整输出级别。通过环境变量 RUST_LOG,可以在不同阶段切换日志详细程度:
RUST_LOG=debug cargo run:输出debug及以上级别日志。RUST_LOG=error cargo run:只输出错误日志。
这对于开发阶段非常实用,既能减少重复编译,也能避免为了临时排查把调试代码写死在程序里。
默认输出不够看时,改成带时间戳的自定义格式
终端日志只靠一行纯文本时,排查问题很容易缺少上下文。比较常见的增强方式,是在每条日志里补上时间戳和级别,让人一眼看出发生时间和严重程度。
使用 Builder 定制 env_logger 输出
这里可以继续沿用 env_logger,通过 Builder 自定义格式。示例里还加入了 chrono = "0.4" 用来生成时间戳。
use env_logger::Builder;
use log::Level;
use chrono::Local;

fn main() {
    Builder::from_env(env_logger::Env::default().default_filter_or("info"))
        .format(|buf, record| {
            writeln!(buf,
                "{} [{}] - {}",
                Local::now().format("%Y-%m-%d %H:%M:%S"), // 时间戳
                record.level(),                          // 日志级别
                record.args()                            // 日志内容
            )
        })
        .init();
    info!("Custom formatted log");
}
输出结果类似:
2025-09-29 14:30:00 [INFO] - Custom formatted log这种格式适合什么场景
如果你的程序主要在 Linux 终端、systemd 日志或容器标准输出里观察运行状态,这种格式已经比默认输出更适合排障。它保留了轻量方案的简单性,又把线上最常用的几个关键信息补齐了。
进入生产环境后,重点看文件轮转和分级:log4rs
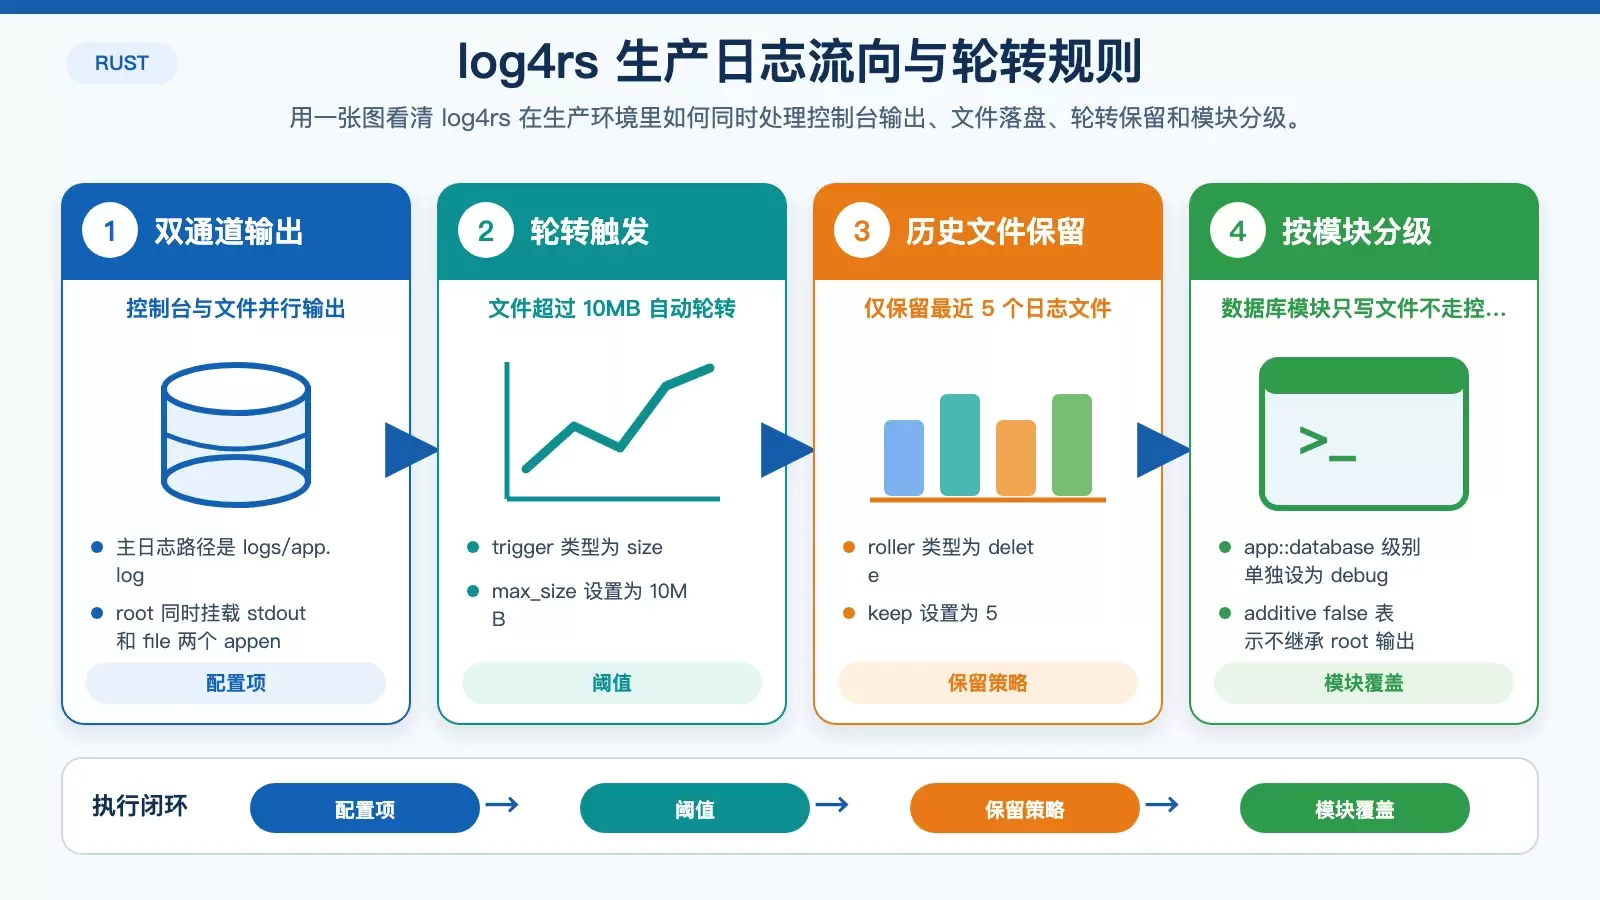
到了生产环境,终端输出通常不再够用。你往往需要把日志落盘、控制文件大小、保留历史文件,并且允许不同模块使用不同日志级别。这时 log4rs 会比 env_logger 更合适。
log4rs 解决了哪些问题
log4rs 的定位更接近成熟应用日志系统,支持:
- 输出到控制台和文件;
- 日志文件轮转;
- 按模块设置不同级别;
- 通过配置文件集中管理规则。
原文把它类比为 Java 里的 Logback,这个理解基本准确:它更适合长期运行的服务程序,而不是单纯的本地调试。
一个可直接理解的 log4rs.yaml 示例
下面这份 log4rs.yaml 展示了控制台输出、滚动文件、大小触发轮转和模块级别覆盖:
refresh_rate: 30 seconds # 配置刷新间隔
appenders:
  stdout:
    kind: console
  file:
    kind: rolling_file
    path: "logs/app.log"
    policy:
      compound # 复合策略(大小+时间)
      trigger:
        kind: size
        max_size: 10MB
      roller:
        kind: delete
        keep: 5 # 保留最近5个文件
    encoder:
      pattern: "{d(%Y-%m-%d %H:%M:%S)} [{l}] {m}{n}" # 格式:时间+级别+内容
root:
  level: info
  appenders:
    - stdout
    - file
loggers:
  app::database:
    level: debug
    appenders:
      - file
    additive: false # 不继承root的appender
这份配置的关键点有三个:
- 主日志写入
logs/app.log; - 单个文件超过
10MB时触发轮转; - 仅保留最近
5个文件。
此外,app::database 模块被单独设置为 debug 级别,而且只输出到文件,不继承 root 的 appender。
代码里如何初始化
use log::info;

fn main() {
    log4rs::init_file("config/log4rs.yaml", Default::default()).unwrap();
    info!("This log will be written to file and console");
    // 数据库模块日志(debug级别,仅输出到文件)
    log::logger().with_max_level(Level::Debug)
        .log(&log::Record::builder()
            .module_path(Some("app::database"))
            .args(format_args!("Database connected"))
            .build()
        );
}
按这个示例运行后,日志会同时写入控制台和 logs/app.log;当日志量增长到阈值后,系统自动进行轮转,对日常运维已经比较够用。
需要接入 ELK、Loki 时,优先考虑结构化日志
如果日志最终会进入集中式分析平台,那么只输出人能读的自由文本还不够。结构化日志的优势在于字段明确,后续做检索、过滤、聚合都更直接。
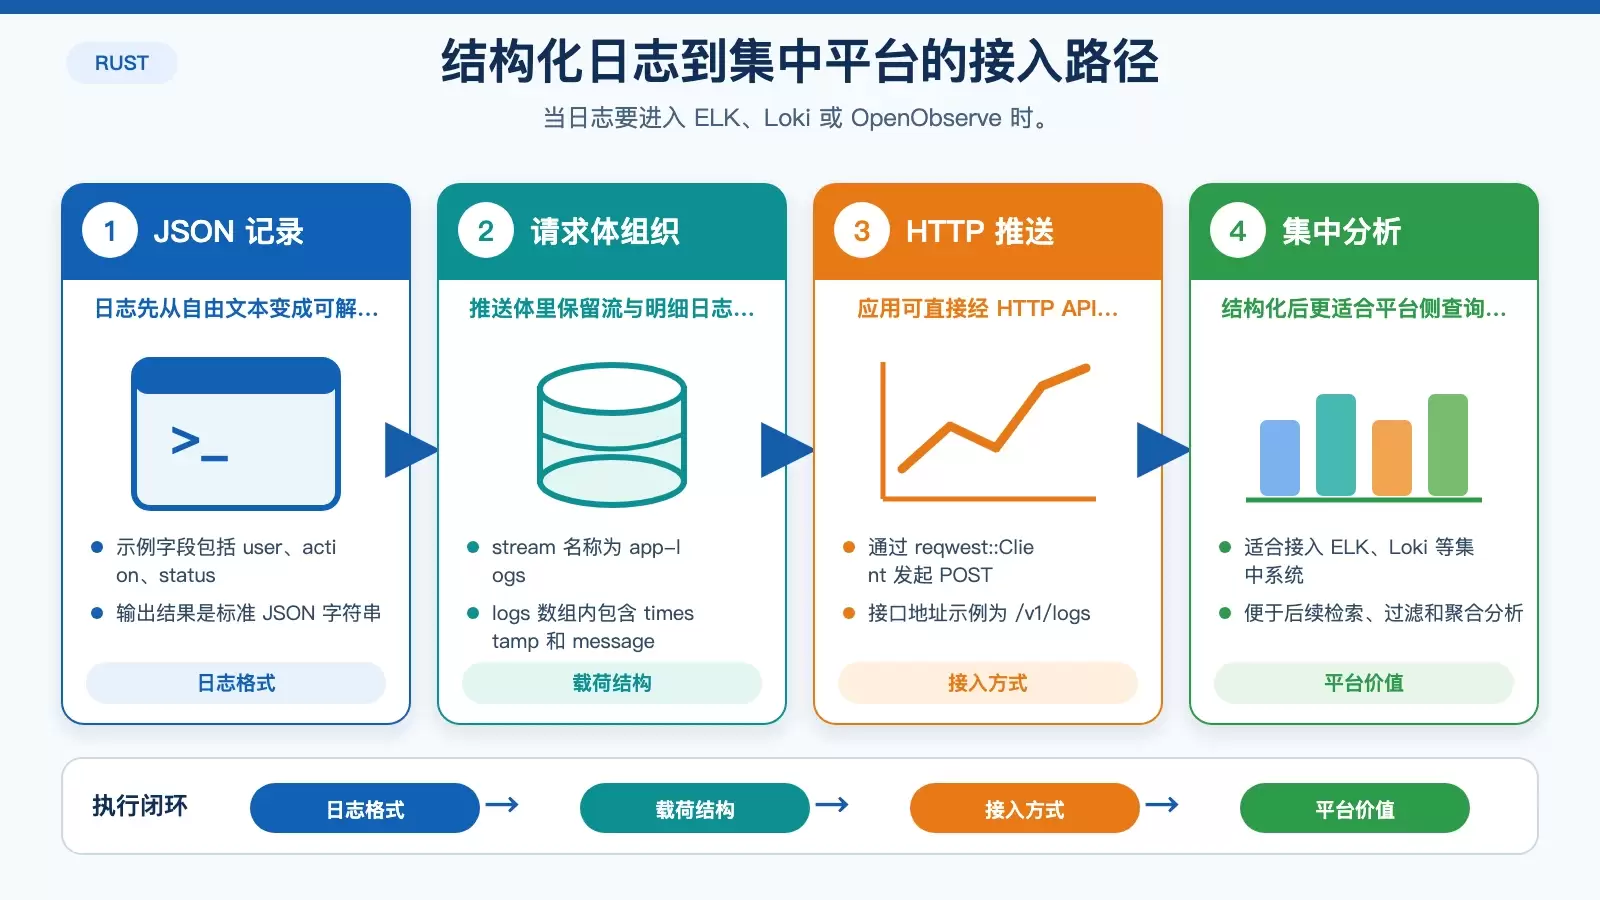
先把日志写成 JSON
原文示例使用 serde_json 生成 JSON 日志:
use log::info;
use serde_json::json;

fn main() {
    let user = "Alice";
    let action = "login";
    info!("{}", json!({
        "user": user,
        "action": action,
        "status": "success"
    }));
}
输出为:
{"user":"Alice","action":"login","status":"success"}这种格式的价值,不在于“更好看”,而在于日志平台可以稳定地提取 user、action、status 这些字段,用于查询和统计。
再通过 HTTP API 推送到云原生日志平台
如果使用 OpenObserve 这类平台,还可以直接调用 HTTP API 推送日志:
use reqwest::Client;
use serde_json::json;

#[tokio::main]
async fn main() -> Result<(), reqwest::Error> {
    let client = Client::new();
    let log_data = json!([
        {
            "stream": "app-logs",
            "logs": [{"timestamp": "2025-09-29T14:30:00Z", "message": "User logged in"}]
        }
    ]);
    client.post("http://openobserve-api.yourdomain.com/v1/logs")
        .body(log_data.to_string())
        .send()
        .await?;
    Ok(())
}
这里保留了原示例中的接口地址 http://openobserve-api.yourdomain.com/v1/logs 和时间戳 2025-09-29T14:30:00Z。前提是日志平台已经部署完成,例如原文提到可以通过 helm install 方式部署 OpenObserve。
开发、测试、生产环境的日志级别怎么定
日志不是越多越好,而是要和环境目标匹配。原文给出的分层方式比较实用,可以直接作为默认策略:
三类环境的推荐级别
- 开发环境:使用
debug或trace,尽量输出函数调用、变量值等细节,方便调试。 - 测试环境:使用
info,聚焦接口调用、数据库操作等关键流程,避免调试信息过多影响判断。 - 生产环境:使用
warn或error,重点保留异常和重要警告,减少磁盘占用与噪声。
怎么选更稳妥
如果你还没有形成完整日志体系,可以按下面的思路落地:
- 本地开发先用
log+env_logger; - 需要时间戳和更清晰排障信息时,继续基于
env_logger::Builder定制格式; - 服务准备上线时,切到
log4rs做文件输出、轮转和模块分级; - 需要集中检索、告警和聚合分析时,再把日志改成 JSON,并接入 ELK、Loki 或 OpenObserve。
这样做的好处是演进路径清楚,不会一开始就把日志系统堆得太重,也不会在生产阶段继续停留在只看终端输出的状态。









