


在 Debian 上开发 Rust 项目时,测试通常不是“最后补一下”的环节,而是从工具链安装、项目结构安排到自动化检查都要一起考虑。下面按实际使用顺序把整套流程拆开说明,既保留可直接执行的命令,也补上每一步为什么这么做,方便你判断当前项目应该先做到哪一层。
先把 Debian 上的 Rust 工具链装完整
要在 Debian 上顺利测试 Rust 项目,首先需要把编译器 rustc 和包管理工具 cargo 装好。最常见、也最省心的方式,是使用官方推荐的 rustup 来管理工具链。
在终端执行:
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh安装完成后,终端一般会提示你重启 shell,或者手动执行下面这条命令,把 Rust 相关路径加入当前环境:
source $HOME/.cargo/env接着可以用版本命令确认安装是否生效:
rustc --version  # 看看编译器版本
cargo --version  # 看看cargo版本
只要两条命令都能正常输出版本号,就说明 Debian 环境已经具备运行和测试 Rust 项目的基础条件。
进入现有项目,或先创建一个标准 Rust 项目
如果你手头已经有项目代码,直接进入项目目录即可;如果只是想先验证测试流程,可以先新建一个最小可用项目。
cargo new my_project  # 创建名为my_project的新项目(默认是库项目)
cd my_project         # 进入项目目录
cargo new 会自动生成标准目录结构,包括 src 目录和 Cargo.toml。这一步的意义不只是“快速起项目”,更重要的是让后续测试、构建和 CI 都能基于 Rust 默认约定工作,少做额外配置。
如果项目本身是可执行程序,也建议把核心逻辑尽量拆到 src/lib.rs 中,再由 src/main.rs 负责启动入口。这样测试会更容易组织,后面写单元测试时也更清晰。
Rust 测试代码应该写在哪里
Rust 常见测试大致分为三类:单元测试、集成测试和文档测试。日常开发中,最先接触的通常是单元测试,因为它直接跟随函数或模块走,定位问题也最快。
库项目通常直接在 src/lib.rs 里写单元测试
对于库项目,测试代码一般和被测代码放在同一个文件里,用 #[cfg(test)] 模块包起来,这样它只会在测试阶段编译。
// src/lib.rs
pub fn add(a: i32, b: i32) -> i32 {
    a + b
}

#[cfg(test)]  // 只在测试时编译此模块
mod tests {
    use super::*;  // 引入父模块的函数

    #[test]  // 标记为测试函数
    fn test_add_positive() {
        assert_eq!(add(2, 3), 5);
    }

    #[test]
    fn test_add_negative() {
        assert_eq!(add(-1, 1), 0);
    }
}
这里有三个关键点:
#[cfg(test)]用来限制模块只在测试时参与编译;#[test]把函数标记为可执行测试;assert_eq!用来比较预期结果和实际结果。
可执行项目建议把复杂逻辑移到 src/lib.rs
如果你测试的是一个可执行项目,逻辑上也能写测试,但更推荐把业务逻辑抽到 src/lib.rs,让 src/main.rs 保持轻量。这样做的好处是:测试不需要围着程序入口兜圈子,而是可以直接对函数、模块和边界条件下手。
用 cargo test 跑完整测试
测试代码准备好后,在项目根目录执行下面这条命令即可:
cargo testcargo test 会自动完成两件事:先编译项目和测试代码,再执行所有标记为 #[test] 的测试函数。运行结束后,你可以直接看到通过数量、失败数量以及失败原因。
下面几个参数在日常排查里很常用:
--nocapture:显示测试中的println!或dbg!输出;--test <name>:只运行指定名称的测试模块;--verbose:输出更详细的编译和测试过程。
如果只是想快速确认功能没回归,直接跑 cargo test 就够了;如果已经出现失败,再逐步加详细参数去缩小范围,效率会更高。
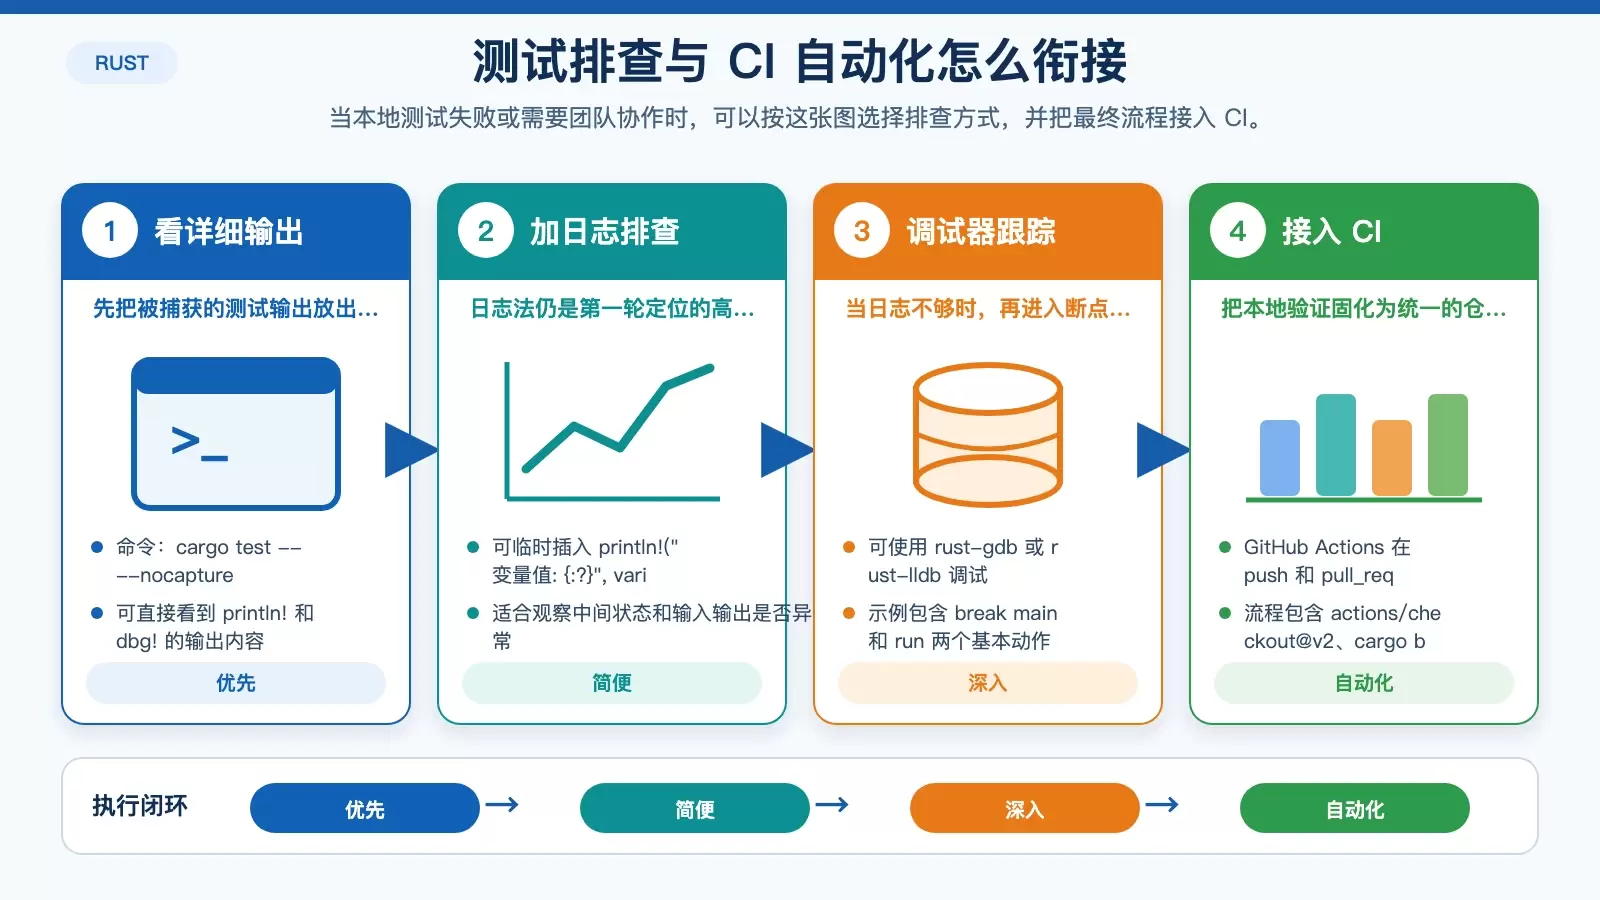
测试失败后,优先这样调试
Rust 测试失败并不稀奇,关键在于尽快判断是断言写错、输入边界没覆盖,还是程序本身存在逻辑问题。下面这几种方法最实用。
先看完整输出
如果测试里加过打印信息,可以直接运行:
cargo test -- --nocapture这会把测试过程中的输出完整显示出来,适合先确认变量值、分支走向和实际结果。
需要逐步跟踪时再上调试器
当打印信息不够定位问题时,可以使用 rust-gdb 或 rust-lldb。例如:
rust-gdb target/debug/my_project-123456  # 替换成你的项目可执行文件
(gdb) break main  # 设置断点
(gdb) run          # 运行程序
这种方式更适合检查调用链、断点附近的变量状态,以及某些不容易靠日志看清楚的执行路径。
临时加日志依然很好用
很多时候不需要马上上调试器,直接在测试或函数里插一行日志就能看出问题:
println!("变量值: {:?}", variable)这种办法虽然简单,但对定位输入输出异常、观察中间状态尤其有效,适合先做第一轮排查。
把测试接入持续集成,避免只在本地通过
本地手动跑测试适合个人开发,但只要项目开始多人协作,或者提交频率变高,就应该让测试自动执行。这样每次代码变更都能及时发现问题,而不是等到合并后再回头补救。
以 GitHub Actions 为例,可以在项目根目录创建 .github/workflows/rust.yml,内容如下:
name: Rust CI

on:
  push:
    branches: [ main ]
  pull_request:
    branches: [ main ]

jobs:
  build-and-test:
    runs-on: ubuntu-latest  # 使用Ubuntu环境(兼容Debian)

    steps:
    - uses: actions/checkout@v2  # 检出代码
    - name: Install Rust
      run: rustup default stable  # 安装Rust稳定版
    - name: Build project
      run: cargo build --verbose  # 编译项目
    - name: Run tests
      run: cargo test --verbose   # 运行测试
把这个文件推送到 GitHub 仓库后,工作流会在 push 和 pull_request 时自动触发。虽然这里使用的是 ubuntu-latest,但对多数 Debian 开发场景来说是兼容的,足够承担编译和测试任务。
对团队来说,这一步的价值非常直接:不是谁本地说“我这边能跑”,而是每次提交都由统一环境给出结果。
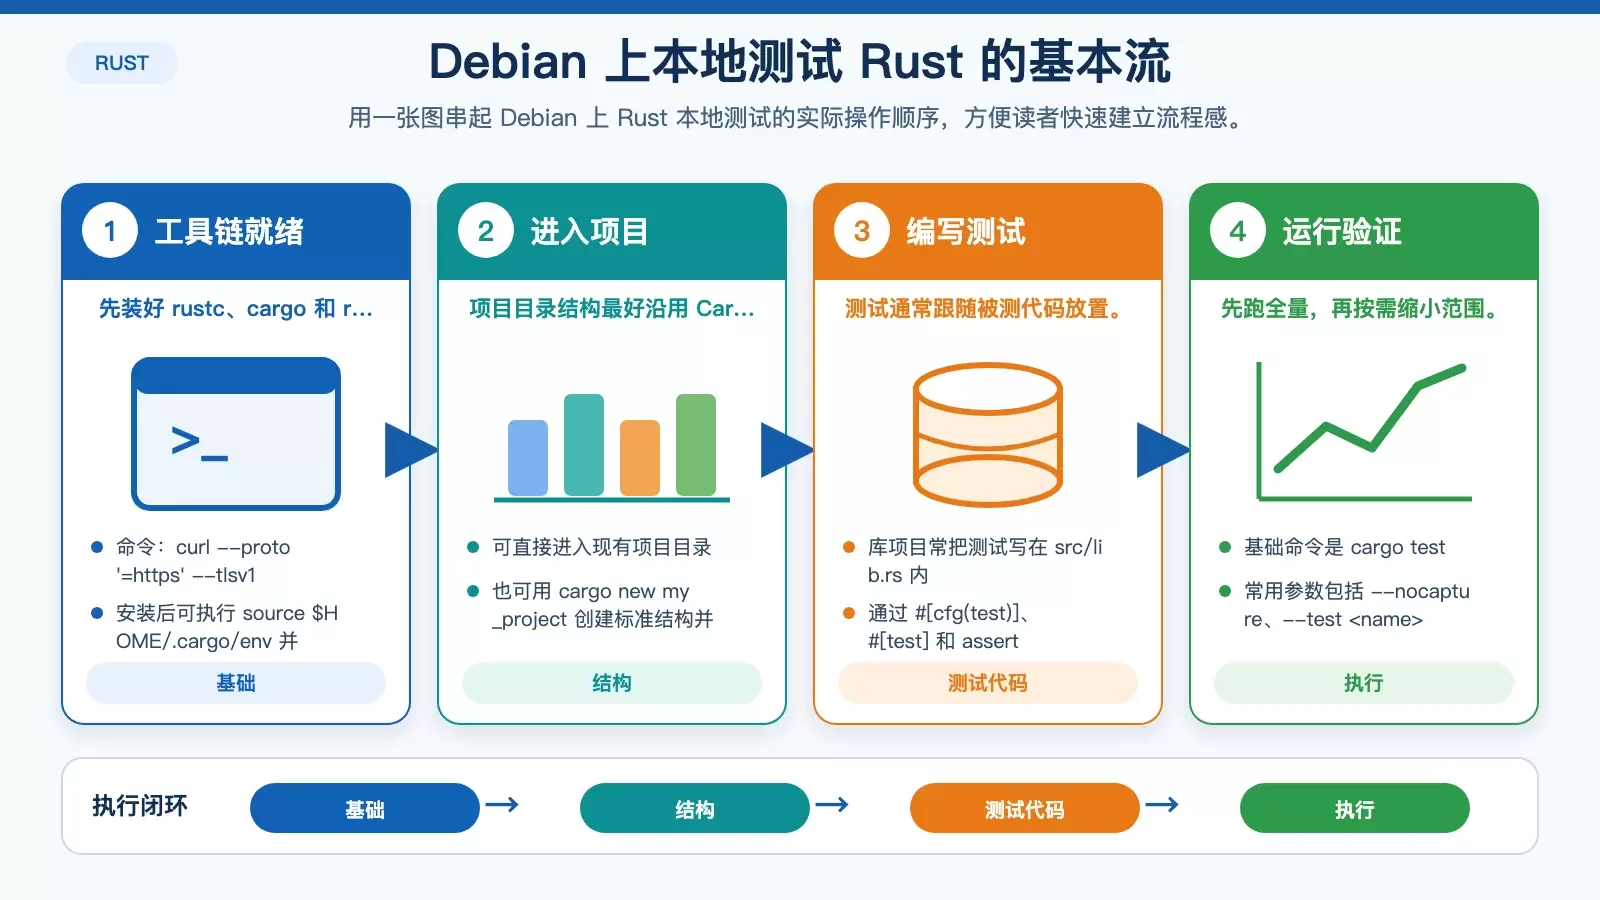
一套适合 Debian 的 Rust 测试路径
把流程串起来看,Debian 上测试 Rust 项目并不复杂:先用 rustup 装好工具链,再用标准项目结构组织代码,在 src/lib.rs 或相关位置补上测试,接着用 cargo test 执行验证,出现问题时通过 --nocapture、日志和调试器定位,最后再把这套流程放进 CI。
如果你刚开始搭建项目,先把“本地能稳定跑测试”做好;如果项目已经进入协作阶段,就尽快补上自动化执行。这样测试才不只是开发时的附加动作,而是项目质量控制的常规机制。









