

Python list.index()查找元素索引的基础用法

在 Python 中,当需要确定某个元素保存在列表(list)的具体哪个位置时,最直接的内置方式是调用 list.index() 方法。它会沿列表正向遍历,返回目标元素首次出现时的整型索引下标。本文将从基本语法、限定范围检索、重复项处理机制,以及常见报错防范四个方面说明该方法的具体使用规则与注意事项。
方法语法与基础检索
list.index() 的完整定义接收三个参数,其中后两个参数属于可选配置:
list.index(x[, start[, end]])其中,x 为待查找的目标对象;start 表示查找的起始索引位置(包含该位置);end 表示查找的终止索引位置(不包含该位置)。在仅传入目标元素时,Python 默认从索引 0 遍历至列表末尾。
# 示例:查找单一存在的元素索引
fruits = ["apple", "banana", "cherry", "date"]
target_index = fruits.index("cherry")

print("检索到的索引值:", target_index)

# 示例输出:
# 检索到的索引值: 2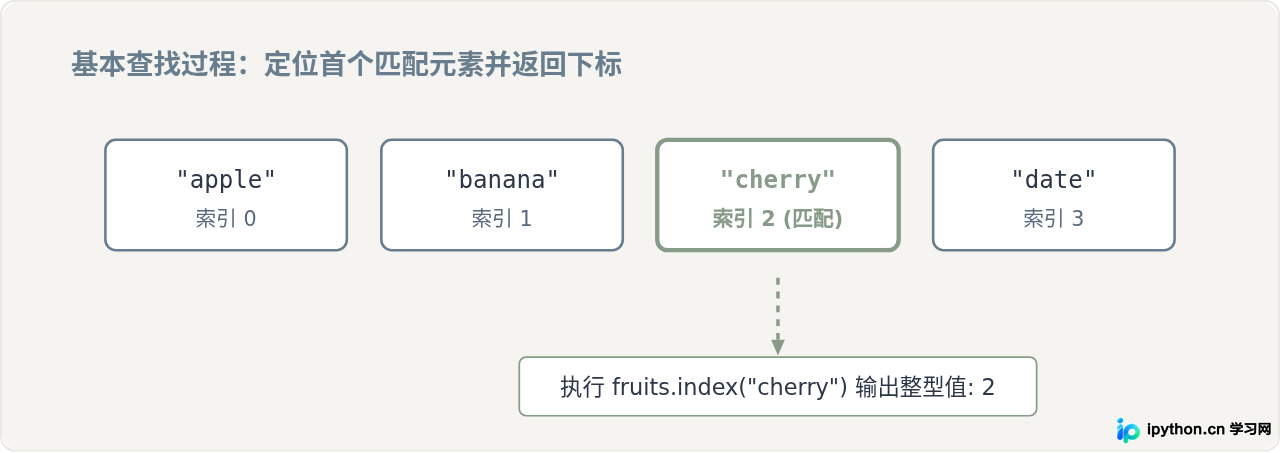
多重复项时的首位返回规则
如果列表中包含多个内容完全相同的元素,list.index() 不会返回所有位置,也不会返回最后一个位置,而是严格按照从左到右的顺序,一旦遇到第一个与目标相等(即 item == x 判定为真)的元素,就会立刻终止扫描并返回当前下标。
# 示例:存在多个相同元素时的查找
scores = [85, 92, 78, 92, 99, 92]

# 92 分别位于索引 1、3、5
first_pos = scores.index(92)
print("首个 92 所在位置:", first_pos)

# 示例输出:
# 首个 92 所在位置: 1
由于这个特性,当你需要获取后续相同元素的位置时,必须借助 start 参数跳过已查出的位置,或者采用列表推导式配合 enumerate() 一次性找出所有下标。
限定范围检索:使用 start 与 end
在已知大致范围或需要跳过某些前置元素时,可以通过 start 和 end 约束检索区间。这里的区间采用 Python 统一的“左闭右开”约定,即 [start, end),检索包含 start 位置,但到达 end 位置前就会停止。
# 示例:通过 start 查找下一个重复项
items = ["A", "B", "C", "A", "D", "A"]

# 从索引 1 开始向后查找 "A"
second_a = items.index("A", 1)
print("从索引 1 开始查到的 'A':", second_a)

# 限定在索引 1 到 4(实际检查 1, 2, 3)之间查找 "C"
c_pos = items.index("C", 1, 4)
print("区间 [1, 4) 内查到的 'C':", c_pos)

# 示例输出:
# 从索引 1 开始查到的 'A': 3
# 区间 [1, 4) 内查到的 'C': 2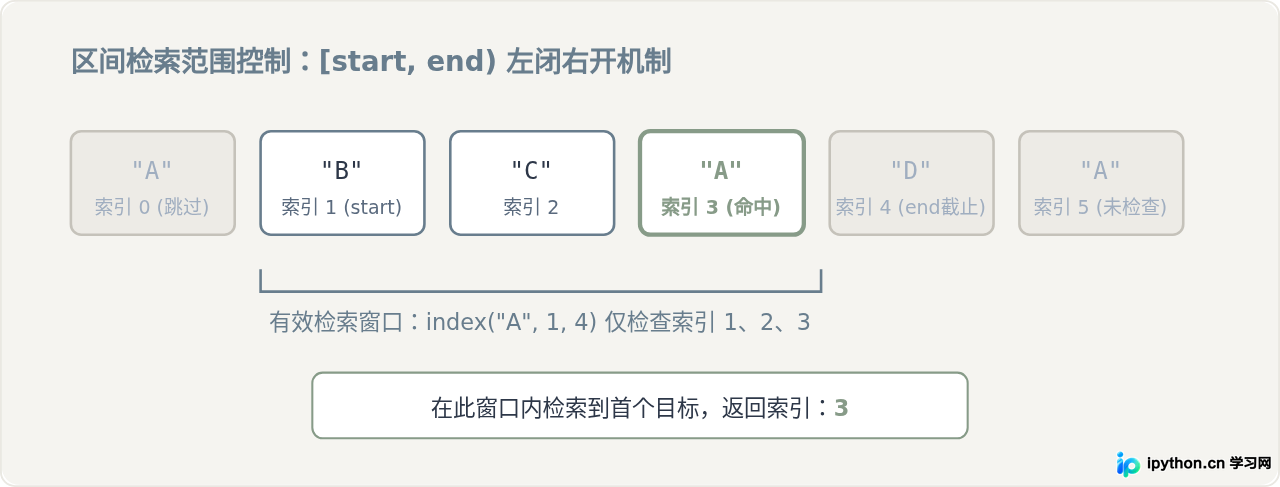
常见错误:ValueError 的触发与防范
与其他一些语言中查找失败返回 -1 不同,Python 的 list.index() 在找不到目标元素时,会直接抛出 ValueError 异常中断程序执行:
colors = ["red", "green", "blue"]
# 下行代码将直接抛出异常:ValueError: 'yellow' is not in list
pos = colors.index("yellow")
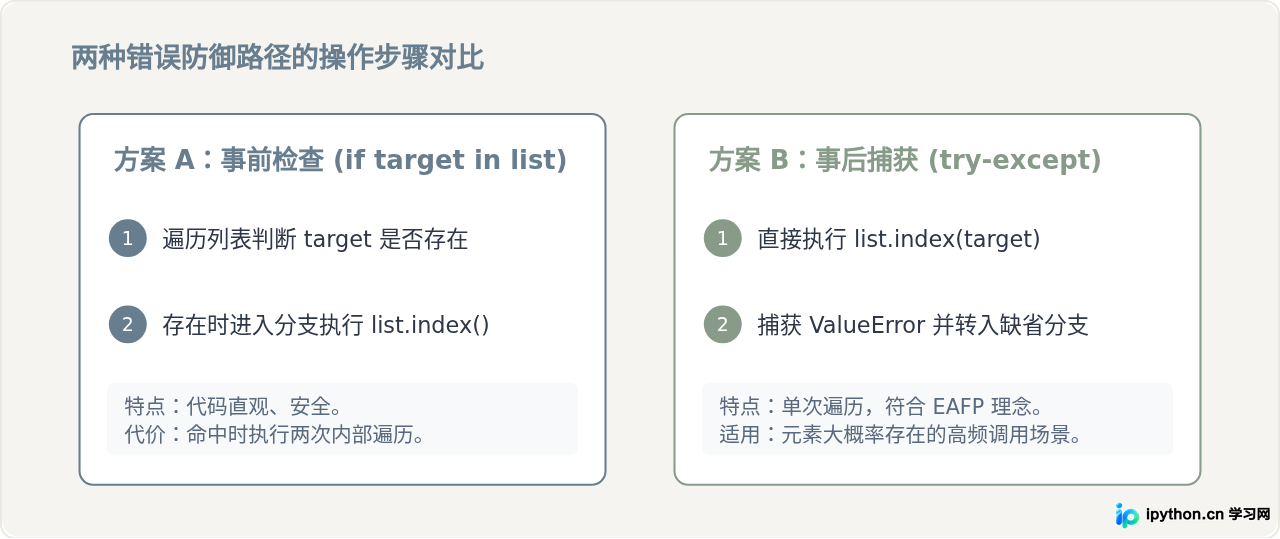
在不能 100% 确定目标是否一定在列表中时,通常有两种防御处理方式:事前检查法(使用 in 关键字) 与 事后捕获法(使用 try-except)。这两种策略的实现逻辑和适用条件存在明确区别。
代码实现:两种防御方式对照
# 方式 A:先查后取(LBYL 风格)
target = "yellow"
colors = ["red", "green", "blue"]

if target in colors:
    idx = colors.index(target)
    print("找到索引:", idx)
else:
    print("未找到元素,执行备用逻辑")

# 方式 B:直接检索并捕获异常(EAFP 风格)
try:
    idx = colors.index(target)
    print("找到索引:", idx)
except ValueError:
print("未找到元素,触发异常处理")关键差异影响:方式 A 的可读性更强,但当 target 存在时,in 操作做了一次正向扫描,随后的 index() 又重复扫描了一次;方式 B 在元素命中时仅扫描一次,性能更高。如果查找操作在庞大列表或密集循环中执行,且元素大概率存在,推荐优先选用 try-except 结构。
核心规则总结
为了在实际编码中高效使用 list.index(),可以归纳为以下几项关键结论:
综上所述,list.index() 适合用于在未排序的列表中定位特定元素的首发位置。在编写业务逻辑时,始终结合区间参数控制检索范围,并在可能缺失元素的输入场景中配置好错误捕获机制,即可确保代码稳定运行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









