

Python Trio中Nursery和Channel的使用详解

一、从结构化并发理解 Nursery 的诞生背景
在传统的基于回调或 asyncio.create_task() 的异步模型中,开发者常常面临“触发后失控”(Fire-and-forget)的问题。一个协程被派生到事件循环后,其执行生命周期脱离了调用者的代码块作用域。如果派生任务在后台因未捕获的异常崩溃,或者调用者提前退出而未能显式取消该任务,系统就会遗留静默运行的孤儿任务,造成内存与网络连接泄漏。
Trio 的核心设计理念是结构化并发(Structured Concurrency)。该理论借鉴了结构化编程淘汰 goto 语句的思想:任何一段并发控制流都必须拥有明确的进入点与退出点。在 Trio 中,不能在无约束的全局环境中启动后台任务;任何子任务的诞生,都必须依附于一个具象的作用域——这就是 Nursery(苗圃)。
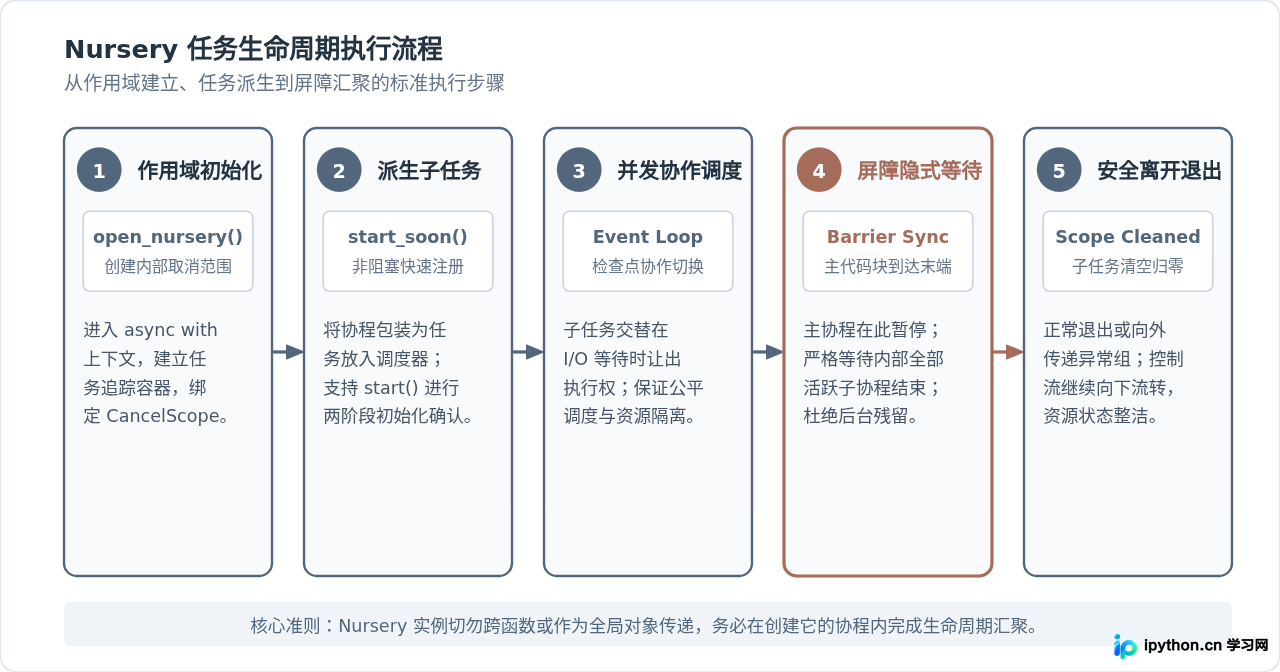
进入 async with trio.open_nursery() as nursery: 代码块时,一个作用域被初始化。在该代码块退出时,Trio 会强制挂起当前主协程,直到该 Nursery 内部启动的所有子任务全部执行完毕。如果任何一个子任务发生异常,Nursery 会立即发出取消信号中止其余兄弟任务,并在汇总异常后向外层抛出。这种机制从底层杜绝了协程失控。
二、Nursery 的生命周期管理与任务派生
使用 Nursery 启动并发任务主要包含三个阶段:开启作用域、注册子任务以及等待隐式汇聚。
1. 基本启动与并发汇聚
派生并发任务的核心方法是 nursery.start_soon()。该方法接收一个异步函数及其参数,并将其提交至 Trio 的调度队列。该调用本身不阻塞,但外层的 async with 代码块末端会形成一道同步屏障。
import trio

async def fetch_status(service_id: int, delay: float):
    print(f"[任务 {service_id}] 开始轮询,预计等待 {delay}s")
    await trio.sleep(delay)
    print(f"[任务 {service_id}] 轮询完成")

async def main():
    print("--- 步骤 1: 准备进入 Nursery ---")
    async with trio.open_nursery() as nursery:
        # 派生三个并发子任务
        nursery.start_soon(fetch_status, 1, 0.4)
        nursery.start_soon(fetch_status, 2, 0.2)
        nursery.start_soon(fetch_status, 3, 0.6)
        print("--- 步骤 2: 代码块主体结束,进入隐式等待阶段 ---")

    print("--- 步骤 3: 所有子任务均已结束,Nursery 退出 ---")

trio.run(main)--- 步骤 2: 代码块主体结束,进入隐式等待阶段 ---
[任务 1] 开始轮询,预计等待 0.4s
[任务 2] 开始轮询,预计等待 0.2s
[任务 3] 开始轮询,预计等待 0.6s
[任务 2] 轮询完成
[任务 1] 轮询完成
[任务 3] 轮询完成
--- 步骤 3: 所有子任务均已结束,Nursery 退出 ---
从上述输出可以看到,主协程即便执行到了 async with 代码块的最后一行,控制流也不会跳出该代码块,而是停留在屏障处等待任务 1、2、3 全部退出。这一特性保证了调用栈的时序确定性。
2. 进阶初始化:nursery.start() 的两阶段启动
在生产实践中,常常需要确保“服务协程已经成功完成监听端口绑定”之后,主流程才能继续执行。此时 start_soon() 无法提供即时反馈。为此,Trio 提供了 nursery.start()。
该方法启动的任务函数必须额外接收一个 task_status 命名参数。子任务在完成前置准备后调用 task_status.started(return_value),主流程的 await nursery.start(...) 才会解除阻塞返回。这一模式极大简化了异步服务间的依赖编排。
三、MemoryChannel 的工作原理与端点管理
并发协程之间不仅需要生命周期控制,更需要安全的数据传递。标准库 asyncio.Queue 是一个共享的可变对象,发送端与接收端混用同一个对象指针,导致关闭状态与剩余数据读取难以精确判定。
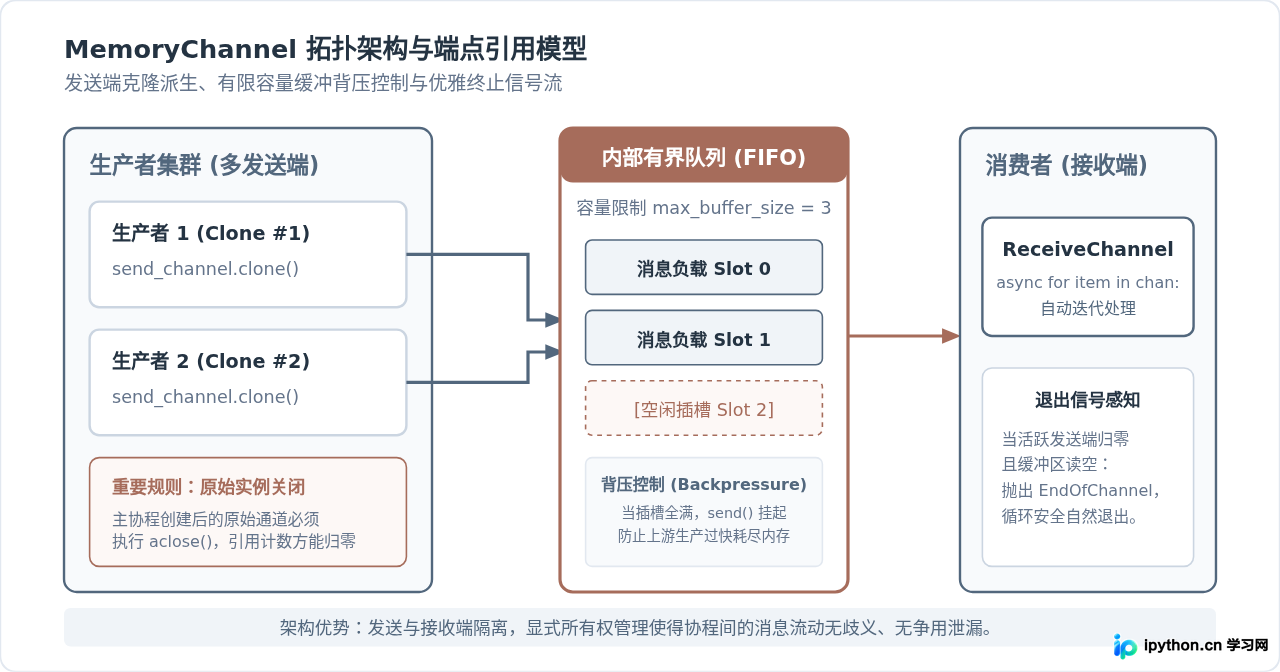
Trio 采用了类似 Go channel 或 Unix 管道的单向端点分离设计。调用 trio.open_memory_channel(max_buffer_size) 时,返回的是一对具有明确职责的独立对象:(send_channel, receive_channel)。
1. 端点职责与克隆机制
- SendChannel:只允许执行
send(item)。若需要多个生产者向同一个通道写入,必须显式调用send_channel.clone()。 - ReceiveChannel:只允许执行
receive()或通过async for item in receive_channel:遍历。若需要多个工作协程分发消费,通过receive_channel.clone()复制接收端点。
SendChannel 副本均被显式关闭(调用 aclose() 或退出 async with send_chan: 上下文)时,接收端在读取完缓冲区中所有遗留项目后,才会接收到 trio.EndOfChannel 信号,从而让 async for 循环正常终止。如果遗漏了任何一个克隆端点的关闭,接收端将陷入永久挂起。
2. 多生产者单消费者完整可运行示例
下面的代码演示了经典的异步生产者-消费者架构。通过在 Nursery 中启动消费者和两个生产者,并在主协程中主动关闭原始 send_chan,实现了端到端干净利落的退出控制。
import trio

async def producer(name: str, send_channel: trio.MemorySendChannel, count: int):
    # 使用 async with 确保当前生产者的副本通道在退出时自动关闭
    async with send_channel:
        for i in range(count):
            item = f"{name}-数据块-{i}"
            await send_channel.send(item)
            print(f"[生产端] {name} 成功推入: {item}")
            await trio.sleep(0.1)
    print(f"[生产端] {name} 生产完毕,发送端副本已安全关闭")

async def consumer(receive_channel: trio.MemoryReceiveChannel):
    async with receive_channel:
        # 当所有发送端副本全部关闭且队列已空时,该迭代器自动终结
        async for item in receive_channel:
            print(f"  [消费端] 收到并处理: {item}")
            await trio.sleep(0.15)
    print("  [消费端] 检测到 EndOfChannel,消费者协程正常退出")

async def main():
    # 创建带容量限制的通道(max_buffer_size=2 激活背压控制)
    send_chan, recv_chan = trio.open_memory_channel[str](max_buffer_size=2)

    async with trio.open_nursery() as nursery:
        # 启动消费者
        nursery.start_soon(consumer, recv_chan)

        # 启动两个生产者,各自分配一个 clone 后的发送端
        nursery.start_soon(producer, "Worker-A", send_chan.clone(), 3)
        nursery.start_soon(producer, "Worker-B", send_chan.clone(), 2)

        # 核心关键步骤:主协程必须关闭原始 send_chan
        # 否则发送端引用计数永远至少为 1,消费者将永远挂起在循环中
        await send_chan.aclose()

    print("--- 所有生产者和消费者已优雅完成退出,流水线平稳结束 ---")

trio.run(main)[生产端] Worker-B 成功推入: Worker-B-数据块-0
[消费端] 收到并处理: Worker-A-数据块-0
[生产端] Worker-A 成功推入: Worker-A-数据块-1
[消费端] 收到并处理: Worker-B-数据块-0
[生产端] Worker-B 成功推入: Worker-B-数据块-1
[消费端] 收到并处理: Worker-A-数据块-1
[生产端] Worker-A 成功推入: Worker-A-数据块-2
[生产端] Worker-B 生产完毕,发送端副本已安全关闭
[消费端] 收到并处理: Worker-B-数据块-1
[生产端] Worker-A 生产完毕,发送端副本已安全关闭
[消费端] 收到并处理: Worker-A-数据块-2
[消费端] 检测到 EndOfChannel,消费者协程正常退出
--- 所有生产者和消费者已优雅完成退出,流水线平稳结束 ---
四、异常级联传播与取消范围(Cancel Scope)
在并发编程中,最棘手的莫过于“部分失败”的处理。假设五个并发任务中有某一个发生数据库超时抛出了异常,传统框架中剩余四个任务往往继续无谓地占用计算资源,甚至引发脏数据写入。
1. Nursery 内部的自动取消链条
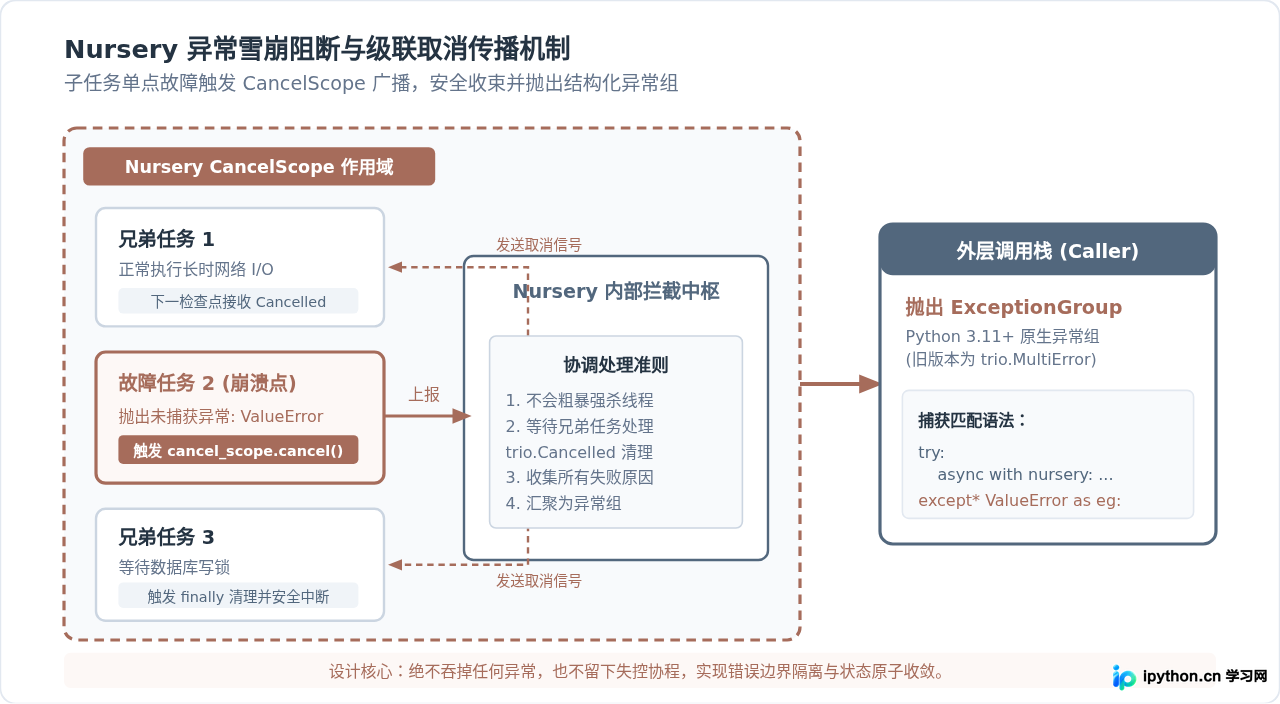
每个 Nursery 在创建时内部都封装了一个专属的 CancelScope。只要 Nursery 监控的任意一个子任务由于未处理的异常发生崩溃,Trio 的事件循环会即刻介入:
- 自动触发该 Nursery 的
cancel_scope.cancel(); - 将取消状态传递给处于该作用域下的所有兄弟协程;
- 各个兄弟协程在下一个异步检查点(如
trio.sleep()、网络读写操作等)立刻收到trio.Cancelled异常; - 所有子任务执行完
finally资源清理块后退出; - Nursery 汇聚所有子任务引发的异常,向外层抛出。
2. 异常组(ExceptionGroup)处理模式
当多个子任务在取消过程中同时抛出异常时,单个 except Exception: 无法完整表达多个并列错误。在 Python 3.11 及以上版本中,Trio 全面接入了标准库的 ExceptionGroup 机制,推荐使用 except* 语法拆解并发异常:
import trio

async def bad_task():
    await trio.sleep(0.2)
    raise ValueError("远程接口返回非法数据格式")

async def background_poller():
    try:
        while True:
            await trio.sleep(0.1)
    except trio.Cancelled:
        print("[监控任务] 收到取消信号,释放轮询连接池")
        raise  # 必须重新向上抛出 Cancelled,保证取消链条正常传递

async def main():
    try:
        async with trio.open_nursery() as nursery:
            nursery.start_soon(background_poller)
            nursery.start_soon(bad_task)
    except* ValueError as eg:
        # 使用 Python 3.11+ 的 except* 精确过滤异常组中的特定类型
        print(f"[外层捕获] 成功阻断并捕获异常组: {eg.exceptions}")

trio.run(main)[外层捕获] 成功阻断并捕获异常组: (ValueError('远程接口返回非法数据格式'),)
五、Nursery 与 Channel 协同架构实战
在实际业务开发(如日志批量写入、并发网页抓取与数据落库)中,往往需要将 Nursery 的作用域屏障与 Channel 的消息缓冲深度结合。
1. 典型死锁隐患与排查清单
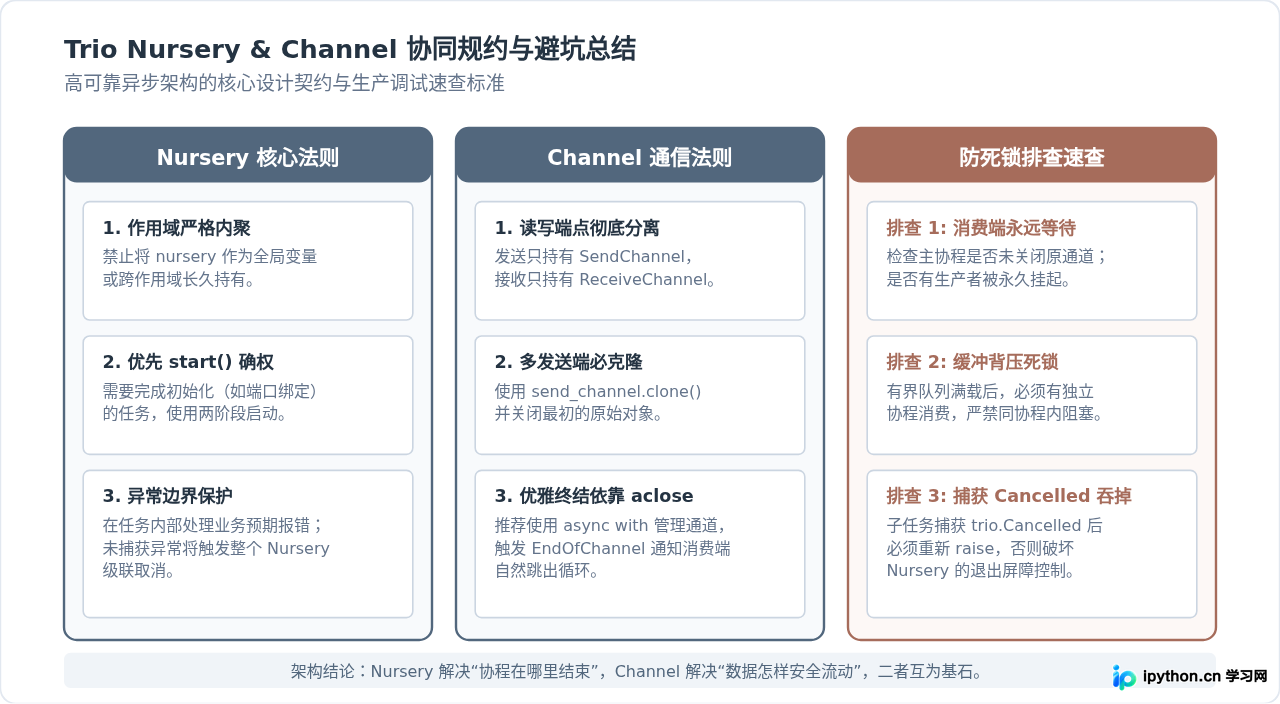
新手在使用两者编写流水线时,最容易遭遇两种“假死(Deadlock)”现象:
- 未克隆或未关闭原始发送端:如前文所述,在
async with open_nursery()作用域外直接启动消费端async for,但发送端的某一个引用并未在任何协程中被关闭,导致消费端永远处于等待状态,整个 Nursery 永远无法汇聚。 - 零容量通道与非并发调用:使用
max_buffer_size=0(交会信道)时,send()必须与receive()在不同协程中同时就绪才能完成握手。如果在同一个协程内先send()再准备receive(),协程将在第一步永久卡死。
2. 架构模式选型对照
在设计复杂的异步业务流时,可以通过下表明确各项构件的使用分界:
| 对比维度 | Trio Nursery | Trio MemoryChannel | 传统 asyncio 对标方案 |
|---|---|---|---|
| 主要职责 | 协程生命周期界定与异常汇聚 | 受控内存消息缓冲与背压通信 | asyncio.TaskGroup / asyncio.Queue |
| 作用域特性 | 严格绑定上下文(Context Manager) | 可跨任务传递端点(显式克隆) | 全局引用,缺乏作用域自动汇聚 |
| 异常行为 | 级联取消同作用域所有子任务 | 传递 EndOfChannel 或 ClosedResourceError | 默认只在任务自身抛错,易导致孤儿任务 |
| 关闭机制 | 退出代码块时自动汇聚屏障 | 所有克隆端点 aclose() 触发终结 | 需手动调用 task.cancel() 或 queue.join() |
六、结论与实践建议
Trio 的 Nursery 和 MemoryChannel 绝非仅仅是语法糖,而是从并发理论层面对传统异步模型缺陷的系统性修复。在编写 Trio 应用时,应当遵循以下核心工程习惯:
首先,将业务逻辑拆分为粒度明确的微任务,并严格将其收敛在各自最紧凑的 Nursery 内部,不跨层抛出未受管制的并发操作;其次,始终通过 max_buffer_size 为通道显式声明容量界限,借由背压机制保护系统免受突发流量冲击;最后,充分利用端点分离的生命周期语义,以 async with 自动化释放发送端,从而使消费者在完成历史负载后安全退出。掌握这两大核心利器,即可在复杂的异步高并发场景下构建出具备数学级严谨性与高度韧性的系统。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









