

Python批量删除列表中满足条件的元素:列表推导式实战

在 Python 编程中,列表(list)是最常用且灵活的数据结构之一。在数据清洗、日志分析或业务逻辑处理时,我们经常需要对列表进行清理:例如剔除所有不合规的负数、删除空字符串,或者批量过滤掉状态异常的对象。许多初学者在面对这一需求时,第一反应往往是使用循环遍历并直接在原列表中调用删除操作,却常常遇到元素遗漏或结果不及预期的现象。实际上,在 Python 中批量剔除满足特定条件的元素,最高效且清晰的做法并非直接在原列表中调用删除方法,而是使用列表推导式构建出只包含保留元素的新列表;若业务场景要求保留原列表对象的内存引用,配合切片赋值(lst[:] = [...])即可在原地无缝替换。
一、常见直觉陷阱:为什么在 for 循环中边遍历边删除会出错?
许多初学者在尝试批量删除满足条件的元素时,直觉上会写出如下代码:使用 for item in my_list: 遍历列表,一旦判断 item 满足删除条件,便调用 my_list.remove(item) 或 del。这种思路看似直观,如同“在传送带上挑选不合格零件并扔掉”,但在 Python 的可变序列中却是一个经典的逻辑陷阱。
我们来看一个具体的例子。假设列表中有一组整数,我们希望批量删除所有的偶数 2:
# 错误示例:边遍历边删除
numbers = [1, 2, 2, 3, 4]
for num in numbers:
    if num % 2 == 0:
        numbers.remove(num)

print("处理结果:", numbers)
# 预期输出: [1, 3]
# 实际输出: [1, 2, 3]  <-- 第二个 2 竟然被遗漏了!
为什么列表中仍然残留了一个偶数 2?这背后的本质是底层数组的内存位移与迭代游标错位。在 Python 内部,for 循环实际上依赖一个按索引递增的迭代器来工作(索引游标从 0, 1, 2... 依次步进):
- 初始状态:游标指向索引 0(元素 1),不满足条件,游标前进到索引 1。
- 触发删除:游标指向索引 1(第一个 2),满足条件,执行
numbers.remove(2)。 - 元素平移:删除操作发生后,原列表位于索引 1 之后的所有元素全部向前移动一位。原本处于索引 2 的第二个 2,被挪到了索引 1。
- 游标步进:在下一轮循环中,迭代器的索引游标按照既定规则自然递增到 2。此时索引 2 上的元素已经是 3!原本挪到索引 1 的第二个 2 被完全“跳过”,根本没有接受判断。
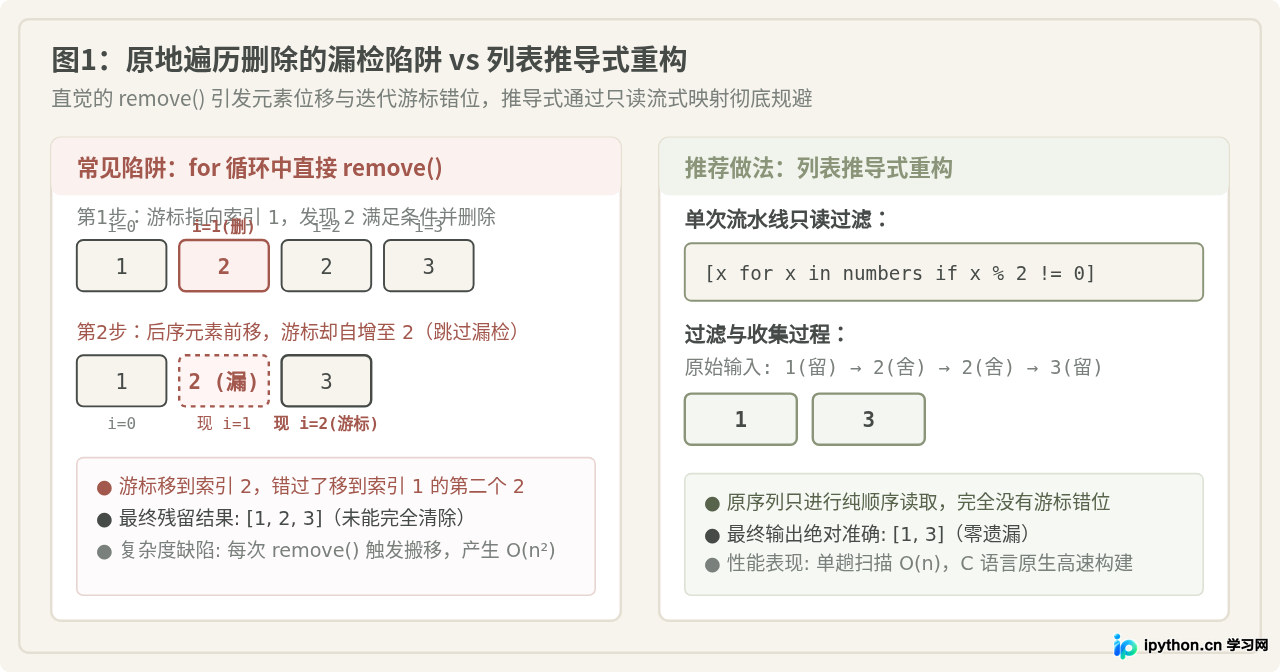
remove(),改用下标倒序删除(例如 for i in range(len(lst)-1, -1, -1): del lst[i])虽然能解决漏检问题,但每次 del 依然会引起数组元素的内存平移,在数据量稍大时会导致严重的性能下降。
二、列表推导式核心实战:逻辑逆向与条件反转
使用列表推导式解决批量删除问题,关键在于思维方式的转换:将“删除满足条件的元素”,转换为“保留不满足该条件的元素”。
列表推导式的标准语法模板非常直观:
# 核心模式:保留使得 condition(x) 为 False 的元素
filtered_list = [x for x in original_list if not condition(x)]
在日常开发中,这种条件反转常常表现为以下几种典型的实战场景:
1. 数值序列清洗:剔除异常值与负数
假设我们接收到一组温度传感器上报的数据,需要批量剔除所有小于 0 的无效温度读数(删除条件为 x < 0,保留条件即为 x >= 0):
raw_temperatures = [24.5, -99.0, 26.1, -1.0, 25.8, 23.9]

# 批量剔除负数异常值
valid_temperatures = [temp for temp in raw_temperatures if temp >= 0]

print("清洗后数据:", valid_temperatures)
# 示例输出: [24.5, 26.1, 25.8, 23.9]
2. 文本数据清洗:批量移除空串与格式异常文本
在处理文件读取或用户输入时,列表中往往混杂着纯空格字符串、换行符或注释行。我们可以直接在推导式中结合字符串方法进行判定与剔除:
raw_lines = ["import os", "  ", "# 配置文件", "import sys", "", "   ", "DEBUG = True"]

# 批量删除空白行与以 # 开头的注释行
cleaned_lines = [
    line.strip()
    for line in raw_lines
    if line.strip() and not line.strip().startswith("#")
]

print("有效代码行:", cleaned_lines)
# 示例输出: ['import os', 'import sys', 'DEBUG = True']
3. 复杂结构过滤:批量清理字典对象列表
在 Web 开发或后端数据处理中,列表元素通常是字典或自定义模型对象。例如,我们需要从用户订单列表中批量剔除已取消(cancelled)的订单:
orders = [
    {"id": 101, "amount": 150.0, "status": "completed"},
    {"id": 102, "amount": 80.0,  "status": "cancelled"},
    {"id": 103, "amount": 220.0, "status": "pending"},
    {"id": 104, "amount": 45.0,  "status": "cancelled"}
]

# 批量删除状态为 cancelled 的订单项
active_orders = [order for order in orders if order.get("status") != "cancelled"]

print("有效订单数量:", len(active_orders))
# 示例输出: 2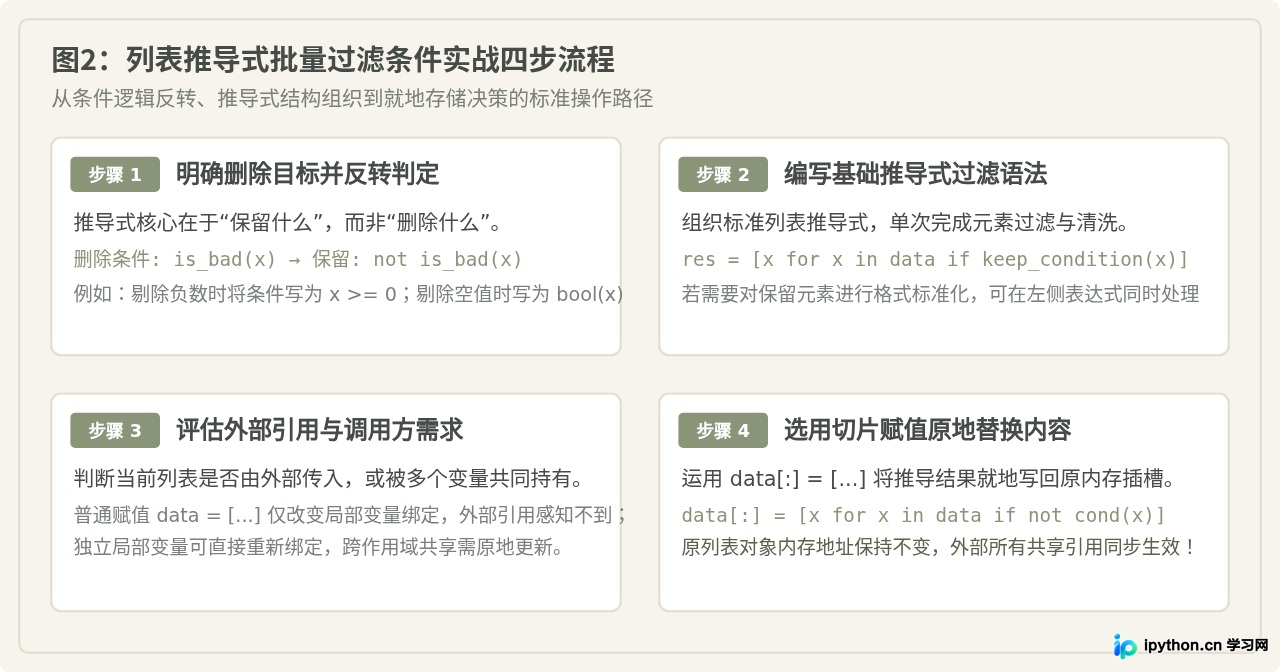
三、进阶要点:保持对象引用不变的原地修改(lst[:])
虽然 new_list = [x for x in original_list if ...] 足够简洁,但在实际工程中,常常会遇到“需要原地修改列表”的场景。比如列表作为实参传递给了一个函数,函数内部需要清理数据,并希望调用方的列表同样生效;或者类属性中的列表被多处引用,直接重新赋值会导致其他引用丢失同步。
我们先看一下直接重新赋值的问题所在:
def purge_negatives_wrong(data_list):
    # 错误示范:重新绑定了局部变量名 data_list
    data_list = [x for x in data_list if x >= 0]

my_data = [10, -2, 20, -5, 30]
purge_negatives_wrong(my_data)
print("调用函数后的 my_data:", my_data)
# 实际输出: [10, -2, 20, -5, 30] <-- 完全没有发生变化!在上面的代码中,data_list = [...] 仅仅是将函数局部的变量名绑定到了一个新列表对象上,而外部变量 my_data 所引用的原列表根本没有受到任何影响。
正确的解决方案:使用切片赋值 data_list[:] = [...]
在 Python 中,通过给切片 [:] 赋值,可以替换原列表内部包含的所有元素,而不会改变原列表对象自身的内存地址:
def purge_negatives_inplace(data_list):
    # 正确做法:切片赋值,原地替换列表内容
    data_list[:] = [x for x in data_list if x >= 0]

my_data = [10, -2, 20, -5, 30]
print("处理前 id(my_data):", id(my_data))

purge_negatives_inplace(my_data)

print("处理后 id(my_data):", id(my_data))
print("调用函数后的 my_data:", my_data)
# 输出的 id 完全一致!
# 实际输出: [10, 20, 30]  <-- 成功实现原地批量剔除!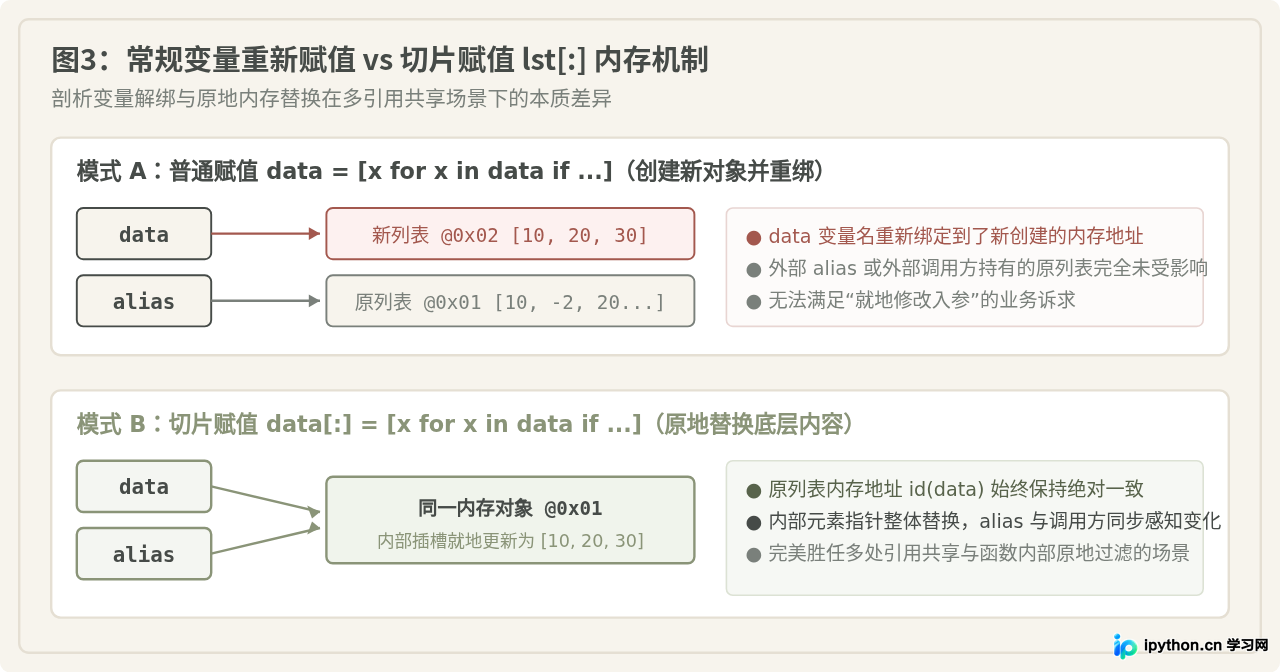
四、常见方案对比与性能选型指南
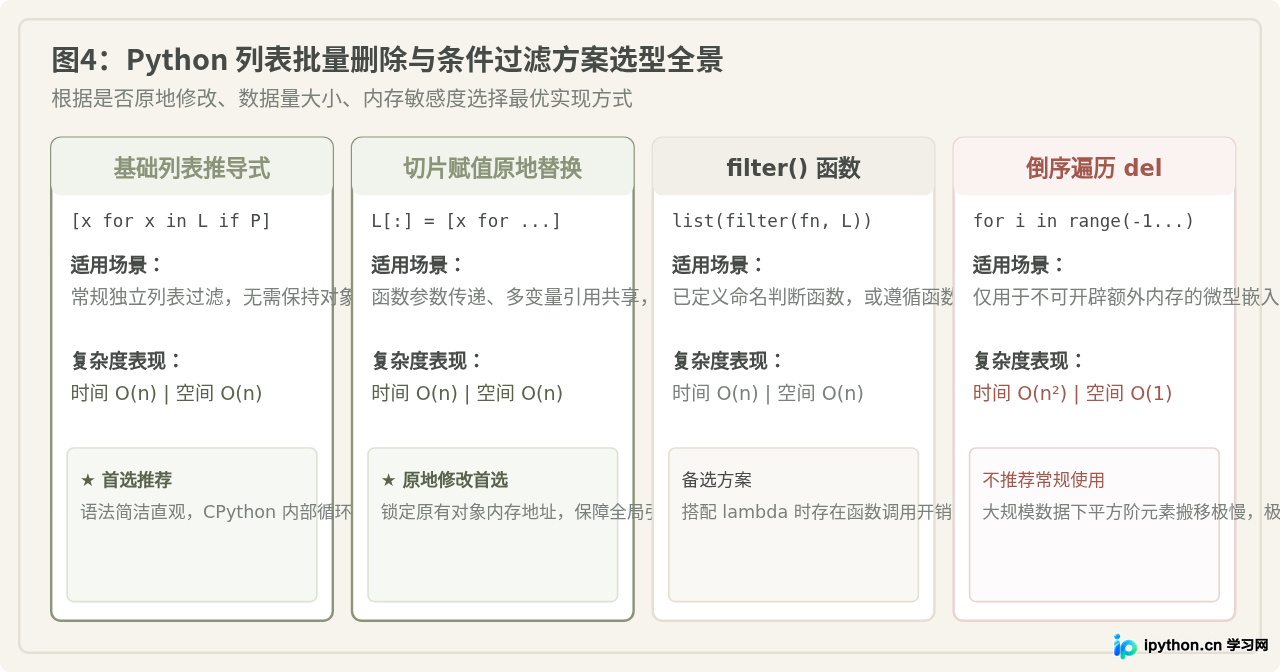
除了列表推导式之外,Python 还提供了内置函数 filter(),以及针对特定情况的倒序循环删除。在不同的业务规模与内存约束下,它们各有取舍:
- 基础列表推导式(推荐首选):语法最地道,底层由 CPython 虚拟机优化执行,单次遍历即可完成构建,运行速度通常优于
filter()搭配lambda。适用于绝大多数常规数据清洗场景。 - 切片赋值推导式(原地修改首选):在保留推导式高效执行优势的同时,保证了原列表对象引用的稳定,是跨函数、跨模块共享状态清理的标准范式。
- 内置 filter() 函数:当过滤条件已经定义为一个独立的普通命名函数时,
filter(my_func, data)非常清晰;但如果需要临时编写lambda表达式,函数调用的额外栈帧开销会使其执行速度略慢于列表推导式,且需要显式调用list()转换为列表。 - 倒序下标遍历 del(不推荐大数据量):通过
range(len(lst)-1, -1, -1)倒序检查并del lst[i],空间复杂度为 $O(1)$,但每次删除仍然需要平移尾部元素,整体时间复杂度为 $O(n^2)$。仅在对内存极度苛刻、且列表规模极小的嵌入式或受限环境下作为备选。
五、工程实践与注意事项
在生产环境中运用列表推导式进行批量数据清理时,建议结合以下工程经验规避潜在隐患:
- 避免在 if 判定中重复高开销计算:推导式末尾的
if条件会对每个元素执行一次求值。如果判断条件依赖复杂正则匹配、文件 I/O 或数据库远程调用,建议先将计算结果缓存或预处理,避免在循环内部重复计算。 - 超大规模数据的内存考量:列表推导式会立即在内存中构建完整的全量列表。如果列表包含数千万级元素,会在短时间内产生两倍的内存占用。针对单次顺序消费的海量数据流,推荐改用生成器表达式(例如
(x for x in large_stream if not condition(x)))进行流式惰性迭代,以换取极低的内存常数。 - 保持推导式的可读性:列表推导式最适合“一至两个清晰的判定条件”。若业务逻辑过于复杂,包含多层嵌套的
if-else分支,应果断拆分为独立判断函数,或采用常规的控制流,优先保障代码的可维护性与团队协作可读性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









