

Python bool作为int子类的特性及数值计算技巧

在 Python 的对象体系中,布尔类型 bool 并不是一个与数值体系相互独立的特殊原语,而是内置整型 int 的直接子类。这意味着 True 和 False 本质上就是整数 1 和 0 的具名实例。理解这一底层机制,不仅能帮助开发者在条件统计、多字段排序和无分支计算中写出简洁优雅的代码,还能有效规避字典键意外覆盖、参数校验放行等隐蔽缺陷。本文将从底层继承原理切入,系统拆解布尔类型的数值计算技巧与工程防御边界。
一、底层机制:布尔类型与整型的继承关系
在 Python 中验证 bool 与 int 的关系,可以直接借助类型系统的自省工具:
print(issubclass(bool, int))      # 输出: True
print(isinstance(True, int))       # 输出: True
print(isinstance(False, int))      # 输出: True
print(True == 1)                   # 输出: True
print(False == 0)                  # 输出: True
print(True + True)                 # 输出: 2
print(True * 50)                   # 输出: 50
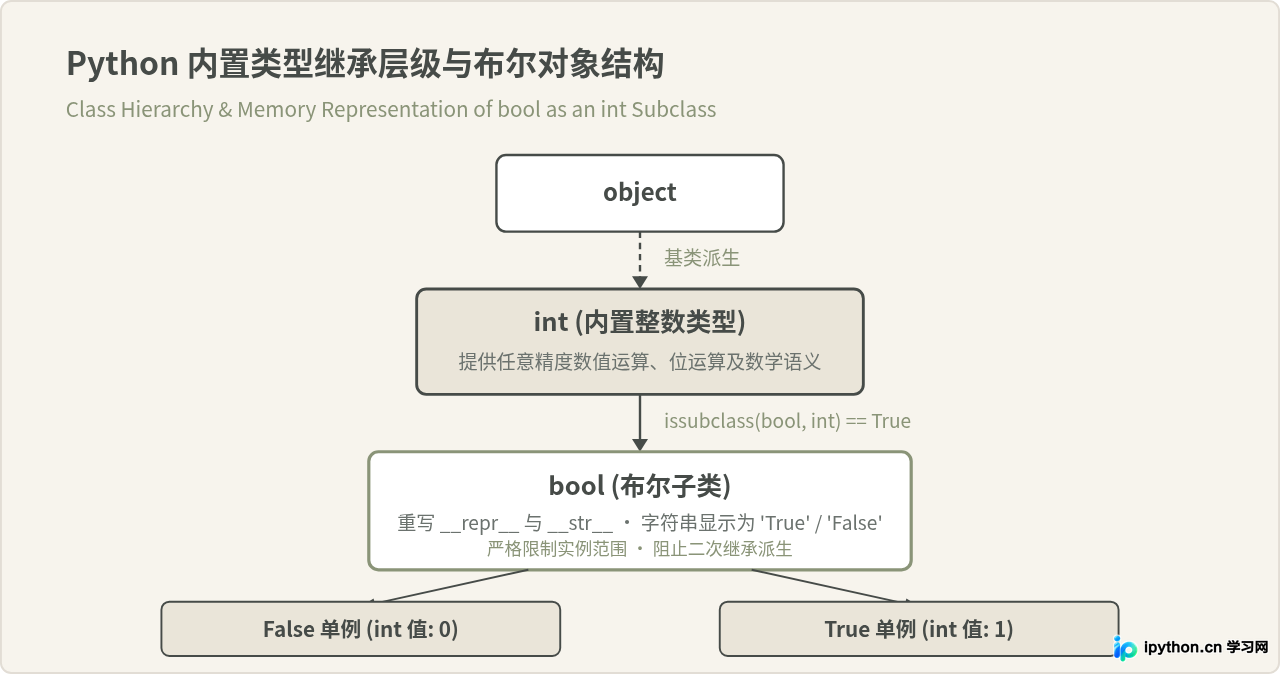
这一设计源于 Python 历史演进的务实考量。在 Python 2.2 之前,语言本身并未引入独立的布尔类型,开发者普遍习惯使用整数 1 和 0 表示真假。当 PEP 285 在 Python 2.3 正式引入 bool 类型时,为了确保所有历史代码、数学运算库以及比较逻辑保持绝对的向下兼容,设计者将 bool 定义为 int 的子类。True 和 False 则是该类的两个全局唯一单例对象。
在内存和运行行为上,bool 与普通整数的关键差异主要体现在呈现形式与实例化限制:
- 字符串表达重写:
bool类重写了__repr__和__str__方法,使得输出时显示为'True'和'False',而非数值字符'1'和'0'。 - 单例与继承封闭:Python 解释器在 C 源码层严禁再次继承
bool类,调用bool(x)总是返回全局的True或False单例,确保内存指针高度稳定。
二、实用数值计算技巧与应用场景
由于 True 与 False 在数值上下文中无缝参与运算,开发者可以在多种常规业务场景中化繁为简。
1. 条件统计与聚合(sum 结合生成器表达式)
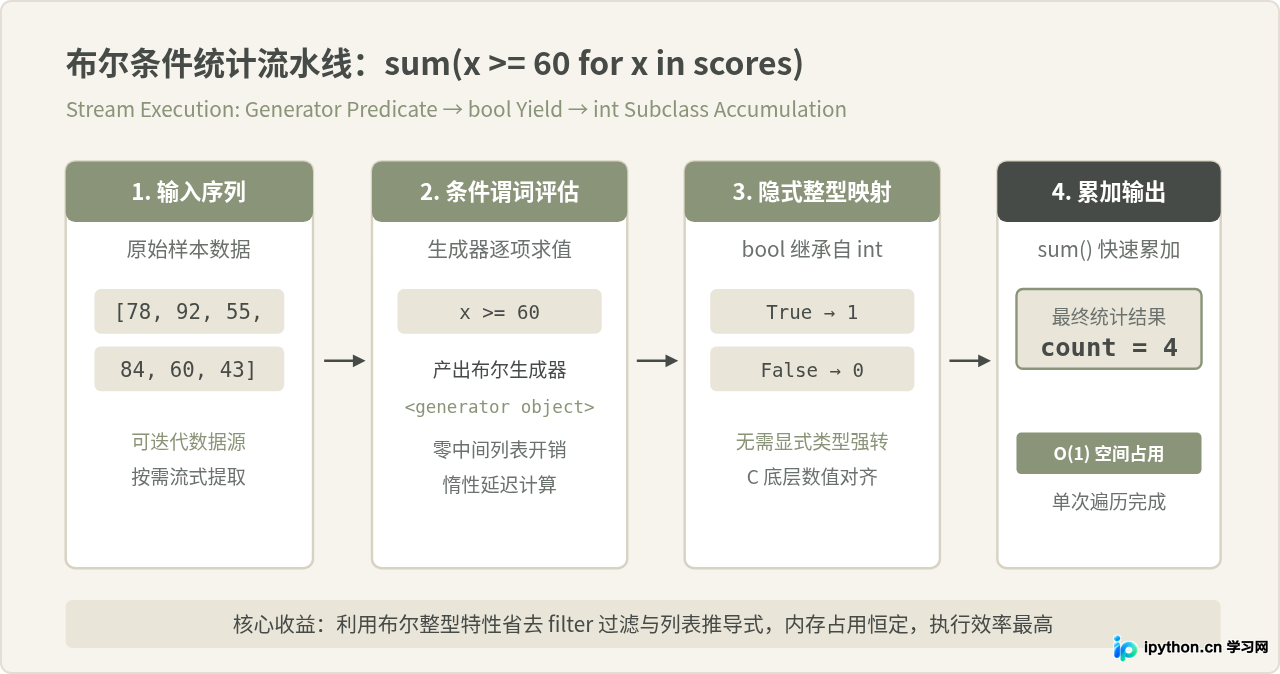
在统计满足某项条件的元素数量时,传统做法往往使用 for 循环计数或先通过列表推导式构造过滤列表再调用 len()。利用布尔值的整数属性,更地道的写法是直接将比较表达式送入 sum():
scores = [78, 92, 55, 84, 60, 43, 99]

# 统计及格(>= 60)的人数
pass_count = sum(s >= 60 for s in scores)
print(pass_count)  # 输出: 5
这里的表达式 (s >= 60 for s in scores) 是一个惰性求值的生成器对象。随着 sum() 遍历,生成器产出的布尔序列会被自动当作 1 与 0 累加。与 len([s for s in scores if s >= 60]) 相比,这种写法避免了创建中间临时列表,将空间复杂度从 O(N) 降低至恒定的 O(1),性能与内存表现更为优秀。
2. 无分支加权评分计算(Branchless Arithmetic)
在电商优惠、信用评估或积分规则中,通常包含多个并行的开关项。如果使用传统的 if-else 语句块,代码分支将随规则增加迅速膨胀:
def calculate_user_score(base_score, is_vip, has_coupon, is_first_order):
    # 利用布尔乘法消除分支
    return base_score + (is_vip * 50) + (has_coupon * 20) + (is_first_order * 30)

score = calculate_user_score(100, is_vip=True, has_coupon=False, is_first_order=True)
print(score)  # 输出: 180 (100 + 50 + 0 + 30)
因为 True * weight == weight 且 False * weight == 0,加权求和可以直接表达为一条向量化数学公式。不仅代码逻辑扁平,而且便于将规则系数提取为可配置的数据驱动结构。
3. 二元状态映射与下标索引
对于简单的状态文案反显或二值切换,可以利用 False == 0 和 True == 1 的索引位置特性替代三元表达式:
is_connected = True
status_text = ["离线", "在线"][is_connected]
print(status_text)  # 输出: 在线

# 数学符号映射
val_a, val_b = 10, 5
symbol = ["<=", ">"][val_a > val_b]
print(symbol) # 输出: >注意适用边界:该技巧仅适用于两个分支均为静态常量或纯数据的场景。若分支涉及耗时函数调用或带副作用的操作,应保留三元表达式 val_true if cond else val_false,避免列表求值时执行无效分支。
4. 复合多级排序中的布尔键(Boolean Sorting Key)
在列表排序中,布尔值在排序元组中表现为数字 0 和 1。这一特性在实现“特定项置顶”或“异常项沉底”时极为高效:
articles = [
    {"title": "基础语法", "is_top": False, "views": 1200},
    {"title": "性能调优", "is_top": True,  "views": 850},
    {"title": "内存模型", "is_top": False, "views": 2300},
    {"title": "实战指南", "is_top": True,  "views": 1500},
]

# 置顶项排前:利用 not 使 True 映射为 0(排前),False 映射为 1(排后);浏览量降序
articles.sort(key=lambda item: (not item["is_top"], -item["views"]))

for art in articles:
    print(f"[{'置顶' if art['is_top'] else '普通'}] {art['title']} - {art['views']}")
这种键函数避免了拆分两个列表分别排序再拼接的复杂过程,完全依托 Python 内部 Timsort 的稳定性一次性排定优先级。
三、边界陷阱与辨析:何时必须防范布尔整型特性
虽然布尔与整型的融合带来了诸多便利,但在特定场景下也会引入隐蔽缺陷。工程实践中必须清晰识别以下边界。
1. 字典与集合中的哈希键覆盖陷阱
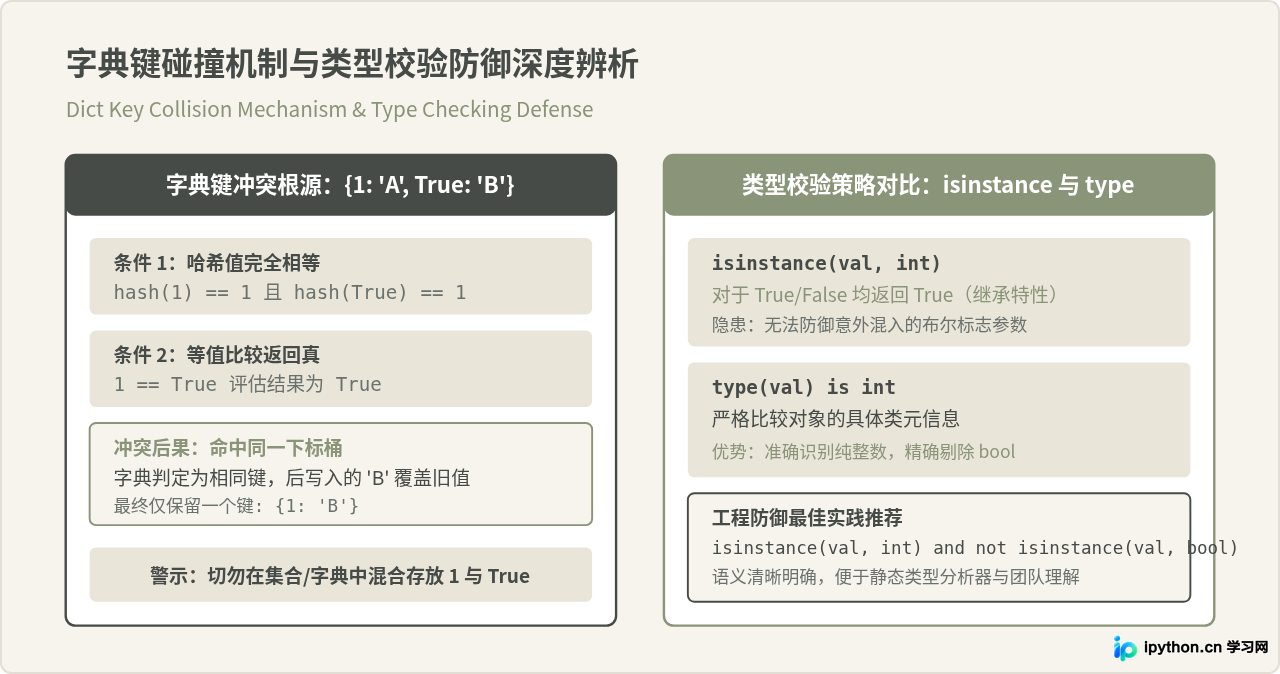
Python 字典和集合判定两个键是否相同的核心标准是:两者的哈希值相等,且通过 == 比较返回 True。这导致了许多初学者感到困惑的现象:
config = {1: "整数一", True: "布尔真"}
print(len(config))  # 输出: 1
print(config)       # 输出: {1: '布尔真'}

unique_items = {1, True, 1.0}
print(unique_items) # 输出: {1}
在底层评估时:
hash(1) == 1且hash(True) == 1,哈希值严格一致;1 == True评估为True;
字典因此认定它们为同一个键,后插入的 True: "布尔真" 会保留原键名 1 但无条件覆盖其值。如果程序设计中混合存放整数标识与布尔状态,将导致不可预期的状态丢失。
2. 类型校验时的放行缺陷(isinstance 的局限)
在接口参数校验或数据模型反序列化时,使用 isinstance(x, int) 会自动接受布尔值:
def set_user_age(age):
    if not isinstance(age, int):
        raise TypeError("年龄必须是整数")
    print(f"用户年龄更新为: {age}")

# 传入 True 不会报错!但业务语义显然被破坏
set_user_age(True)  # 输出: 用户年龄更新为: True
当业务明确要求接收严格整数(例如数据库外键、数组容量、物理计数)时,必须采取防御性编码:
- 使用精确类型判定:
if type(age) is not int: raise TypeError(...) - 使用排除式断言:
if isinstance(age, int) and not isinstance(age, bool): ...
3. 逻辑运算与位运算的语义混淆
在数值计算中,有些开发者习惯使用 & 代替 and,或使用 | 代替 or。对于两个布尔值,按位运算虽然也能产出布尔结果,但它们完全不支持短路求值,且运算符优先级显著高于比较运算符:
# 短路求值示例
obj = None
# 正确:and 触发短路,不会调用 None.is_valid
if obj is not None and obj.is_valid:
    pass

# 危险:& 属于双目位运算,左右两边均会强制求值,抛出 AttributeError
# if (obj is not None) & obj.is_valid: ...因此,在编写控制流逻辑时,必须严格区分面向条件的逻辑运算符(and / or)与面向数值的位运算符(& / |)。
四、工程实践决策与规范总结
下表对比了常见的布尔整型用法及其在不同维度上的权衡表现:
| 技术手法 | 典型代码表达 | 性能与空间 | 适用场景与推荐度 |
|---|---|---|---|
| 条件统计 | sum(x > 0 for x in data) |
时间 O(N),空间 O(1) | 强烈推荐。官方推荐惯用法,流式计算最优 |
| 多级排序键 | key=lambda x: (not x.is_vip, x.id) |
利用 Timsort 内部自然序 | 强烈推荐。避免拆分列表与二次合并 |
| 无分支打分 | score += weight * flag |
纯算术无跳转指令 | 推荐。适合公式化、多配置评分模型 |
| 字典/集合混合键 | d = {1: 'A', True: 'B'} |
引发 Hash 碰撞与值覆盖 | 严禁使用。产生不可预期的业务 Bug |
| 接口类型断言 | isinstance(val, int) |
允许子类向下兼容 | 需警惕。需结合 not isinstance(..., bool) |
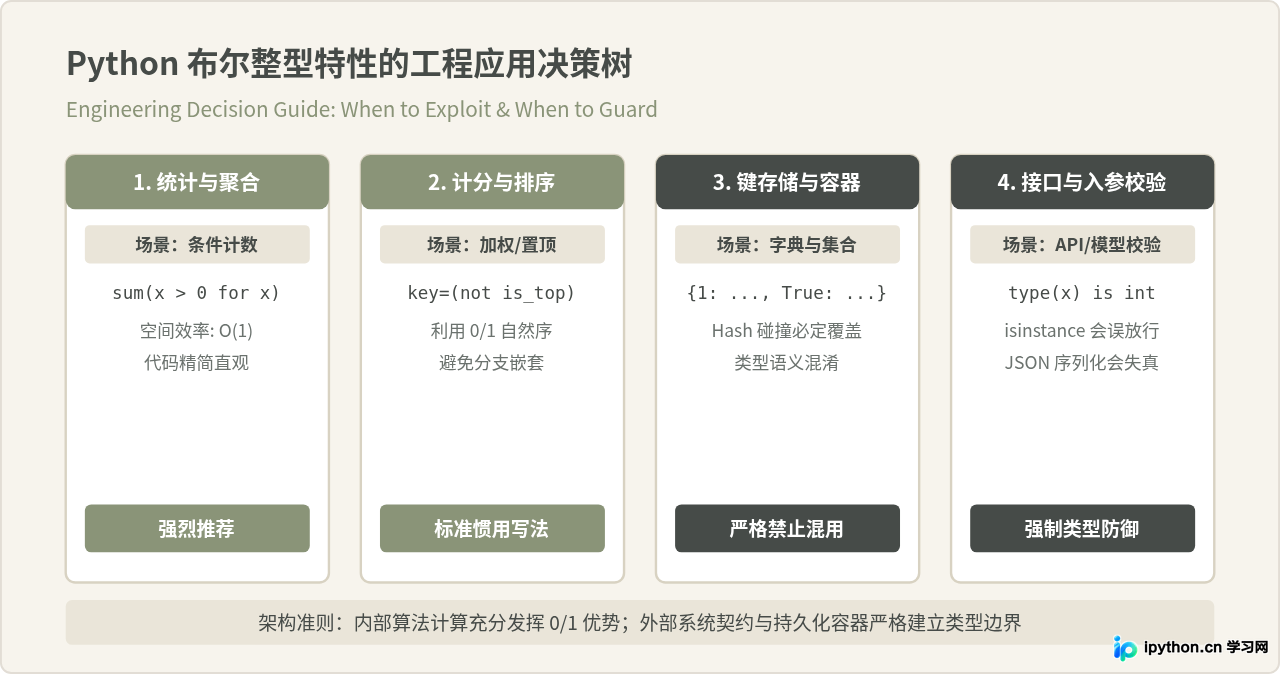
bool 作为 int 子类是 Python 实用主义哲学的重要体现。在纯内部算法与流式数据处理中,应当充分利用 0 和 1 的数值特性减少内存占用并提高代码紧凑度;而在外部系统契约(如 REST API、JSON 序列化)以及哈希键匹配中,则必须严格守住类型边界,使用显式防御消除潜在的语义歧义。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









