

Python print输出中使用\t实现文本对齐的方法

在 Python 控制台脚本与数据处理过程中,直接利用 print() 函数输出制表符 \t(Tab,ASCII 编码 9)是快速实现多列文本对齐最简便的手段。制表符对齐的核心逻辑并非在文本间插入固定数量的空格,而是驱动输出光标“停靠”到终端下一个预设的制表位(Tab Stop)。掌握这一机制的运作方式、边界特征以及动态补齐技巧,能够帮助我们在无需引入外部重型依赖的前提下,输出整洁可读的表格化文本。
一、制表符 \t 与控制台制表位机制原理
许多初学者在编写打印代码时常产生一种直觉误区,认为 \t 等同于“固定的 4 个或 8 个空格”。如果依照这一假设运行,往往会发现当字段长度不同时,后续列的输出会出现明显的参差错位。造成这种现象的根源在于终端对制表符的处理规则:制表位(Tab Stop)。
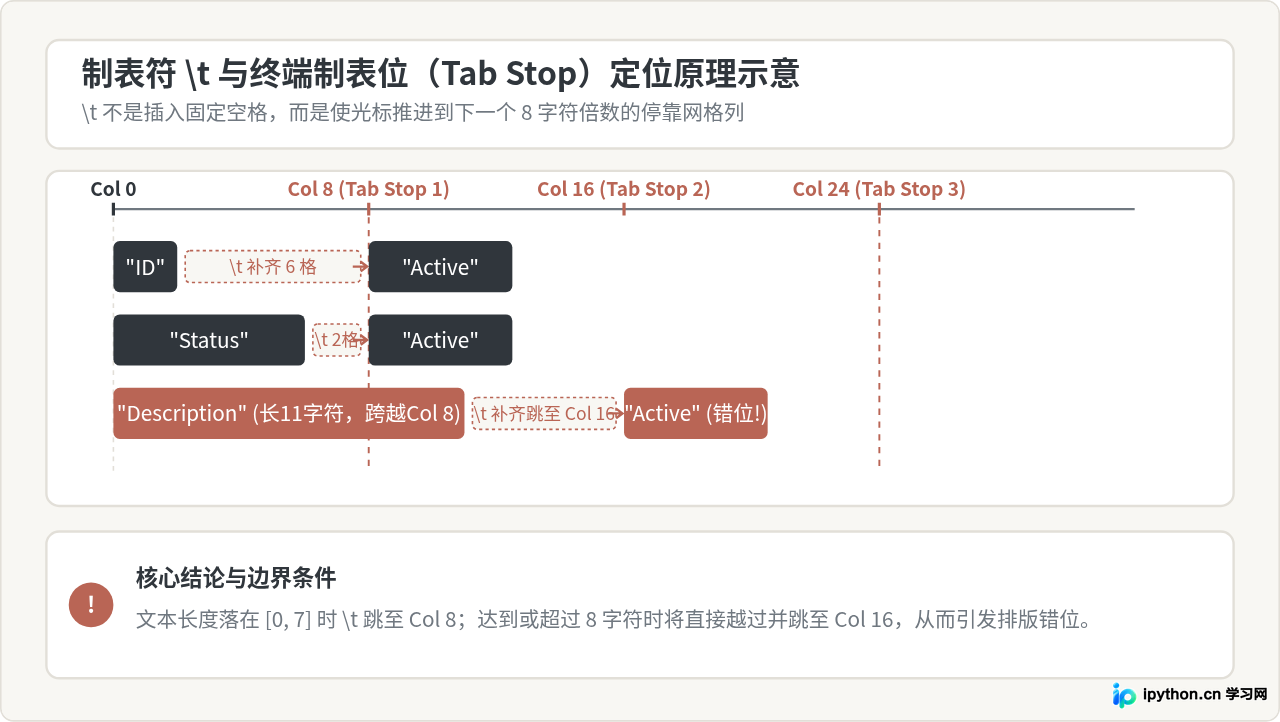
绝大多数控制台终端和文本编辑器在水平方向上预置了一组等距的标尺列,常见默认间距为 8 个字符(部分集成开发环境内嵌终端设为 4 个字符)。当输出流遇到 \t 转义字符时,当前光标会水平向前滑动,直到跨过该位置后的第一个整倍数制表位停靠点。具体规则如下:
- 若当前已输出的文本占据了 0 到 7 列,接下来的
\t会将光标精确引导至第 8 列。 - 若当前文本长度正好达到了 8 列,插入的
\t不会在第 8 列原地等待,而是跨越下一个完整的 8 列区间,直接跳至第 16 列。 - 若某一行文本长度为 9 到 15 个字符,插入
\t同样只会让光标跳至第 16 列。
这意味着,只有当同一列中的所有数据项所处的“制表位区间”完全相同时,单纯追加单一的 \t 才能呈现出平整的多列网格。下图清晰展示了这一底层定位机制与跨列特征:
二、基础用法:单制表符 \t 的两类标准实现
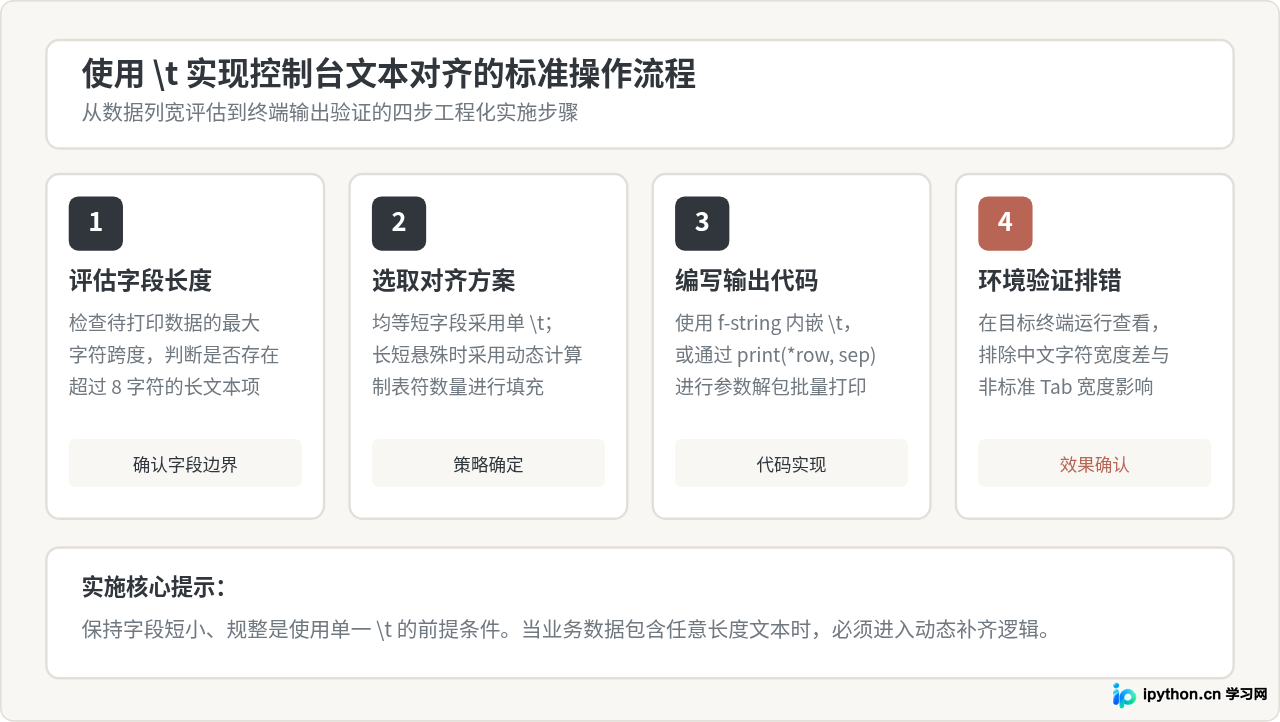
在日常开发中,如果预先知道各列数据的长度均较为简短(例如纯数字 ID、固定长度的状态码、简短英文缩写),单制表符便能以极少代码实现整洁的多列对齐输出。Python 提供了两种最常见的语法结构:
1. 使用 f-string 字符串内嵌格式化
在格式化字符串中直接插入 \t,结构清晰、可读性好,非常适合在拼装表头与数据行时明确定义各个列的位置关系:
# 示例:使用 f-string 内嵌制表符进行多列输出
headers = f"ID\tName\tRole\tScore"
print(headers)
print("-" * 32)

data = [
    (101, "Alice", "Dev", 92),
    (102, "Bob", "QA", 88),
    (103, "Cathy", "PM", 95),
]

for item_id, name, role, score in data:
    print(f"{item_id}\t{name}\t{role}\t{score}")
2. 借助 print() 函数的 sep 参数
Python 的内置 print() 函数支持 sep 参数(分隔符)。当需要打印元组、列表或多个独立参数时,将 sep='\t' 传入可免去手动拼接每个变量的繁琐:
# 示例:使用 sep 参数统一指定列分隔符
headers = ("ID", "Name", "Role", "Score")
print(*headers, sep="\t")
print("-" * 32)

records = [
    [101, "Alice", "Dev", 92],
    [102, "Bob", "QA", 88],
    [103, "Cathy", "PM", 95],
]

for row in records:
    print(*row, sep="\t")
执行上述代码后,终端的示例输出如下所示:
ID	Name	Role	Score
--------------------------------
101	Alice	Dev	92
102	Bob	QA	88
103	Cathy	PM	95
由于 "101"、"Alice"、"Dev" 等字符串长度均未超出第 1 个制表位(8 字符)的范围,每一列在遇到 \t 时都整齐停靠在相同的制表位上,列与列之间展现出整齐的垂直对齐效果。
三、进阶应对:长短不一字段的动态 \t 补齐算法
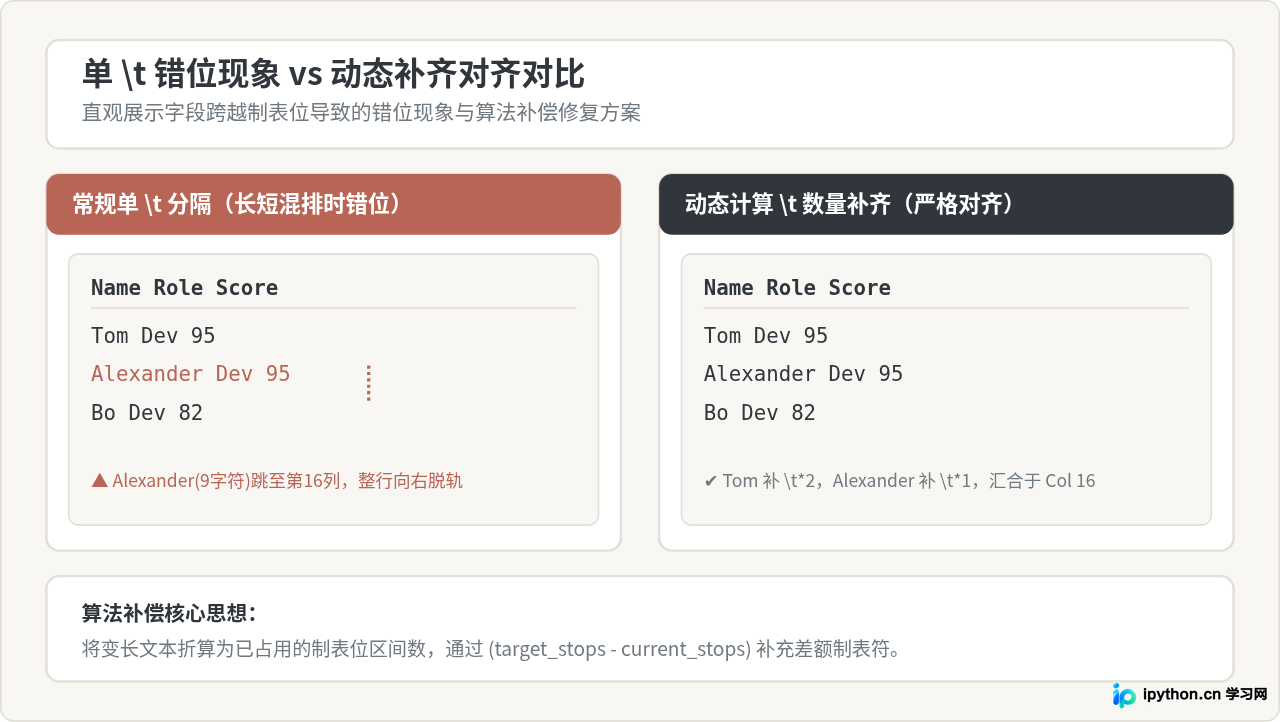
现实场景中的数据很少完全保持在 8 个字符以内。例如人名、邮箱或产品型号常常跨越 8 到 16 个字符。如果仍然机械地对每一项追加单个 \t,较短的项目跳至第 8 列,较长的项目跳至第 16 列,整张表格便会瞬间参差错位。
要解决这一问题,核心思路是:根据字段当前占用的字符数,动态计算需要追加的制表符数量,强制使该字段后的光标统一对齐到某个更高的目标制表位(例如统一对齐至第 16 列或第 24 列)。
动态计算制表符数量的通用公式
设终端制表位步长为 TAB_SIZE = 8,目标对齐列宽为 TARGET_WIDTH = 16(即占用 2 个制表位区间)。对于长度为 L 的字符串:
- 当
L < 8时:字符串占位 0~7 列,需要\t * 2才能跨过 Col 8 直达 Col 16。 - 当
8 <= L < 16时:字符串已进入 8~15 列区间,只需\t * 1即可停靠在 Col 16。
可以用整数运算推导出通用逻辑。在常规固定列宽场景下,编写如下辅助函数即可实现无缝对齐:
def align_tab(text: str, target_width: int = 16, tab_size: int = 8) -> str:
    """根据文本长度动态追加 \t,使其对齐到指定的 target_width 制表位"""
    length = len(text)
    if length >= target_width:
        return text + "\t"

    current_stops = length // tab_size
    target_stops = target_width // tab_size
    tabs_needed = target_stops - current_stops
    return text + ("\t" * max(1, tabs_needed))

# 实际测试数据
rows = [
    ("Tom", "Developer", 95),
    ("Alexander", "Manager", 88),
    ("Elizabeth", "Architect", 96),
    ("Bo", "Intern", 82),
]

print("=== 动态补齐制表符输出效果 ===")
print("Name\t\tRole\t\tScore")
print("-" * 40)
for name, role, score in rows:
    col1 = align_tab(name, target_width=16)
    col2 = align_tab(role, target_width=16)
    print(f"{col1}{col2}{score}")
通过该函数处理后,短人名 "Tom" 会获得两个 \t,一路推进到第 16 列;而长人名 "Alexander"(9 字符)只分配一个 \t,同样停靠在第 16 列。两行数据在此处完美汇合,第二列 Role 实现了整齐的垂直对齐。
四、使用 \t 对齐的局限性与替代方案选型
尽管 \t 极为轻巧,但在实际生产与多语言环境中,单纯依赖制表符也存在难以逾越的固有局限。开发者在选用时需要清楚以下两点边界限制:
1. 中英文字符的终端渲染宽度差异
在 Python 内部,len("中国") 返回的字符长度是 2。然而在终端显示层面,标准中文字符属于 East Asian Wide(宽字符),视觉上占据 2 个半角 ASCII 字符的宽度(即 4 个列宽)。
由于大多数终端的 Tab Stop 是按照实际光标列坐标或字节处理的,中英文字符混排会导致“逻辑字符数”与“终端物理列宽”发生脱节,极易引起制表位误判。如果在包含中文的表格中强行使用 \t,依然可能产生局部微小错位。
2. 不同运行环境的默认制表位宽度差异
Linux 默认终端、macOS 终端、Windows PowerShell 以及 VS Code 内置终端,对 \t 宽度的默认设置可能并不完全一致(有的预设为 8 列,有的预设为 4 列)。如果业务依赖硬编码的动态制表符步长,在跨环境执行时可能出现排版差异。
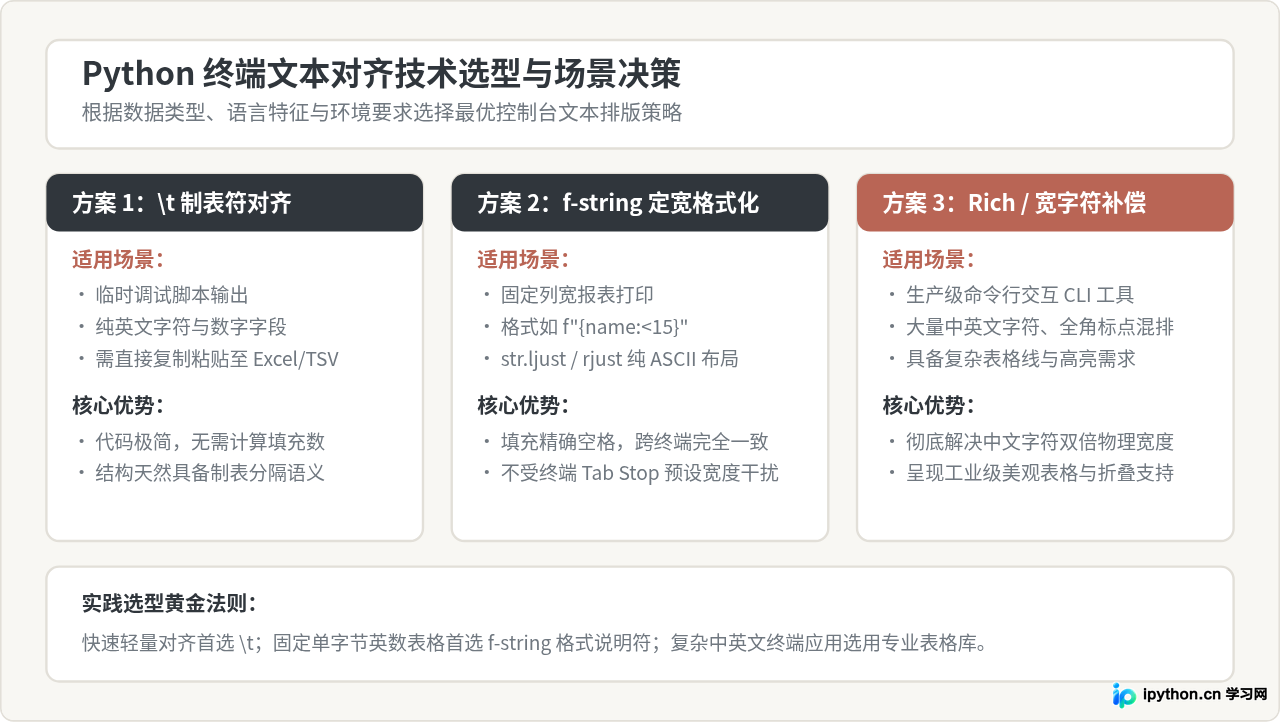
当输出内容包含中文、或者对列宽有极其严苛的绝对像素/字符级要求时,推荐使用 Python 的字符串格式化语法 f"{text:<15}"、str.ljust()、str.rjust(),或专门的控制台排版库(如 tabulate、rich)。它们通过填充标准空格来锁定绝对宽度,彻底规避了终端对 Tab 宽度的解释差异。
五、总结
在 Python 的 print() 输出中使用 \t 是实现控制台文本快速对齐的高效手段。其背后的本质是借助终端的制表位(Tab Stop)网格向前推进光标,而非固定插入空格。在数据字段规整、短小且以英数为主的场景中,通过 f-string 或 sep='\t' 能够以零依赖的优雅方式完成多列排版;而在字段长度跨度较大的场景下,通过预先计算长度并动态补充 \t,可以有效修复因跨越制表位而导致的错位问题。理解这些机制与边界,能让我们在日常脚本编写与数据打印时做出更精准的技术选择。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









