

Python实现扫描版PDF简单水印去除教程

本文介绍使用Python去除扫描版PDF中简单水印的方法。通过PyMuPDF提取页面图片,利用PIL库根据颜色特征识别并替换水印像素,最后将处理后的图片重新生成PDF。该方法适用于纯色或浅色背景的水印,对文字与水印混合的情况效果有限。
前言
最近在整理PDF文档时发现部分文件带有水印,因此尝试探索利用Python技术去除这些干扰性水印的可行性。
一、PDF文件
PDF文件主要分为两类:文本型PDF和扫描型PDF(即图片型)。本文所介绍的水印去除方案主要针对后者,即由图片构成的扫描版PDF文件。
二、思路整理
在编写具体代码之前,需要明确实现的整体逻辑流程。
1、分割图片
处理PDF的核心在于处理其包含的图片信息。因此,第一步是从PDF中提取所有嵌入的图片,并将其保存至指定目录。这一步骤依赖于模块,安装后即可使用。
pip install PyMuPDF
模块安装完成后,核心代码逻辑较为直观,主要注意需按顺序对提取的图片进行命名,具体实现如下。
def split_pdf(file_path, out_path):
    """
    切割pdf为图片
    :param file_path: pdf路径
    :param out_path: 输出图片路径
    :return: 输出路径
    """
    pdf = fitz.open(file_path)
    count = 0
    print("##### 开始保存切割图片 #####")
    for page in pdf:
        image_list = page.get_images()
        for img_info in image_list:
            pix = fitz.Pixmap(pdf, img_info[0])
            pix.save(os.path.join(out_path, '%d.jpg' % count))
            count += 1
    print("##### 保存切割图片完毕 #####")
    print("##### {0} 包含 {1} 张图片 #####".format(file_path, count))
    return out_path
2、去除水印
图片分割完成后,接下来的关键问题是如何区分水印与正常内容,以及确定替换的目标颜色。首先解决如何识别水印的问题。
- 按水印位置 一种直观的思路是根据水印的坐标位置和尺寸大小进行替换。然而,这种方法缺乏通用性,因为不同PDF文件中水印的位置和大小可能各不相同。此外,当水印与正文文字重叠时,这种基于位置的方法难以有效处理。
对于位置固定且不与文字重叠的水印,可以通过坐标定位进行去除。
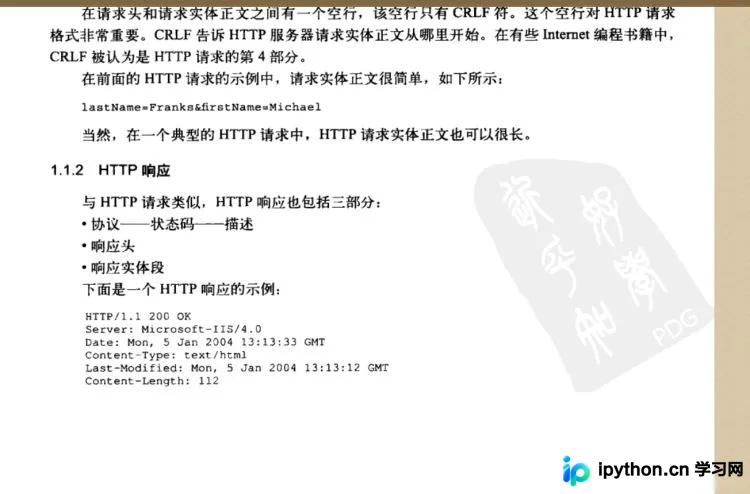
然而,当水印与文字混合在一起时,仅靠位置信息很难准确分离。
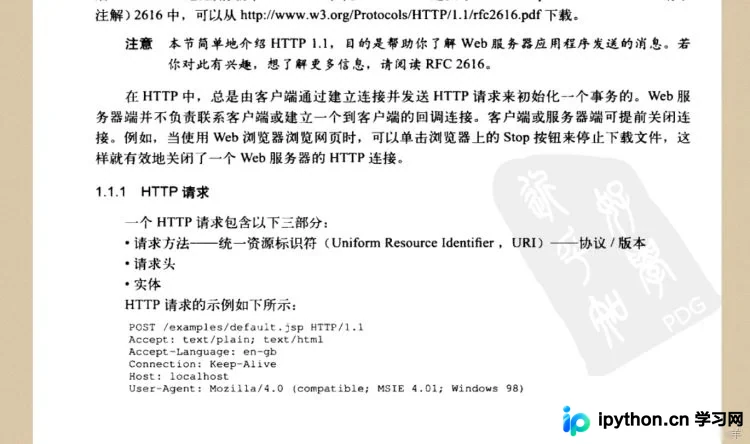
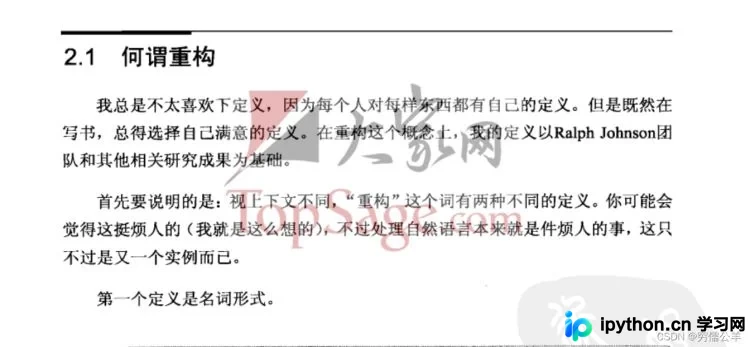
- 按颜色 观察发现,水印的颜色通常较浅(偏亮),而正文文字多为深色(如黑色或灰色)。因此,可以通过颜色阈值将较浅的颜色识别为水印并进行替换。但这种方法在遇到彩色文档时效果不佳,因为彩色内容可能包含浅色像素。
关于替换目标:如果文档仅包含简单的黑白灰颜色,可以直接将识别出的水印颜色替换为白色。
接下来展示相关代码实现,此处需要用到模块,安装方式如下。
pip install pillow
基于上述思路,核心处理代码如下。
def get_image_arr(img):
    """
    获取图片三色数组
    :param img:图片
    :return: 图片编码、三色数组
    """
    img_arr = np.asarray(img, dtype=np.double)
    # 分离通道
    r_img = img_arr[:, :, 0].copy()
    g_img = img_arr[:, :, 1].copy()
    b_img = img_arr[:, :, 2].copy()
    img = r_img * 256 * 256 + g_img * 256 + b_img
    return img, r_img, g_img, b_img


def replace_clr_color(img, src_clr, dst_clr):
    """
    通过矩阵操作颜色替换程序
    @param  img:    图像矩阵
    @param  src_clr:    需要替换的颜色(r,g,b)
    @param  dst_clr:    目标颜色        (r,g,b)
    @return             替换后的图像矩阵
    """

    img, r_img, g_img, b_img = get_image_arr(img)
    src_color = src_clr[0] * 256 * 256 + src_clr[1] * 256 + src_clr[2]

    # 索引并替换颜色
    r_img[img == src_color] = dst_clr[0]
    g_img[img == src_color] = dst_clr[1]
    b_img[img == src_color] = dst_clr[2]

    return compound_img(r_img, g_img, b_img)


def compound_img(r_img, g_img, b_img):
    """
    合并图片
    :param r_img: 红色
    :param g_img: 绿色
    :param b_img: 蓝色
    :return: 图片
    """
    # 合并通道
    dst_img = np.array([r_img, g_img, b_img], dtype=np.uint8)
    # 将数据转换为图像数据(h,w,c)
    dst_img = dst_img.transpose(1, 2, 0)
    return dst_img


def replace_pure_color(img, src_color, dst_color):
    """
    通过矩阵操作颜色替换程序(纯色)
    :param img: 图像矩阵
    :param src_color: 需要替换的颜色
    :param dst_color: 目标颜色
    :return: 图片
    """

    img, r_img, g_img, b_img = get_image_arr(img)
    src_color = src_color * 256 * 256 + src_color * 256 + src_color
    # 索引并替换颜色
    r_img[img >= src_color] = dst_color
    g_img[img >= src_color] = dst_color
    b_img[img >= src_color] = dst_color

    return compound_img(r_img, g_img, b_img)

def wipe_watermark(img_file, start_color):
    """
    去除图片水印
    :param start_color: 颜色起始替换位置
    :param img_file: 图片文件
    :return:
    """

    img = replace_pure_color(Image.open(img_file).convert('RGB'), start_color, 255)
    res_img = Image.fromarray(img)
    res_img.save(img_file)
3、替换图片
在保存去除了水印的图片后,下一步是将这些处理过的图片重新嵌入到原始PDF结构中。
由于原始PDF可能包含书签、超链接等其他元数据,我们在替换图片前需先读取原始文件结构,然后进行图片替换。具体代码实现如下。
def save_pdf(src_pdf, dest_pdf, file_list):
    """
    生成最终pdf文件
    :param src_pdf: 源文件
    :param dest_pdf: 目标文件
    :param file_list: 图片列表
    :return:
    """
    pdf = fitz.open(src_pdf)
    index = 0
    try:
        for page in pdf:
            # 去除超链接
            for link in page.get_links():
                page.delete_link(link)
            # 替换图片
            for img in page.get_images():
                page._insert_image(filename=file_list[index], _imgname=img[7])
                index = index + 1
        pdf.save(dest_pdf)
    finally:
        pdf.close()
三、实现效果
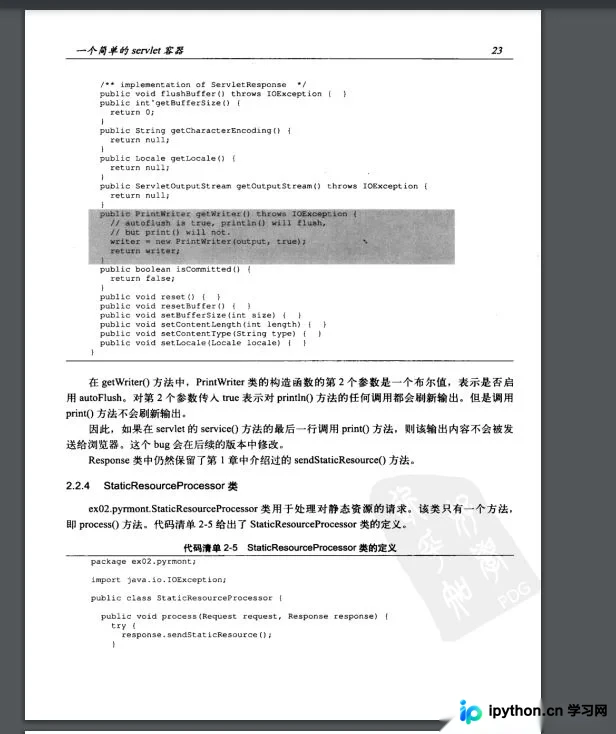
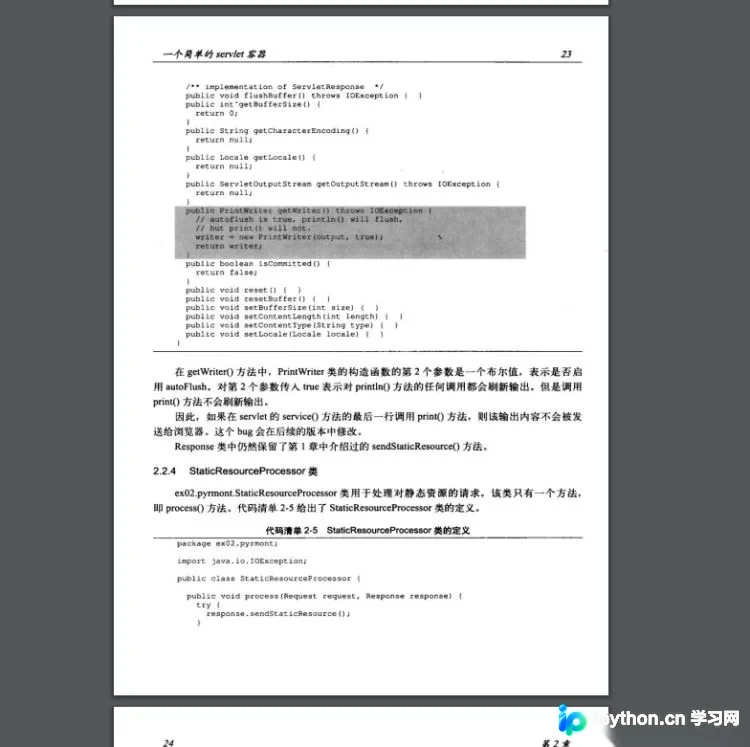
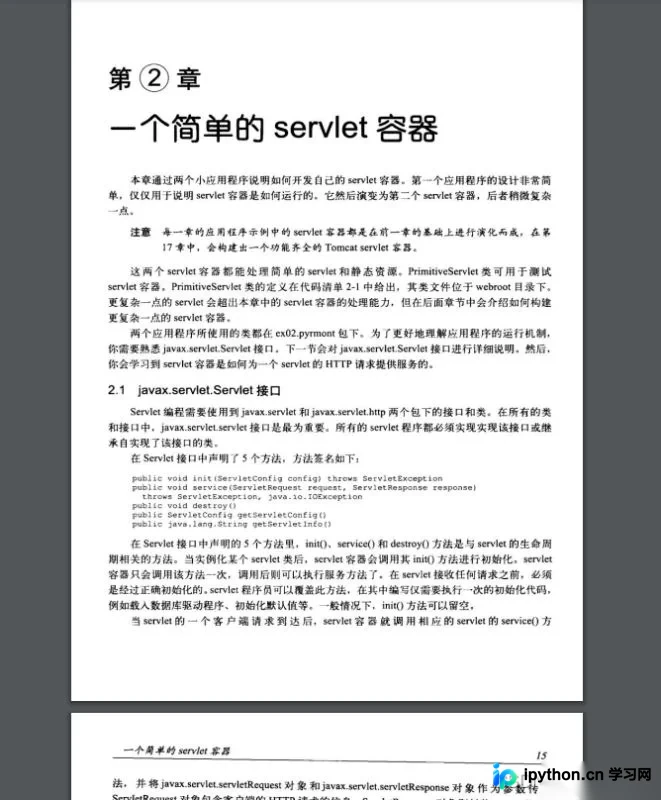
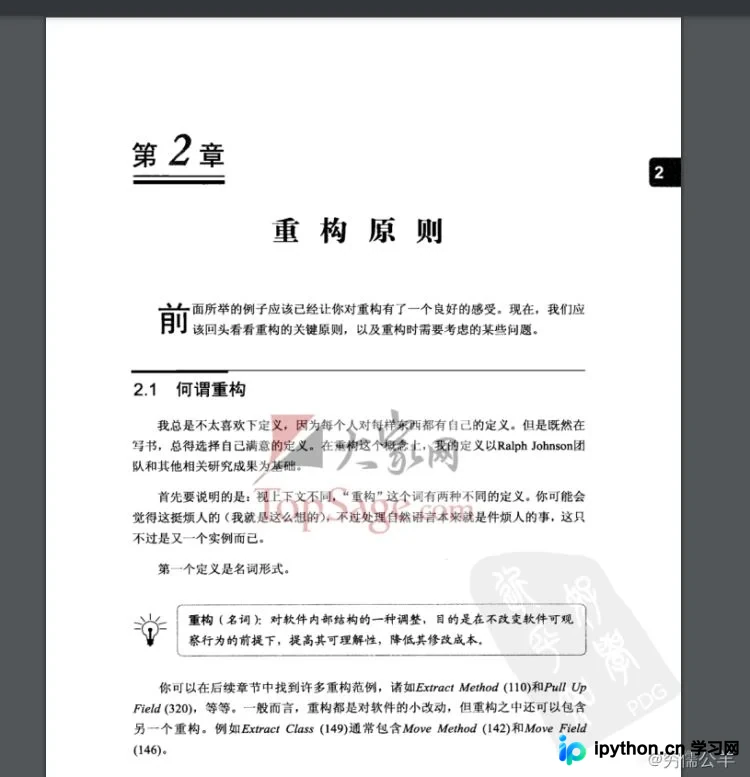
代码编写完成后,我们使用两个PDF文件进行了测试,以验证去水印效果。第一个PDF的测试结果如下。
去除水印前:
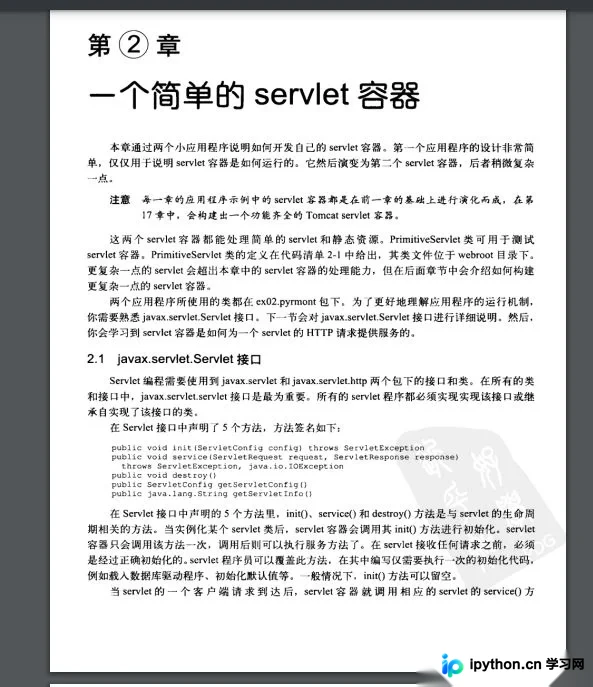
去除水印后:
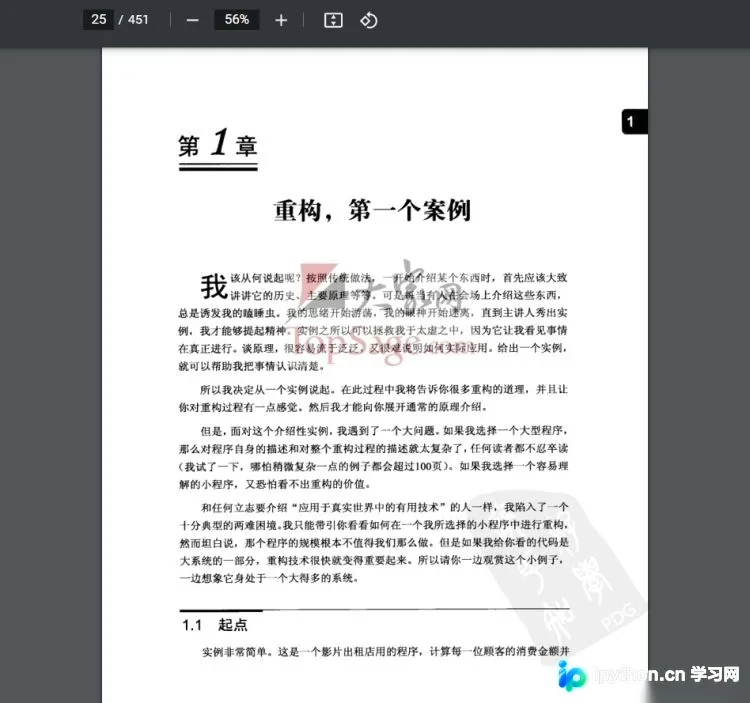
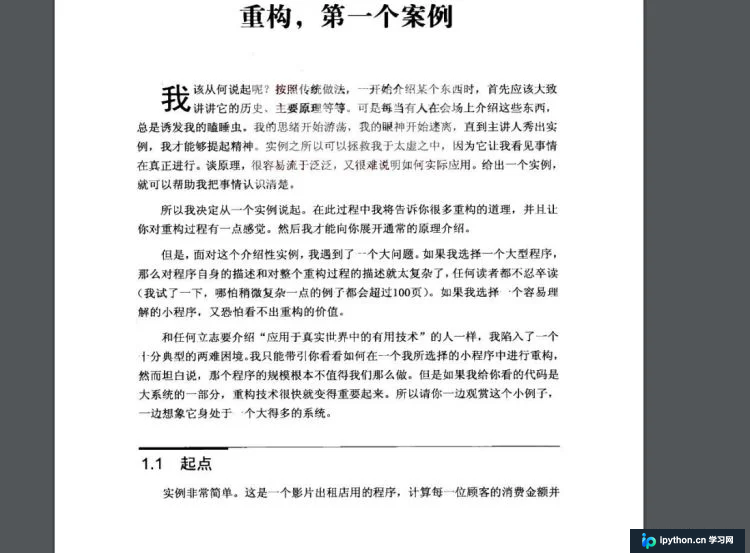
第二个PDF的测试结果如下。
去除水印前:
去除水印后:
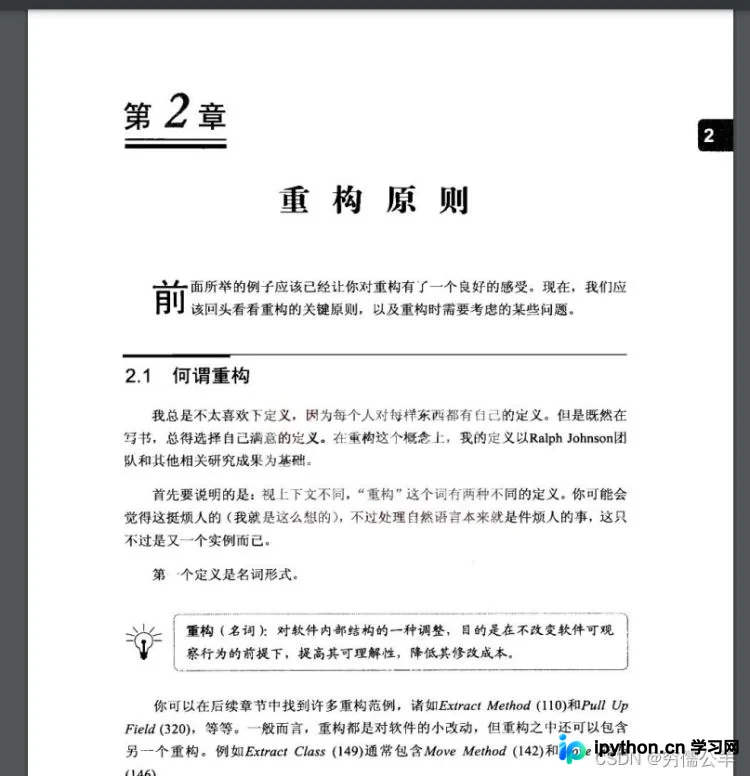
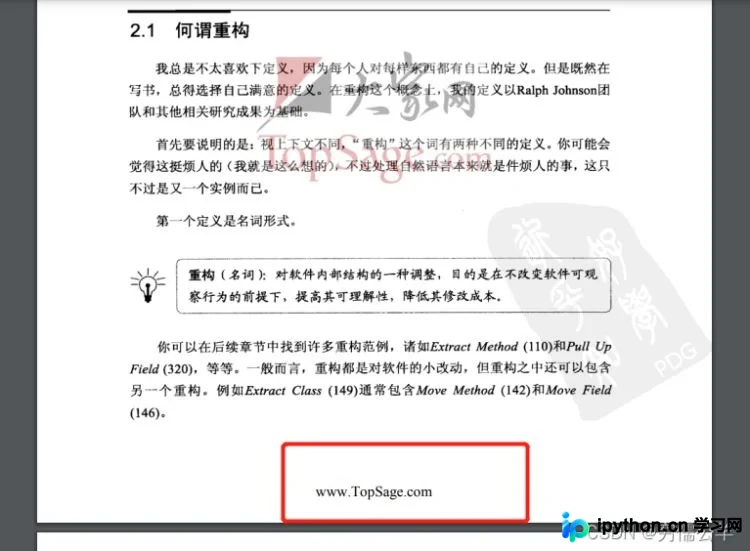
整体效果尚可。不过需要注意的是,对于包含文字Logo的水印,查阅文档后发现目前方法难以处理,例如此类情况。
四、代码实现
完整的Python代码如下。
import os

import fitz
import numpy as np
from PIL import Image


def split_pdf(file_path, out_path):
    """
    切割pdf为图片
    :param file_path: pdf路径
    :param out_path: 输出图片路径
    :return: 输出路径
    """
    pdf = fitz.open(file_path)
    count = 0
    print("##### 开始保存切割图片 #####")
    for page in pdf:
        image_list = page.get_images()
        for img_info in image_list:
            pix = fitz.Pixmap(pdf, img_info[0])
            pix.save(os.path.join(out_path, '%d.jpg' % count))
            count += 1
    print("##### 保存切割图片完毕 #####")
    print("##### {0} 包含 {1} 张图片 #####".format(file_path, count))
    return out_path


def get_image_arr(img):
    """
    获取图片三色数组
    :param img:图片
    :return: 图片编码、三色数组
    """
    img_arr = np.asarray(img, dtype=np.double)
    # 分离通道
    r_img = img_arr[:, :, 0].copy()
    g_img = img_arr[:, :, 1].copy()
    b_img = img_arr[:, :, 2].copy()
    img = r_img * 256 * 256 + g_img * 256 + b_img
    return img, r_img, g_img, b_img


def replace_clr_color(img, src_clr, dst_clr):
    """
    通过矩阵操作颜色替换程序
    @param  img:    图像矩阵
    @param  src_clr:    需要替换的颜色(r,g,b)
    @param  dst_clr:    目标颜色        (r,g,b)
    @return             替换后的图像矩阵
    """

    img, r_img, g_img, b_img = get_image_arr(img)
    src_color = src_clr[0] * 256 * 256 + src_clr[1] * 256 + src_clr[2]

    # 索引并替换颜色
    r_img[img == src_color] = dst_clr[0]
    g_img[img == src_color] = dst_clr[1]
    b_img[img == src_color] = dst_clr[2]

    return compound_img(r_img, g_img, b_img)


def compound_img(r_img, g_img, b_img):
    """
    合并图片
    :param r_img: 红色
    :param g_img: 绿色
    :param b_img: 蓝色
    :return: 图片
    """
    # 合并通道
    dst_img = np.array([r_img, g_img, b_img], dtype=np.uint8)
    # 将数据转换为图像数据(h,w,c)
    dst_img = dst_img.transpose(1, 2, 0)
    return dst_img


def replace_pure_color(img, src_color, dst_color):
    """
    通过矩阵操作颜色替换程序(纯色)
    :param img: 图像矩阵
    :param src_color: 需要替换的颜色
    :param dst_color: 目标颜色
    :return: 图片
    """

    img, r_img, g_img, b_img = get_image_arr(img)
    src_color = src_color * 256 * 256 + src_color * 256 + src_color
    # 索引并替换颜色
    r_img[img >= src_color] = dst_color
    g_img[img >= src_color] = dst_color
    b_img[img >= src_color] = dst_color

    return compound_img(r_img, g_img, b_img)


def list_file(path, suffix=None):
    """
    获取指定目录下指定后缀文件
    :param path: 路径
    :param suffix: 后缀名
    :return: 文件集合
    """
    file_names = os.listdir(path);
    # 获取文件名
    if suffix is not None:
        file_names = [file_name for file_name in file_names if file_name.endswith(suffix)]
    file_names.sort(key=lambda x: int(x[:(-len(suffix))]))
    # 文件名拼接路径
    return [os.path.join(path, file) for file in file_names]


def wipe_watermark(img_file, start_color):
    """
    去除图片水印
    :param start_color: 颜色起始替换位置
    :param img_file: 图片文件
    :return:
    """

    img = replace_pure_color(Image.open(img_file).convert('RGB'), start_color, 255)
    res_img = Image.fromarray(img)
    res_img.save(img_file)


def save_pdf(src_pdf, dest_pdf, file_list):
    """
    生成最终pdf文件
    :param src_pdf: 源文件
    :param dest_pdf: 目标文件
    :param file_list: 图片列表
    :return:
    """
    pdf = fitz.open(src_pdf)
    index = 0
    try:
        for page in pdf:
            # 去除超链接
            for link in page.get_links():
                page.delete_link(link)
            # 替换图片
            for img in page.get_images():
                page._insert_image(filename=file_list[index], _imgname=img[7])
                index = index + 1
        pdf.save(dest_pdf)
    finally:
        pdf.close()


def start(file_path, dest_path, start_color, out_path=r'out'):
    if os.path.exists(out_path):
        # shutil.rmtree(out_path)
        raise FileExistsError('文件夹:{0} 已存在'.format(out_path))
    os.mkdir(out_path)

    print("####### 开始切割pdf:{0} #######".format(file_path))
    split_pdf(file_path, out_path)
    print("####### 切割pdf完毕:{0} #######".format(file_path))
    # 获取文件名
    file_list = list_file(out_path, ".jpg")

    print("####### 开始去除水印 #######")
    for img_file in file_list:
        wipe_watermark(img_file, start_color)
    print("####### 去除水印结束 #######")

    # 生成pdf
    print("####### 生成pdf文件:{0} #######".format(dest_path))
    save_pdf(src_pdf=file_path, dest_pdf=dest_path, file_list=file_list)
    print("####### 生成pdf文件:{0} 完成 #######".format(dest_path))
    # make_pdf(dest_path, file_list)


if __name__ == '__main__':
    # replace_pdf(src_pdf="深入剖析TOMCAT.pdf", dest_pdf='a.pdf', file_list=list_file('out', ".jpg"))
    # www.TopSage.com
    start(file_path="重构-改善既有代码的设计.pdf", dest_path="b.pdf", start_color=175)
总结
该实现方案相对简单,主要适用于去除背景为纯色或浅色的扫描版PDF水印。
以上即为使用Python去除PDF简单水印的示例详情,更多关于Python处理PDF的相关资料,请参阅本站其他技术文章。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









