

Python使用pdfplumber库将PDF转换为图片的方法

本文介绍如何使用Python的pdfplumber库将PDF文件转换为图片。首先通过pip安装并验证版本,接着演示导入库、指定路径、打开PDF、遍历页面、转换图像及保存文件的完整流程,帮助开发者快速实现PDF到图片的批量处理。
前言
本文主要介绍《通过Python的pdfplumber库将pdf转为图片》的具体实现步骤。
一、pdfplumber库是什么?
pdfplumber是一款Python库,专门用于从PDF文档中提取文本和表格数据。它能够协助用户轻松获取PDF中的关键信息,如表格、文本内容及元数据等。该库具备简单易用、处理速度快、兼容多种PDF格式以及支持多页面数据提取等特点。此外,它还提供了排序、过滤和格式化等便捷方法,便于对提取的数据进行后续处理。在处理大量PDF文件的数据提取任务时,这是一个非常实用的工具。
二、安装pdfplumber库
pip install pdfplumber
三、查看pdfplumber库版本
pip show pdfplumber
Name: pdfplumber Version: 0.9.0 Summary: Plumb a PDF for detailed information about each char, rectangle, and line. Home-page: https://github.com/jsvine/pdfplumber Author: Jeremy Singer-Vine Author-email: jsvine@gmail.com License: Requires: pdfminer.six, Pillow, Wand Required-by:
四、pdf素材
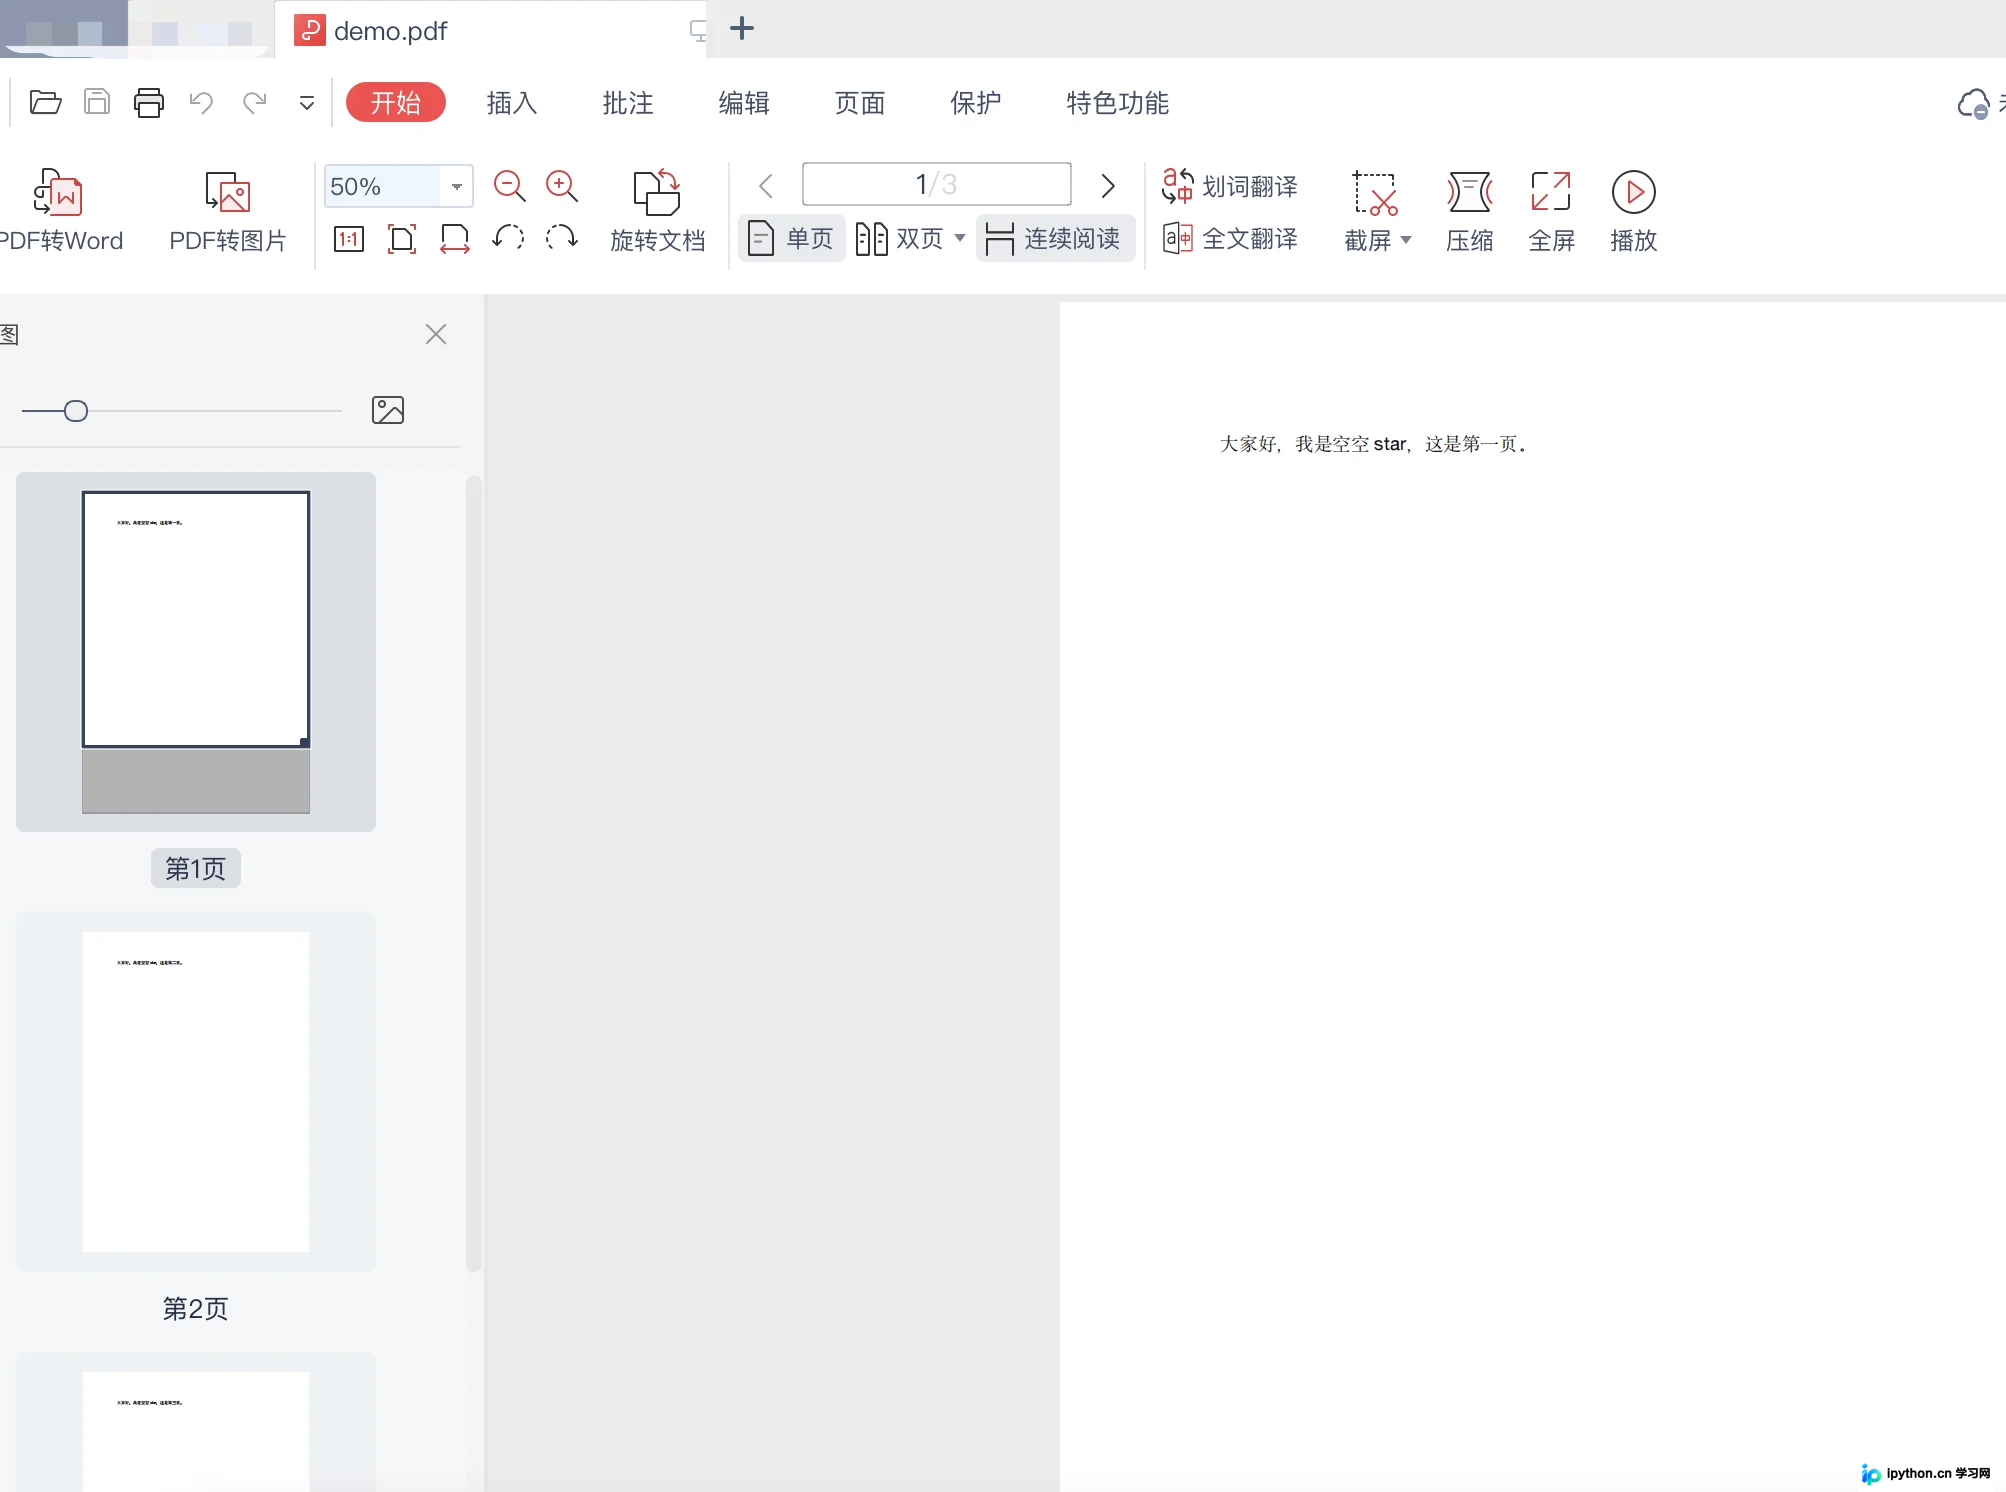
五、将pdf转为图片
1.引入库
import pdfplumber
2.定义pdf路径
local = '/Users/kkstar/Downloads/'
3.打开PDF文件
with pdfplumber.open(local+'demo.pdf') as pdf:
4.遍历每一页
for i, page in enumerate(pdf.pages):
5.将PDF页面转换为Image对象
img = page.to_image()
6.将Image对象保存为图片文件
img.save(local+f"page_{<!--{cke_protected}{C}%3C!%2D%2D%20%2D%2D%3E-->i+1}.png")7.效果
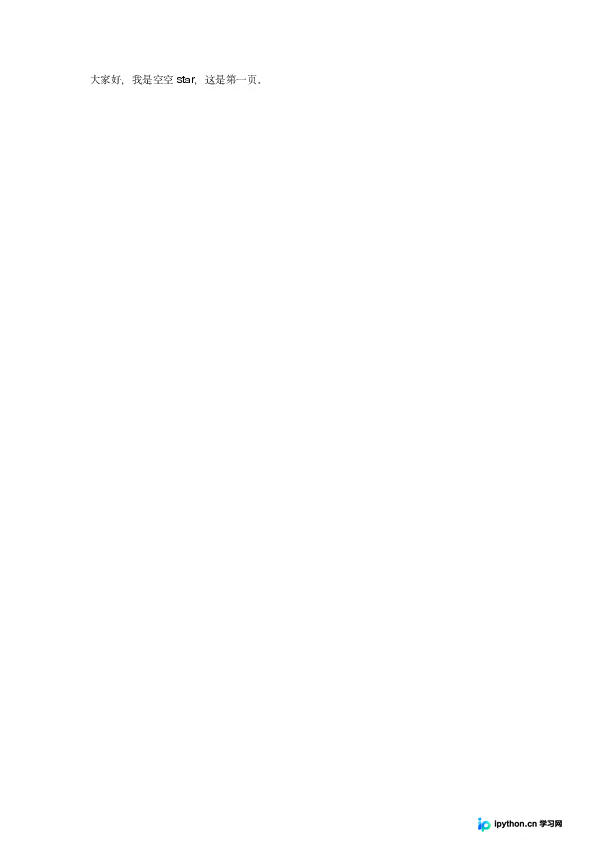
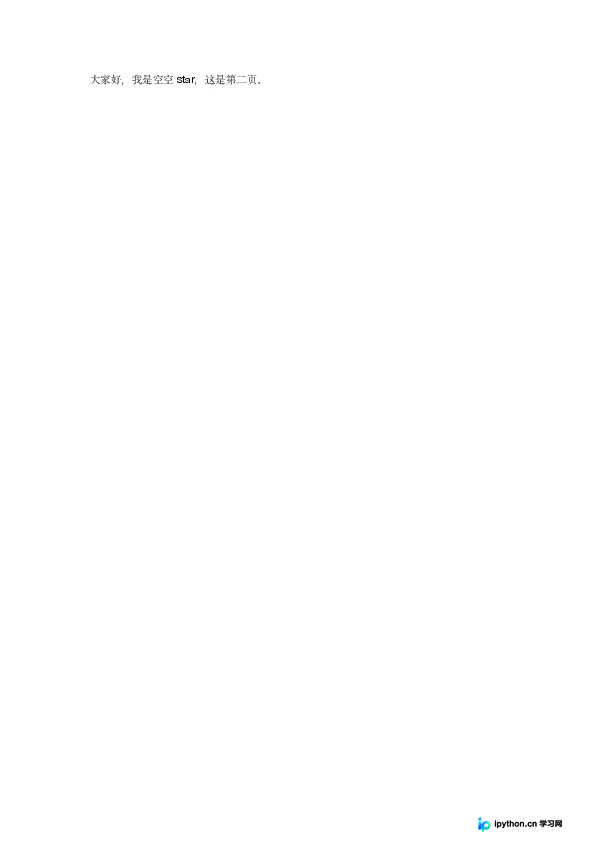
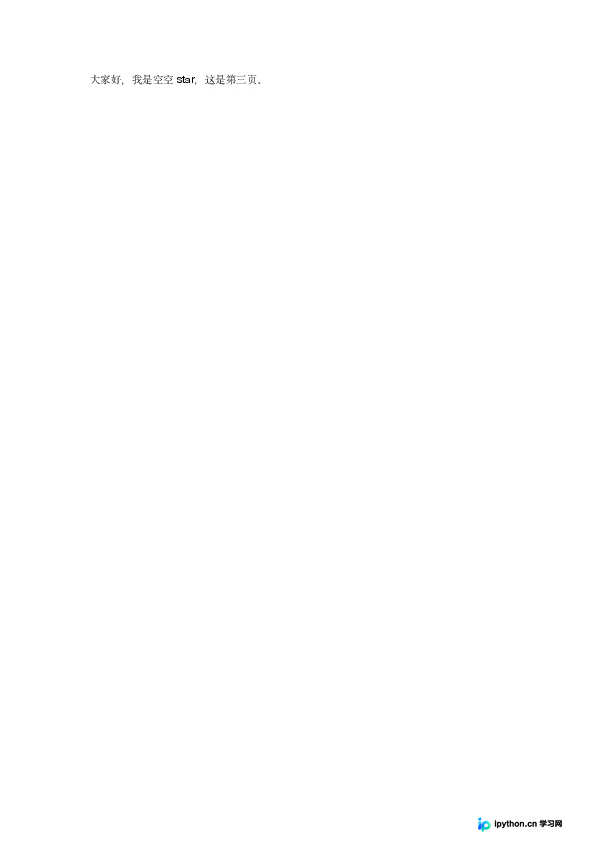
总结
至此,关于Python利用pdfplumber库将PDF转换为图片的教程已介绍完毕。如需了解更多Python处理PDF转图片的相关内容,欢迎查阅本站往期文章或继续浏览后续文章,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









