

SQL Server AlwaysOn因网络抖动导致提交延迟的解决方案

在业务高峰期,若数据库服务器与应用服务器共用交换机且上联端口流量打满,极易导致AlwaysOn同步连接频繁断开。本文记录如何识别由网络抖动引起的35202副本恢复错误,并通过启用独立网卡直连、重建Endpoint及修改Replica URL的方式,将数据镜像流量与应用流量物理隔离,彻底解决写入延迟问题。
结果或目标
近期研发反馈,某数据库在从测试环境(08)切换到生产环境(12)后,不定期出现写操作提交延迟。在排除系统资源争用因素后,分析表明根本原因在于机房网络环境复杂:数据库服务器和应用服务器混用同一交换机,高峰期上联带宽饱和导致TCP连接不稳定,进而引发AlwaysOn同步节点出现会话超时。
准备条件
现有环境特征:
- AG模式:两节点同步模式。
- 网络现状:两个节点各有一块网卡连接交换机,未配置独立的WSFC心跳线(微软已不再强制要求独立心跳网络)。
- 瓶颈位置:交换机上联端口流量拥塞。
真实操作顺序
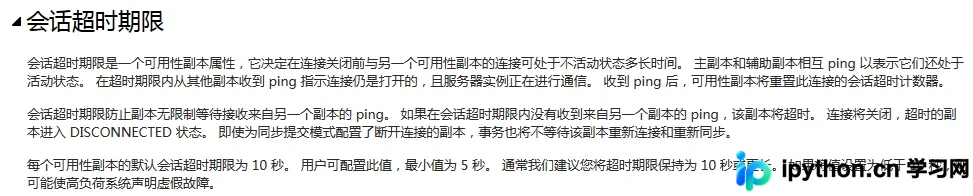
第1步:排查故障根源
目的:确认延迟是否由网络连接波动引起。
动作:检查SQL Server扩展事件日志。
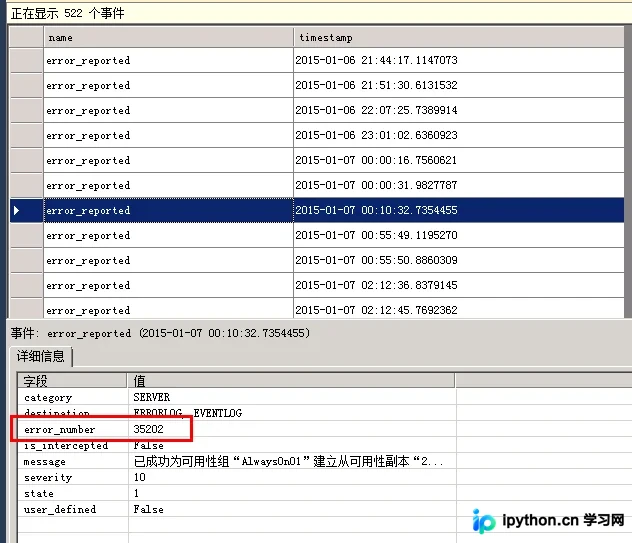
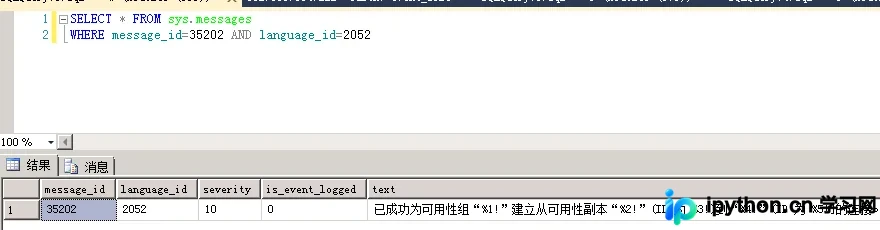
排查结果显示,系统中不定期出现 35202 错误。这是一条典型的“副本连接恢复”消息,意味着镜像端点之间的TCP连接意外中断并尝试重连,这正是造成事务提交阻塞的直接原因。
第2步:部署直连通信链路
目的:为AlwaysOn同步创建一条不受应用流量干扰的物理通道。
入口:操作系统网络适配器设置。
动作:在两节节点分别启用一块额外网卡,进行物理直连,并配置私有地址。
参数:
Server_B:10.0.0.12
第3步:重置数据库镜像端点
目的:让Hadr_Endpoint绑定到新的直连IP,监听内部同步流量。
风险提醒:删除Endpoint会导致两副本暂时进入未同步状态,但侦听器(Listener)和AG组中的数据库不受影响,主副本服务对应用依然正常。
动作:在两个节点分别执行以下脚本,务必将 LISTENER_IP 替换为直连网卡的IP地址:
第4步:更新Availability Group配置
目的:告诉AG管理器使用新IP进行节点间通信。
入口:主副本所在节点。
动作:在主副本执行脚本,修改每个Replica的Endpont_URL为直连IP:
第5步:验证与观察
完成判断:脚本执行完毕后,观察扩展事件。
等待数据重新同步。在 35202 错误消失后,说明同步通道已稳定运行于直连网络上,不再受外部交换机拥堵的影响。
简要总结
当机房网络环境无法立即改造时,通过硬件级别的隔离(多网卡+直连)是解决SQL Server AlwaysOn网络抖动的最稳妥方案。该方案核心在于“动静分离”,即把高频变动的镜像同步流量与应用层访问流量在物理链路上分开。
以上就是SQLServer AlwaysOn中设置AlwaysOn解决网络抖动导致的提交延迟问题的详细内容,更多关于SQLServer数据库优化排错的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









