

SQL 聚集索引与非聚集索引:原理、选择与避坑指南

理解 SQL 数据库中聚集索引(Clustered Index)与非聚集索引(Non-clustered Index)的物理存储结构及逻辑差异,是提升查询性能的关键。本文详细阐述两者的工作原理,提供基于业务场景的选型标准,并通过实例分析揭示主键默认聚集等常见误区,帮助开发者建立高效的索引策略。
核心概念:物理顺序 vs 逻辑引用
要区分这两种索引,最直观的类比是汉语字典:
- 聚集索引(Clustered Index):相当于字典正文
聚集索引决定了表中数据行的物理存储顺序。就像字典按拼音排序,正文内容本身就是有序的。因为物理上只能有一种排列方式,所以每个表只能有一个聚集索引。 - 非聚集索引(Non-clustered Index):相当于部首目录或检字表
非聚集索引的逻辑顺序与磁盘上行数据物理顺序无关。它类似字典前的目录,查到一个条目后,需要携带一个“页码指针”去正文中定位具体数据。
在数据结构上,两者通常都基于 B+树实现,但叶节点存储的内容不同:
- 聚集索引的叶节点直接包含完整的数据行。
- 非聚集索引的叶节点包含索引键值和指向数据行的指针(RID 或聚集键)。
这种结构差异导致以下图示中的直观对比:
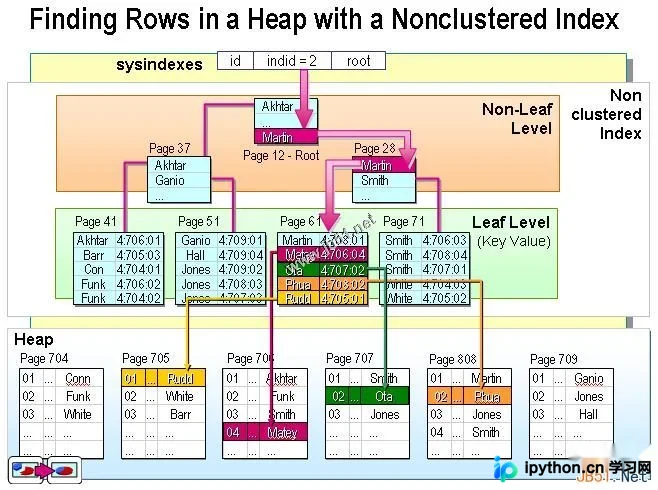
(图示展示非聚集索引结构与聚簇索引结构的差异)
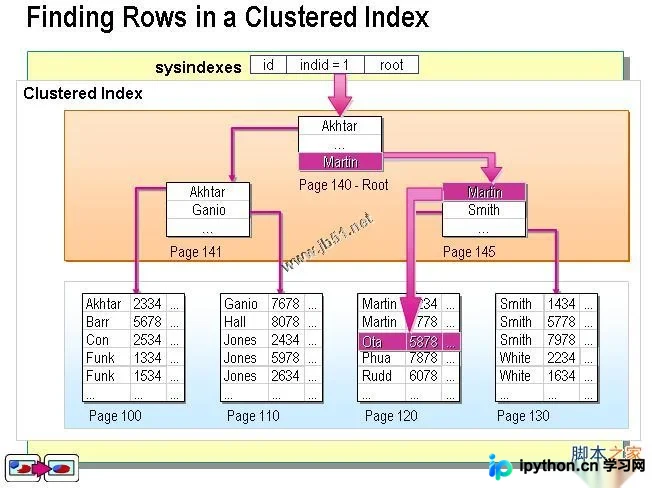
何时使用:集群与非聚集的选择策略
索引并非越多越好,盲目创建不仅占用空间,还会降低写入性能。以下是针对不同数据访问特征的建议:
| 操作场景/特征 | 推荐聚集索引 | 推荐非聚集索引 |
|---|---|---|
| 范围查询(如日期区间) | 强烈应使用 | 不推荐 |
| 高频分组与排序 | 建议使用 | 可使用 |
| 主键列 / 外键列 | 建议使用 | 也可使用 |
| 频繁更新的列 | 严禁使用 | 可以使用 |
| 低基数列(值极少) | 不建议 | 不建议 |
| 高基数列(值很多且均匀) | 不推荐 | 应该使用 |
实战避坑:常见的索引建立误区
许多开发者对索引的理解停留在表面,以下三个误区会导致严重的性能问题。
误区一:主键必须等同于聚集索引
虽然数据库系统默认在 PRIMARY KEY 上创建聚集索引,但这通常是出于便利而非最佳实践。
反面案例:
假设一张表有 1000 万条记录,ID 是自增整数,用户经常查询最近 3 个月的文件,且按发文日期 fariqi 进行范围排序。
如果将 ID 设为聚集索引:
- 查询范围数据时,必须先通过非聚集索引找到
ID和对应的页码指针,然后回表读取数据。由于范围数据在物理上分散,回表成本极高。 - 测试结果(提取 25 万条数据):
- 仅主键聚集 + 非聚集日期索引:耗时约 54秒(甚至超时)。
修正方案:
将 fariqi(日期)字段设为聚集索引。此时,相同时间段的数据在物理上是相邻存储的。
- 查询范围数据时,直接定位起始行,连续读取相邻页面即可,无需随机回表。
- 测试结果:
- 日期列作为聚集索引:耗时仅需 2.4秒。
误区二:索引覆盖与最左前缀原则
当建立复合聚集索引时,必须遵循最左前缀匹配原则。此外,聚集索引的叶节点自带所有列数据,天然支持索引覆盖。
测试场景:
复合聚集索引列为 (fariqi, neibuyonghu)。
- 查询条件包含首列(日期):速度极快(约 2.5 秒),因为可以直接定位到物理区块。
- 查询条件仅包含末列(用户名):索引失效,退化为全表扫描(耗时约 60 秒),因为物理文件无法直接根据第二列有序查找。
- 结论:无论后续列是否有用,聚集索引的第一列必须是最高频用于检索和排序的字段。
误区三:只要建了索引就能快
对于小数据集(如几千条),索引的提升效果不明显;对于大数据集,错误的索引类型(如在非范围查询列使用聚集索引)甚至会拖慢速度。关键在于让索引的物理顺序贴合查询需求。
性能优化的关键总结
经过大量实测数据的对比,可以得出以下关于聚集索引特性的结论:
- 范围查询优势巨大:利用聚集索引的物理连续性,时间复杂度接近 O(1) 定位起点,遍历效率远高于非聚集索引。
- 排序(Order By)零开销:因为数据已经是物理有序的,直接使用聚集索引排序比先查找非聚集索引再额外排序要快得多。
- 时间精度不影响性能:无论是精确到天还是秒,只要统计的时间窗口占比一致,查询时间基本保持线性比例关系。
- 适度原则:过多的索引会增加更新时的维护成本(写放大)并可能导致索引碎片。请仅在那些被高频用于
WHERE过滤、范围查询或ORDER BY的列上建立索引。
以上就是 SQL 聚集索引和非聚集索引的详细解析与选型指南,更多关于 SQL 语句优化与数据库调优的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









