

MySQL InnoDB Buffer Pool 运行机制与调优详解

InnoDB 通过内存中的 Buffer Pool 缓存磁盘页来加速读写。本文详细拆解其核心组件,包括用于检索的控制块、LRU链表的Young/Old双区老化机制,以及多实例与动态扩容的配置方法。
1. Buffer Pool 运行原理
InnoDB 将磁盘数据划分为固定大小的页(Page),默认通常为 16KB。当应用程序需要读取或修改某条记录时,InnoDB 会加载包含该记录的整页数据到内存中。这种设计的核心在于计算机系统的“局部性原理”,即当前访问的数据附近很可能在接下来的时间被再次访问。通过将整个页预加载到内存,可以大幅降低缓慢的随机磁盘 I/O,从而显著提升整体性能。
第1步:启动与分配内存
当 MySQL 服务器启动时,InnoDB 会向操作系统申请一块连续的内存空间作为 Buffer Pool,用于缓存这些索引页和数据页。如果申请的物理内存不足,InnoDB 会优先使用最大可用内存。
mysql> SHOW VARIABLES LIKE 'innodb_buffer_pool_size';
+-------------------------+-----------+
| Variable_name           | Value     |
+-------------------------+-----------+
| innodb_buffer_pool_size | 134217728 |
+-------------------------+-----------+
理论上限上,Buffer Pool 越大,能容纳的页面越多,缓存命中率越高。对于生产环境,建议将其设置为物理内存的 70%
~ 80%,确保系统有足够的剩余内存处理操作系统和其他任务。在配置文件 [mysqld] 段中进行设定:
innodb_buffer_pool_size=1073741824
innodb_buffer_pool_instances=4
注意,单个 Buffer Pool 的最小容量限制为 5MB。即使配置低于此值,InnoDB 也会自动应用最小阈值。
2. Buffer Pool 内部结构
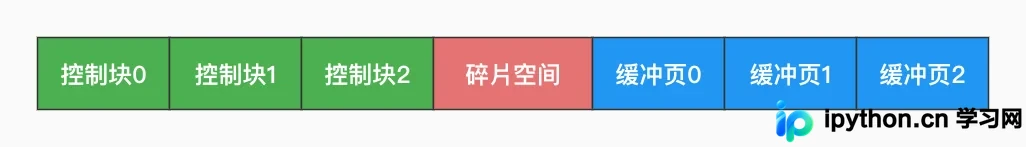
为了高效管理庞大的内存页,InnoDB 采用了一种复杂的内部数据结构,由多个双向链表组成。每个被内存承载的页都有一个对应的“控制块”(Block),其中记录了表空间 ID、页号以及链表节点指针。
第2步:Free 链表与哈希查找
当需要从磁盘加载新页面时,必须先在空闲的缓冲页中寻找位置。所有的空闲页都会被串联在 Free 链表中。从 Free 链表中获取一个空位远比遍历整个内存空间要高效得多。
一旦页被加载进内存,InnoDB 会在内存中的哈希表(Hash Table)里记录该页的位置。Key 是(表空间ID + 页号),Value 是对应的控制块地址。这使得后续查询可以在 O(1) 的时间复杂度内直接定位,而无需再执行全表扫描式的搜索。
第3步:LRU 链表的管理策略
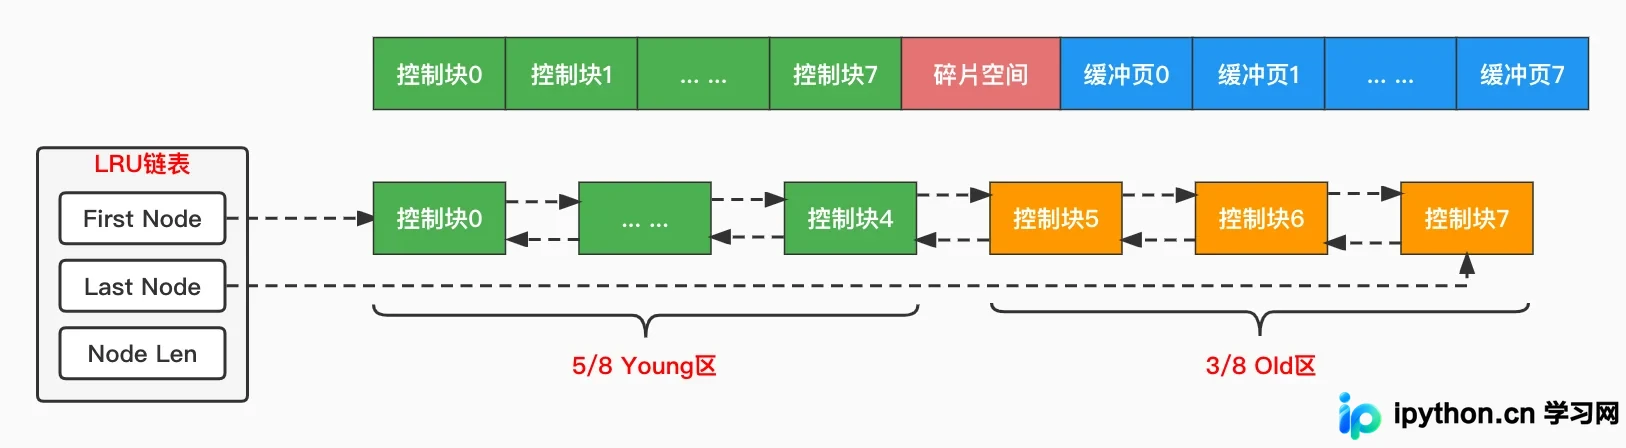
已使用的页面会被移入 LRU(Least Recently Used,最近最少使用)链表。然而,简单的头部插入尾部淘汰在以下两种情况下会造成灾难性的“误杀”:**全表扫描**和**异步预读**。这些操作会将大量低频访问的大范围页面强行挤入链表头部,反而把高价值的热点数据挤出内存。**为解决这一问题,InnoDB 采用了经典的 Old/Young 优化方案**: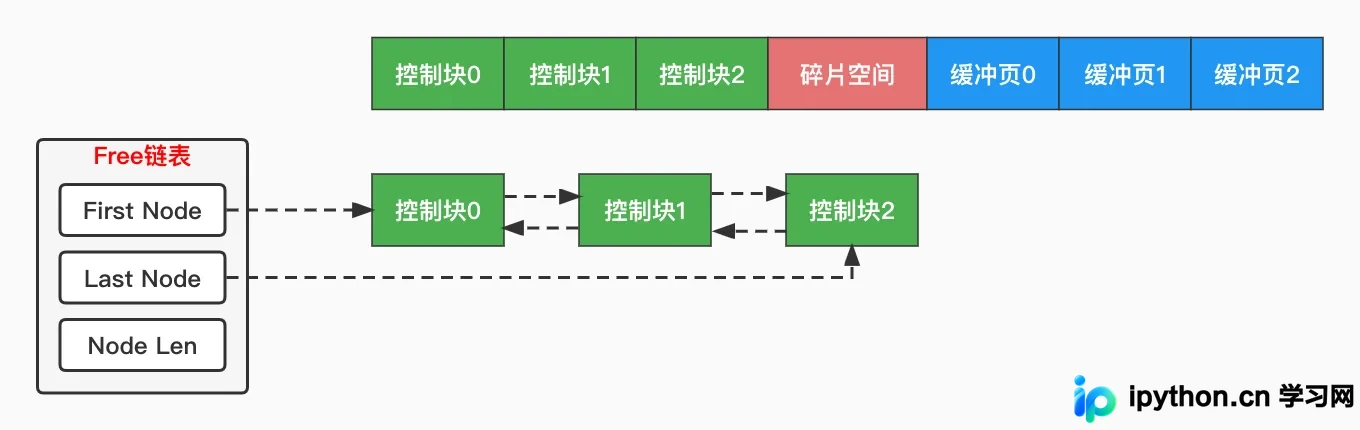
- Old 区(约占 3/8):刚首次加载或被异步预读的页面先进入此处。如果在设定的时间内(默认
1000ms)没有再次被访问,它们将被直接淘汰回收。 - Young 区(约占 5/8):只有在 Old 区停留足够久并被二次访问后,页面才会晋升到这里。Young 区的页面代表了高频热点数据。
这种双区设计有效保护了核心业务数据的缓存命中。此外,若访问频率极高(位于 Young 区前 1/4 处),移动开销也会被省略以节省锁资源。
第4步:Flush 链表与脏页刷盘
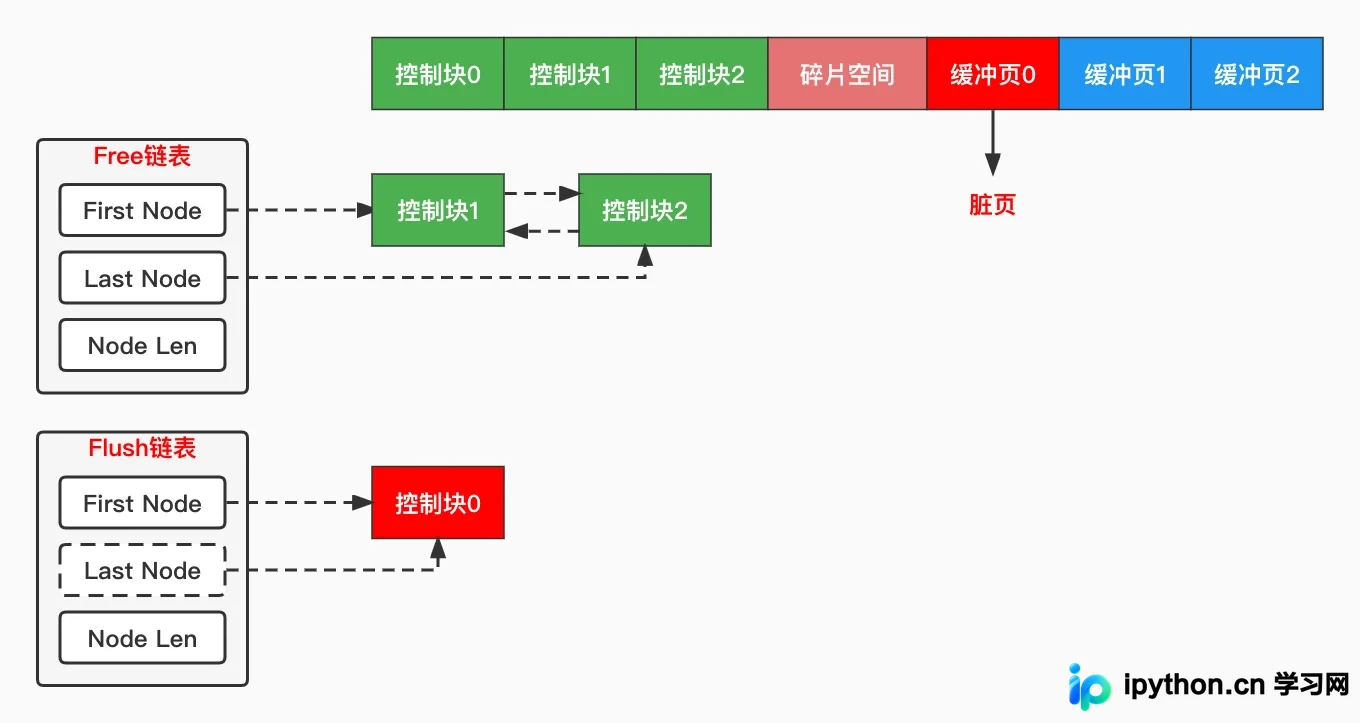
为了防止每次修改都导致即时且昂贵的磁盘写入,InnoDB 会将受影响的页标记为“脏页”。这些脏页被统一维护在 Flush 链表中,等待后台的持久化线程统一刷入磁盘。由于断电会导致未落盘的脏页丢失,因此必须依赖 **redo log** 来保障事务日志与最终落盘的一致性。通过分离内存修改与磁盘刷盘,InnoDB 实现了极高的并发写入吞吐量。
3. 高并发场景:多实例与运行时扩容
随着连接数增加,所有线程竞争同一个 Buffer Pool 链表的锁会导致严重的性能瓶颈。为此,MySQL 引入了 Buffer Pool 分片机制(Instances)。每个分片拥有独立的 LRU 和 Hash 表。在高并发系统中,通常根据 CPU 核心数或连接池大小,将其调整为 4 ~ 8 个实例:
SHOW VARIABLES LIKE 'innodb_buffer_pool_instances';
第5步:调整 Buffer Pool 大小
在旧版本中,调整 Buffer Pool 大小需要重启服务并经历漫长的拷贝过程。自 5.7.5 起,支持在线调整,底层通过 `chunk`(块)概念实现增量申请和内存拷贝:
-- 查看单次扩容的块大小 (默认 128MB)
SHOW VARIABLES LIKE 'innodb_buffer_pool_chunk_size';

-- 动态扩展示例:在原大小基础上增加一个 chunk (128MB)
SET GLOBAL innodb_buffer_pool_resize_status;
执行扩容后,可以通过监控状态观察进度:
4. 性能监控与指标解读
在生产环境中,判断 Buffer Pool 是否配置合理,最直接的手段是通过 SHOW ENGINE INNODB STATUS; 进行观察。重点关注以下参数:
- **Pages read / created / written**:记录了过去一段时间内的页面读取量、创建量(首次加载)与写入量(落盘)。如果 `created` 比例过高,可能意味着热数据未被完全覆盖在池中。
- **Buffer pool hit rate**:缓存命中率。计算公式近似为 `
1 - (Pages read) / (总读取请求次数)`。现代硬件下,该比率应维持在99%左右或以上。 - **Modified db pages**:当前处于脏状态的页面总数。如果该数字过大,说明写负载过重且刷盘速度滞后。
总结
InnoDB Buffer Pool 是支撑 MySQL 高性能的核心基石。通过对内存空间的精细化分段(Old/Young),以及对不同操作类型页面的分类管理(Free/LRU/Flush),它能够在有限的内存中最大限度发挥缓存价值。在实际运维中,结合服务器的物理内存配置合适的 `size`,并根据并发情况拆分 `instances`,是提升系统吞吐量的关键手段。
以上就是 MySQL InnoDB Buffer Pool 运行机制与调优方法的详细内容,更多关于 MySQL 高级特性的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









