

SQL Server 2012+ Offset/Fetch与Row_Number()分页性能对比

在SQL Server 2012及更高版本中,新增的 `OFFSET...FETCH` 子句为分页查询提供了更简洁的语法支持。本文将通过与经典的 `ROW_NUMBER()` 以及 `NTILE()` 方法进行执行计划与性能对比,解析不同分页方案的优劣,帮助开发者根据实际场景选择最佳实践。
测试准备与环境说明
为了获得准确的性能评估,本次测试基于一个包含 129,991 条记录 的文章详情表(Article_Detail)。测试环境开启了 `STATISTICS IO`, `TIME`, 和 `PROFILE` 以监控底层资源消耗。测试表结构均匀分布:
图1:测试表 Article_Detail 的结构示意
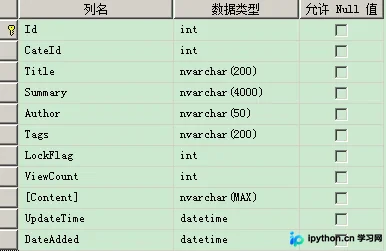
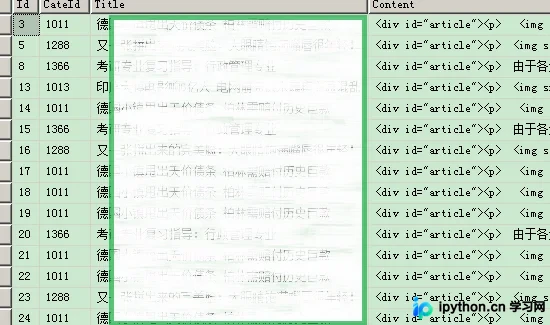
图2:示例数据内容展示
常见的 SQL Server 分页方法详解
第1步:使用 NTILE() 进行简单分组
`NTILE(integer_expression)` 可以将有序分区中的行分发到指定数量的组中,并返回组编号。虽然它理论上可用于分页(筛选特定组),但其应用场景较为狭窄,且计算逻辑通常涉及较复杂的内部排序和哈希操作。
其核心语法如下:
NTILE (integer_expression) OVER ( [ <partition_by_clause> ] < order_by_clause > )在实际代码中,若需每页显示15条数据,共8666组,伪代码如下:
-- 伪代码演示,实际性能较差,仅作了解
with #pager as
(
    select ID,Title,NTILE(8666) OVER(Order By ID) as pageid from Article_Detail
)
select ID,Title from #pager where pageid=50
第2步:使用 ROW_NUMBER() 经典分页
自 SQL Server 2005 引入窗口函数以来,`ROW_NUMBER()` 一直是标准分页方案。相比旧版游标分页,它避免了全表遍历,但存在局限性:必须从第一行开始编号。这意味着请求第50页时,系统仍需生成前49页的所有行数,导致页码越深,性能下降越明显。
核心语法:
ROW_NUMBER ( ) OVER ( [ PARTITION BY value_expression , ... [ n ] ] order_by_clause )典型分页写法(如提取第50页,每页15条):
with #pager as
(
    select ID,Title,ROW_NUMBER() OVER(Order By ID) as rowid from Article_Detail
)
select ID,Title from #pager where rowid between (15 * (50-1)+1) and 15 * 50
第3步:使用 OFFSET...FETCH 新型分页
SQL Server 2012 引入了全新的分页语法。它允许开发者直接指定“跳过的行数”(`OFFSET`)和“获取的行数”(`FETCH`),语法极其直观,且不需要子查询嵌套。
核心语法规范:
OFFSET:跳过指定的行数(必须是常量或表达式)。FETCH { FIRST | NEXT }:获取接下来的多少行,后接ROWS ONLY。
该语法不仅参数灵活(可接受表达式),而且 `Row/Rows` 区分大小写不敏感。实现同样的第50页查询:
dbcc freeproccache --清除缓存
set statistics time on
set statistics io on
-- 一行搞定!
select ID,Title from Article_Detail
order by id
OFFSET (15 * (50-1)) ROWS
FETCH NEXT 15 ROWS ONLY;
执行计划与性能深度对比
第4步:分析 NTILE() 的资源消耗
由于 `NTILE` 需要计算所有数据的分组情况,在执行计划中可以看到显著的性能瓶颈:
图3:NTILE() 的执行计划分析
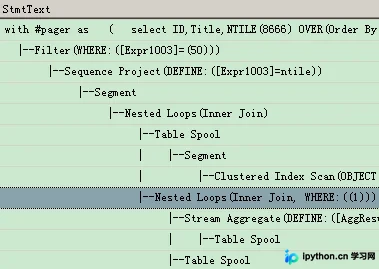
观察图3可见,该方案产生了大量的 Nested Loops(嵌套循环),并伴随其他无意义的运算节点。即使表中有索引,其逻辑依然偏向于宽泛的扫描或大量中间结果的计算,因此在生产环境中极少作为首选。
第5步:分析 ROW_NUMBER() 的资源消耗
图4:ROW_NUMBER() 的执行计划分析
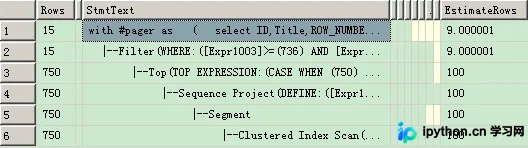
在图4中,聚集索引扫描(Clustered Index Scan)占据了约 100% 的成本。尽管统计信息显示估算行数(EstimateRows)和实际行数(Rows)相对较少,表明没有发生完全的全表物理扫描,但它依然需要对目标范围之前的数据进行排序和编号处理,IO 开销处于中等水平。
第6步:分析 OFFSET...FETCH 的资源消耗
图5:OFFSET FETCH 的执行计划分析
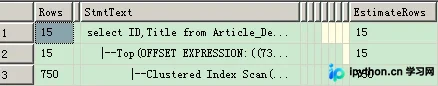
对比图5与图4可以发现,两者的执行计划在读取阶段高度相似(同样依赖于索引扫描),主要区别在于内部的算子。
共同点: 两者都未对数据进行全表扫描,IO 消耗基本持平。
差异点: `OFFSET FETCH` 的内部节点更少,减少了额外的 CPU 排序开销和逻辑分支判断。
结论与选型建议
综合上述分析与测试结果,得出以下结论:
- 性能层面: 在百万级以下的常规表中,`OFFSET FETCH` 与 `ROW_NUMBER()` 的 IO 效率几乎相同。但在高并发场景下,`OFFSET FETCH` 因省去了复杂的排序树重建和行号计算步骤,能略微节省 CPU 资源。
- 开发体验: `OFFSET FETCH` 完胜。其单句即可完成定位,无需编写 CTE(公共表表达式)或使用临时变量,极大降低了 SQL 复杂度与维护成本。
- 适用边界: 仅在极少数只需按固定块分组而不关心具体偏移量(只读静态报表)的特殊需求下,可考虑 `NTILE`;其余动态业务页面均推荐使用
OFFSET FETCH。
以上就是 SQL Server 2012+ 中 Offset Fetch 与 Row_Number 分页性能对比优化的详细内容,更多关于数据库 T-SQL 技巧与最佳实践的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









