

C语言判断大小端模式的两种常用方法

了解计算机内存中的字节序(Endianness)对于底层开发和跨平台移植至关重要。本文将详细说明如何利用C语言中的联合体(union)或指针操作,编写简洁有效的代码来判断当前系统是处于大端还是小端模式。
什么是大端与小端模式
在计算机系统中,数据存储以字节为单位。当处理位数大于8位的数据类型(如 short 为16位,int 或 long 为32位)时,多个字节在内存中的排列顺序决定了“端”的概念:
- 大端模式(Big-Endian):数据的低位(Least Significant Byte, LSB)保存在内存的高地址中,而数据的高位(Most Significant Byte, MSB)保存在内存的低地址中。这种模式符合人类的阅读习惯(从左到右,从高位到低位)。
- 小端模式(Little-Endian):与大小端相反,数据的低位保存在内存的低地址中,高位保存在高地址中。这种方式便于CPU直接处理数据,无需调整字节内容。
常见的X86架构处理器通常采用小端模式,而许多ARM、DSP及KEIL C51编译器环境则可能配置为大端模式或小端模式(取决于具体配置),理解这一差异有助于排查网络协议解析和二进制文件读写时的乱码或错误问题。
准备条件
要准确判断大小端模式,我们需要创建一个多字节变量,并观察其最低地址处存放的是哪个字节。以下示例使用 short int(通常为16位)作为测试数据。假设我们要检测的数值为十六进制 0x1234:
0x12是高字节(MSB)。0x34是低字节(LSB)。
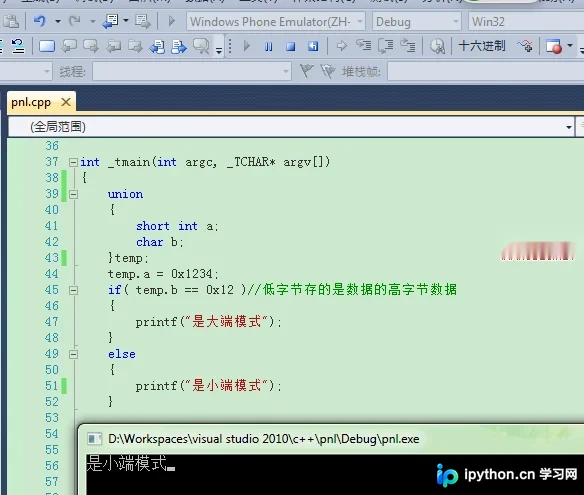
第1步:使用联合体(Union)判断
目的:利用 union 所有成员共享同一块内存空间的特性,通过不同数据类型的视角访问同一个内存地址。
操作:
- 定义一个联合体,包含一个
short int成员和一个char成员(char通常为1字节)。 - 将16进制值
0x1234赋值给short成员。 - 读取
char成员的值。因为char占据内存的第一个字节(低地址),它的值即为该内存起始处的字节内容。
void IsBigEndian_Union() {
    union {
        short int a;
        char b;
    } temp;

    // 赋值 0x1234,a占2个字节,b占1个字节且指向同一起始地址
    temp.a = 0x1234;

    if (temp.b == 0x12) {
        // 低地址存的是高字节数据
        printf("是大端模式\n");
    } else {
        // 低地址存的是低字节数据
        printf("是小端模式\n");
    }
}原理分析:如果 temp.b 等于 0x12,说明高字节存放在低地址,为大端模式;如果 temp.b 等于 0x34,说明低字节存放在低地址,为小端模式。
第2步:使用指针强制类型转换判断
目的:直接通过指针操作获取变量起始地址的字节内容,不依赖联合体的语义兼容性。
操作:
- 定义一个
short int变量并赋值为0x1122(或任意非零多字节值)。 - 将该变量的地址强制转换为
char*指针。 - 解引用该指针,读取第一个字节的值。
void IsBigEndian_Pointer() {
    short int a = 0x1122; // 十六进制,一个数值占4位(此处应理解为2字节short)

    // 将short地址强转为char指针,指向a的起始字节(低地址)
    char b = *(char *)&a;

    if (b == 0x11) { // 如果低地址存的是高字节0x11
        // 是大端模式
        printf("是大端模式\n");
    } else {
        // 是小端模式,低地址存的是低字节0x22
        printf("是小端模式\n");
    }
}注意:在实际验证中,大多数现代PC(x86/x64架构)运行此代码通常会输出“是小端模式”,这与Intel/AMD处理器的硬件架构设计一致。
完成判断
上述两种方法均能在运行时动态确定当前平台的字节序。开发网络通信程序或读写二进制文件时,建议引入此类检测逻辑,以便根据结果进行必要的字节翻转(Byte Swap),确保数据在不同架构机器间传输的一致性。
以上就是用C语言程序判断大小端模式的详细内容,更多关于C语言内存布局的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









