

Golang实现日志监听并发送到Kafka实战

在构建数据采集链路时,常需将分散的本地日志文件实时汇聚至Kafka。本文将展示如何使用Golang的hpcloud/tail库监控文件追加操作,并通过shopify/sarama客户端将数据推送至Kafka。文章涵盖了从环境准备、项目结构到核心代码实现(包含配置解析、Kafka生产者初始化及文件监听逻辑)的完整流程。
前置环境与工具准备
在编写代码前,需要确保运行环境中已安装以下组件和依赖库:
- Kafka与Zookeeper集群:必须正常运行,用于接收并存储日志消息。
- 可视化工具 Offset Explorer:建议安装或配置,用于直观验证消息是否成功投递及查看分区偏移量。
- Golang第三方库:
github.com/go-ini/ini:用于读取INI格式的配置文件,集中管理参数。github.com/hpcloud/tail:负责读取文件的尾部数据,支持类似Linuxtail -f的实时监控功能。github.com/Shopify/sarama:成熟的Kafka客户端库,用于连接集群、构造消息并执行发送操作。
系统设计与工作流程
整个日志收集系统的核心架构分为三个层次,利用Golang的并发特性实现低延迟传输:
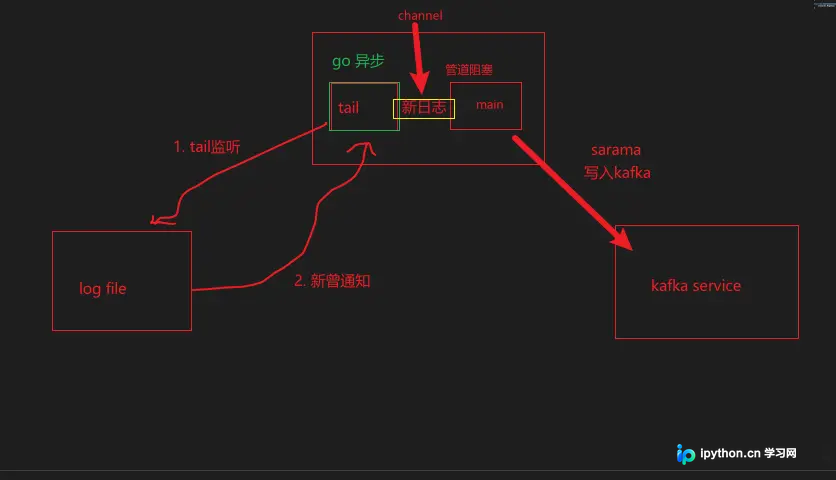
- 配置加载层:程序启动时首先解析配置文件,获取Kafka地址、Topic名称以及被监控日志文件的路径信息。
- 文件监听层(Tail服务):起一个独立的协程持续读取指定日志文件。当检测到文件末尾有新行追加时,将该行文本提取并通过管道发送给主流程。
- 消息生产层(Kafka服务):阻塞等待从管道接收到的新日志数据,组装成Kafka的消息格式后,异步发送至Kafka集群。
代码结构分层
为了保持代码清晰,推荐将模块进行分离:conf目录存放配置文件,serve包封装具体的业务逻辑类,main.go作为入口。
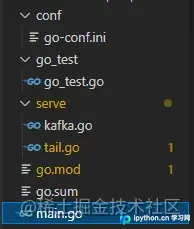
关键代码实现步骤
第1步:配置解析与主入口初始化
目的:建立全局配置对象,实例化Kafka发送者和日志监听器,并定义它们之间的通信渠道。
说明:main.go负责串联各个模块。它定义了结构体映射ini文件中的键值对。初始化Kafka服务后,调用其InitKafka方法会立即开启一个后台协程专门负责向Kafka发送数据。同时,初始化日志服务并开始监听。
package main

import (
	"fmt"
	"sarama/serve"

	"github.com/go-ini/ini"
)

type KafkaConfig struct {
	Address     string `ini:"address"`
	ChannelSize int    `ini:"chan_size"`
}
type TailConfig struct {
	Path     string `ini:"path"`
	Filename string `ini:"fileName"`
	// 如果是结构体,则指明分区名
	Children `ini:"tailfile.children"`
}
type Config struct {
	KafkaConfig `ini:"kafka"`
	TailConfig  `ini:"tailfile"`
}
type Children struct {
	Name string `ini:"name"`
}

func main() {
	// 加载配置
	var cfg = new(Config)
	err := ini.MapTo(cfg, "./conf/go-conf.ini")
	if err != nil {
		fmt.Print(err)
	}
	// 初始化kafka
	ks := &serve.KafukaServe{}
	// 启动kafka消息监听。异步
	ks.InitKafka([]string{cfg.KafkaConfig.Address}, int64(cfg.KafkaConfig.ChannelSize))
	// 关闭主协程时,关闭channel
	defer ks.Destruct()

	// 初始化tail
	ts := &serve.TailServe{}
	ts.TailInit(cfg.TailConfig.Path + "/" + cfg.TailConfig.Filename)
	// 阻塞
	ts.Listener(ks.MsgChan)

}
第2步:Kafka生产者与服务端处理
目的:建立与Kafka的连接,配置分区策略,并在后台协程中循环消费管道数据,执行发送。
说明:kafka.go中的Listener是核心处理函数。由于网络I/O可能存在耗时,将其放在单独的Goroutine中。这里设置了RequiredAcks: WaitForAll以确保数据可靠性(注意在高吞吐场景下可适当调整),并采用随机分区器。Destruct用于清理资源,防止内存泄漏。
package serve

import (
	"fmt"

	"github.com/Shopify/sarama"
)

type KafukaServe struct {
	MsgChan chan string
	//err         error
}

func (ks *KafukaServe) InitKafka(addr []string, chanSize int64) {

	// 读取配置
	config := sarama.NewConfig()
	// 1. 初始化生产者配置
	config.Producer.RequiredAcks = sarama.WaitForAll
	// 选择分区
	config.Producer.Partitioner = sarama.NewRandomPartitioner
	// 成功交付的信息
	config.Producer.Return.Successes = true

	ks.MsgChan = make(chan string, chanSize)

	go ks.Listener(addr, chanSize, config)

}

func (ks *KafukaServe) Listener(addr []string, chanSize int64, config *sarama.Config) {
	//  连接kafka
	var kafkaClient, _ = sarama.NewSyncProducer(addr, config)
	defer kafkaClient.Close()
	for {
		select {
		case content := <-ks.MsgChan:
			//
			msg := &sarama.ProducerMessage{
				Topic: "weblog",
				Value: sarama.StringEncoder(content),
			}
			partition, offset, err := kafkaClient.SendMessage(msg)
			if err != nil {
				fmt.Println(err)
			}
			fmt.Println("分区,偏移量:")
			fmt.Println(partition, offset)
			fmt.Println("___")
		}

	}
}

func (ks *KafukaServe) Destruct() {
	close(ks.MsgChan)
}
第3步:日志文件监听与管道通讯
目的:打开目标日志文件,进入死循环检测文件变化。一旦发现新数据,即刻推送到传入的通道。
说明:tail.go初始化时配置了ReOpen和Follow为true,这使得即便日志文件被轮转(rotate),程序也能自动跟随新文件继续监听。Location设为Offset 0且Whence为2表示从头开始读取或根据实际偏移量读取。一旦管道接收到数据,主程序会继续阻塞等待后续消息。
package serve

import (
	"fmt"

	"github.com/hpcloud/tail"
)

type TailServe struct {
	tails *tail.Tail
}

func (ts *TailServe) TailInit(filenName string) {
	config := tail.Config{
		ReOpen:    true,
		Follow:    true,
		Location:  &tail.SeekInfo{Offset: 0, Whence: 2},
		MustExist: false,
		Poll:      true,
	}
	// 打开文件开始读取数据

	ts.tails, _ = tail.TailFile(filenName, config)

	// if err != nil {
	// 	fmt.Println("tails %s failed,err:%v\n", filenName, err)
	// 	return nil, err
	// }
	fmt.Println("启动," + filenName + "监听")
}

func (ts *TailServe) Listener(MsgChan chan string) {
	for {
		msg, ok := <-ts.tails.Lines
		if !ok {
			// todo
			fmt.Println("数据接收失败")
			return
		}
		fmt.Println(msg.Text)
		MsgChan <- msg.Text
	}
}

// 测试案例
func Demo() {
	filename := "E:\\xx.log"
	config := tail.Config{
		ReOpen:    true,
		Follow:    true,
		Location:  &tail.SeekInfo{Offset: 0, Whence: 2},
		MustExist: false,
		Poll:      true,
	}
	// 打开文件开始读取数据
	tails, err := tail.TailFile(filename, config)
	if err != nil {
		fmt.Println("tails %s failed,err:%v\n", filename, err)
		return
	}
	var (
		msg *tail.Line
		ok  bool
	)
	fmt.Println("启动")
	for {
		msg, ok = <-tails.Lines
		if !ok {
			fmt.Println("tails file close reopen,filename:$s\n", tails.Filename)
		}
		fmt.Println("msg:", msg.Text)
	}
}
排错与注意事项
- Kafka连接失败:检查防火墙是否开放了Kafka Broker端口,且在代码中使用Offset Explorer验证连接状态。
- 大文件启动卡顿:如果正在监听的日志文件极大(如几GB以上),初次读取可能消耗较长时间。在实际生产中,通常需要从指定的偏移量(Offset)开始读取,而非每次都从头扫描。
- 错误处理**:示例代码中忽略了部分Error返回以精简展示,但在真实生产环境务必完善错误重试机制和优雅退出逻辑。
总结
本教程详细介绍了基于Golang、hpcloud/tail库和Sarama客户端构建高可用日志采集工具的完整过程。通过合理的代码分层设计,实现了文件IO与网络IO的逻辑解耦。掌握这些基础组件后,开发者可以进一步扩展,添加多文件并行监听、复杂日志清洗规则等功能。以上就是Golang监听日志文件并发送到Kafka的详细内容,更多关于Go语言部署运维的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









