

MySQL索引三大核心作用:减少扫描、排序与分组优化详解

在MySQL数据库优化中,索引不仅仅是加速查找的工具,更是提升查询效率的核心。本文将从减少扫描记录数量、辅助排序以及优化分组操作三个维度,详细解析MySQL索引的工作原理。结合InnoDB存储引擎的B+树特性,探讨如何利用聚簇索引与二级索引避免全表扫描、省去文件排序步骤以及无需建立临时表即可执行分组统计,帮助开发者深入理解索引底层逻辑。
1. 索引用于减少需要扫描的记录数量
在没有任何索引的情况下,最简单的查询方案是全表扫描。对于InnoDB存储引擎而言,这意味着从聚簇索引的第一个叶子节点开始,沿着单向链表一直向后扫描,直到最后一个叶子节点。这种暴力方式在处理大数据量时效率极低。
索引的主要价值在于利用B+树的二叉搜索特性,将全表扫描转化为针对特定区间或等值条件的快速定位。
第1步:构建测试环境
为了演示索引的作用,首先建立一张包含多种索引类型的表:
create table single_table(
	id int not auto_increment,
	key1 varchar(100),
	key2 int,
	key3 varchar(100),
	key_part1 varchar(100),
	key_part2 varchar(100),
	key_part3 varchar(100),
    common_field varchar(100),
	primary key(id),          # 聚簇索引
	key idx_key1(key1),       # 二级索引
	unique key uk_key2(key2), # 唯一二级索引
	key idx_key3(key3),       # 二级索引
	key idx_key_part(key_part1,key_part2,key_part3) # 联合索引
)Engine=InnoDB CHARSET=utf8;
第2步:利用索引缩小扫描范围
当执行以下查询时:
select * from single_table where id>=2 and id<=100;系统无需扫描所有记录。它可以通过聚簇索引对应的B+树,快速定位到id=2的节点,然后仅沿着叶子节点的单向链表扫描,直到id值超过100为止。这种方式极大地减少了IO操作次数。
适用范围:只要索引列与常数使用=、<>、in、not in、is null、is not null、>、<、>=、<=、between或者like操作符连接,均可通过B+树产生扫描区间,从而提升效率。
2. 索引用于排序 (Order By)
通常,order by子句需要将结果集加载到内存中进行排序,若数据量过大超出内存限制,则需借助磁盘进行文件排序(Filesort),这对性能影响巨大。如果order by的列符合索引的有序性,MySQL可以直接利用索引的有序性返回已排序的结果,从而避免额外的排序开销。
第1步:联合索引的自然排序特性
假设我们建立一个联合索引 idx_key_part(key_part1, key_part2, key_part3)。根据B+树的构造规则,该索引中的记录是先按 key_part1 排序,若相同再按 key_part2 排序,依此类推。
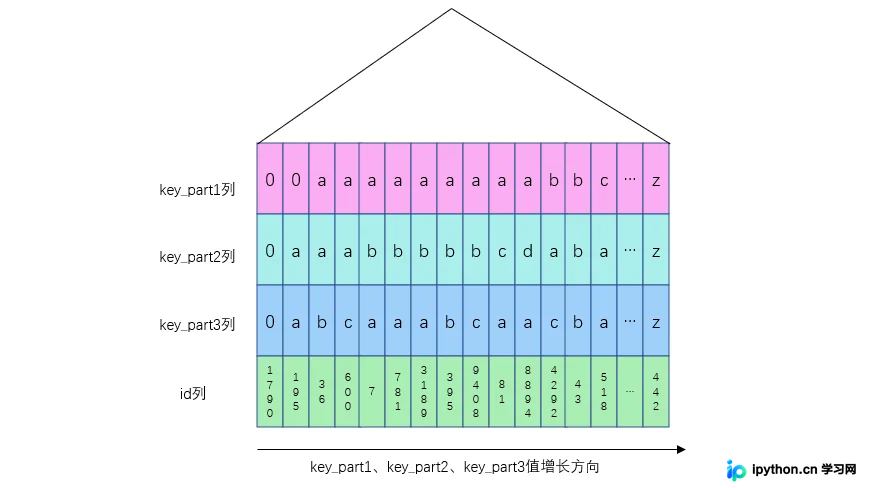
当我们执行如下查询时:
select * from single_table order by key_part1, key_part2, key_part3 limit 10;MySQL只需从联合索引的第一条记录开始,沿链表向后扫描10条记录即可直接返回结果。尽管因为查询列表是 * 需要进行“回表”操作获取完整行数据,但省去了对数万条数据进行内存或磁盘排序的过程,性能显著提升。
注意:加上 limit 可以限制回表次数。如果不加 limit,虽然避免了排序,但大量的回表操作仍可能带来性能损耗。
第2步:联合索引排序的注意事项
要使索引发挥排序作用,必须严格遵守最左前缀原则在排序中的应用:order by后面的列顺序必须与联合索引的定义顺序完全一致。
- 正常情况:
order by key_part1, key_part2, key_part3,可以直接使用索引顺序输出。 - 错误情况:
order by key_part3, key_part2, key_part1。这要求先按第三列排序,这与B+树内部先按第一列排序的物理结构冲突,因此无法利用索引进行排序,通常会退化为文件排序。
第3步:不可使用索引排序的典型场景
即使使用了索引列,以下情况也会导致索引失效,无法用于排序:
- ASC/DESC混用: 联合索引的每个层级只有单一的排序方向。例如
order by key_part1 asc, key_part2 desc无法直接使用单一方向的B+树链表。 - 排序列分散在不同索引: 如
order by key1, key2。idx_key1只保证key1有序,在key1相同时并不对key2排序,因此无法直接用该索引解决多列排序。 - 排序列在联合索引中不连续: 如联合索引为
(a, b, c),但排序列为a, c。缺失中间列b导致c的相对顺序未被定义,无法直接利用索引排序。 - 表达式而非列名: 排序列不是简单的列名(如涉及函数计算或表达式),索引记录的预排序状态无法直接匹配。
3. 索引用于分组 (Group By)
在进行数据统计时,group by 往往需要建立一个临时表来存储中间分组结果。如果数据量大,这会消耗大量CPU和内存资源。然而,如果分组列的顺序与索引顺序一致,MySQL可以直接遍历索引完成分组,无需创建临时表。
第1步:索引辅助分组原理
考虑以下查询:
select key_part1, key_part2, key_part3, count(*)
from single_table
group by key_part1, key_part2, key_part3;
这个过程等同于:
1. 先按 key_part1 分组;
2. 在 key_part1 相同的组内,再按 key_part2 细分;
3. 最后按 key_part3 进一步细分。
由于联合索引 idx_key_part 的物理存储顺序恰好符合上述分组逻辑,MySQL可以直接扫描索引树,相邻且键值相同的记录自然构成一个分组单元。这使得系统跳过了建立临时表和扫描聚簇索引数据的步骤,效率极高。
第2步:分组顺序的要求
与排序类似,分组列的顺序也必须符合索引定义的顺序,或者至少是索引左边连续的列。例如,如果索引是 (a, b, c),可以使用 group by a 或 group by a, b 或 group by a, b, c,但如果试图按 group by b, c 执行,则无法直接利用该索引的有序性。
总结
MySQL索引不仅用于WHERE条件的过滤,其内在的B+树有序性还是实现高效排序和分组的关键。理解索引如何减少扫描行数、如何通过最左前缀原则支持ORDER BY以及如何在GROUP BY中避免临时表,是掌握SQL性能优化的基础。在实际开发中,合理设计联合索引的结构,使其兼顾查询过滤与排序分组需求,能显著提升数据库吞吐量。
以上就是MySQL索引作用的详细内容,更多关于数据库优化与MySQL技术的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









