


在 Python 里给 HTTP 响应做解压很常见,但“上传时压缩请求体”常常被误以为是客户端库自带开关。实际上,大多数库都只是提供“自定义请求体”和“自定义请求头”的能力,真正的 gzip 上行压缩要靠你自己先处理好二进制 body。
这篇文章把这件事拆开讲清楚:先统一压缩函数,再分别看 urllib、httpx、aiohttp、pycurl 和 Tornado 客户端怎么发。看完你可以直接判断:自己的项目该选哪种写法、哪些参数最容易传错、服务端还需要补什么处理。
上行 gzip 压缩的核心原理
先明确一点:上行请求体压缩不是 HTTP 库自动替你完成的功能。通用做法只有两步:
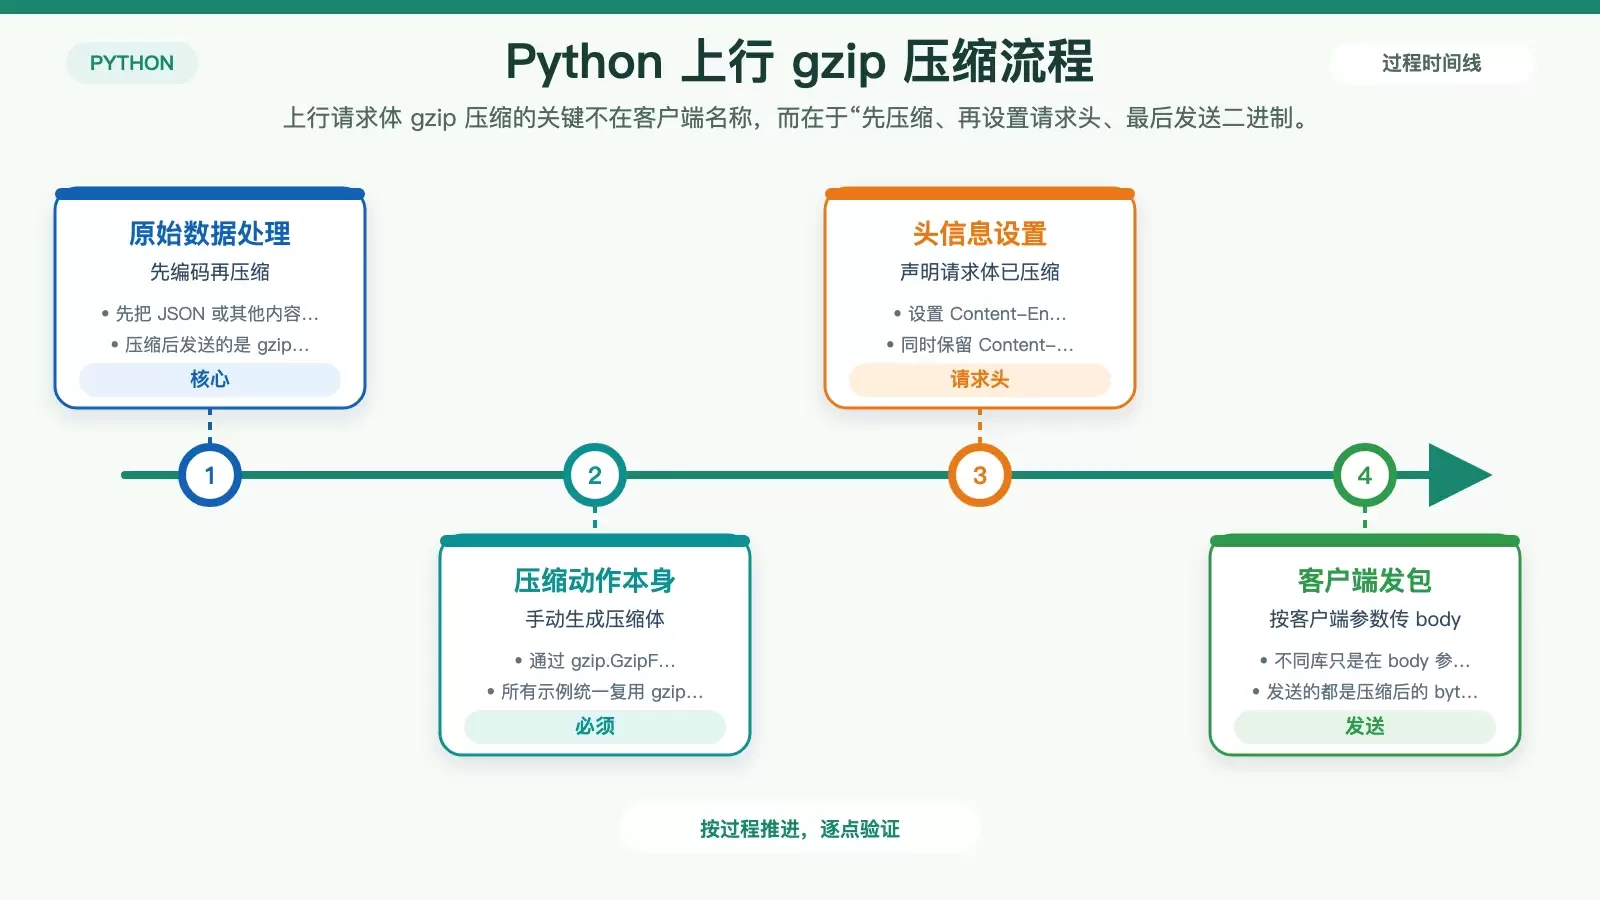
- 先把原始请求体压缩成 gzip 二进制;
- 发送时加上
Content-Encoding: gzip,并把压缩后的字节作为请求 body 传出去。
只要某个客户端支持“自定义 body + 自定义请求头”,理论上就能实现。区别主要在于各个库传 body 的参数名不同:
requests:data=httpx:content=aiohttp:data=urllib:data=pycurl:POSTFIELDS
所有示例共用的压缩函数
为了避免每个示例重复处理 gzip,这里先统一一个工具函数:
import gzip
from io import BytesIO

def gzip_compress(raw_bytes: bytes) -> bytes:
    buf = BytesIO()
    with gzip.GzipFile(fileobj=buf, mode="wb") as f:
        f.write(raw_bytes)
    return buf.getvalue()
后续无论你使用哪一个客户端,思路都一样:先把 JSON 或其他内容编码成 bytes,再调用这个函数得到压缩后的 body。
同步场景怎么发 gzip 请求体
如果你的代码本身是同步执行,重点通常在于依赖约束、API 易用性和项目是否需要长期维护。
标准库 urllib:不装第三方包也能用
如果部署环境受限,不能额外安装依赖,urllib 是最直接的选择。它是 Python 标准库自带组件,不需要单独安装。
import json
from urllib import request

url = "http://127.0.0.1:8000/api/upload"
payload = {"data": list(range(2000))}
raw = json.dumps(payload).encode("utf-8")
compressed_body = gzip_compress(raw)

headers = {
    "Content-Type": "application/json; charset=utf-8",
    "Content-Encoding": "gzip"
}

req = request.Request(url, data=compressed_body, headers=headers, method="POST")
with request.urlopen(req) as resp:
    print(resp.read().decode("utf-8"))
它的优点是零依赖,缺点也很明显:API 比较简陋,没有连接池,超时和工程化能力也不算友好。适合受限环境或简单任务,通常不是生产环境首选。
httpx:同步项目里的主流推荐
httpx 的接口风格和 requests 接近,但同时支持 HTTP/1.1 和 HTTP/2,也能自然过渡到异步版本。对于新项目来说,它通常是更均衡的选择。
import httpx
import json

url = "http://127.0.0.1:8000/api/upload"
payload = {"data": list(range(2000))}
raw = json.dumps(payload).encode("utf-8")
compressed_body = gzip_compress(raw)

headers = {
    "Content-Type": "application/json; charset=utf-8",
    "Content-Encoding": "gzip"
}

# 同步
with httpx.Client(timeout=10) as client:
    res = client.post(url, headers=headers, content=compressed_body)
    print(res.text)

# 异步版本
"""
import asyncio
async def run():
    async with httpx.AsyncClient(timeout=10) as client:
        res = await client.post(url, headers=headers, content=compressed_body)
        print(res.text)
asyncio.run(run())
"""
这里最容易出错的一点是:httpx 传二进制请求体用的是 content,不是 data。很多人因为习惯了其他库的参数命名,会在这里踩坑。
异步场景的常见实现
异步客户端的差别,更多体现在生态兼容性和项目背景,而不是 gzip 请求体本身的实现难度。
aiohttp:高并发异步请求的常见选择
在异步生态里,aiohttp 依然是大量爬虫、异步服务和批量网络任务会用到的客户端。
import aiohttp
import asyncio
import json

async def main():
    url = "http://127.0.0.1:8000/api/upload"
    payload = {"data": list(range(2000))}
    raw = json.dumps(payload).encode("utf-8")
    compressed_body = gzip_compress(raw)

    headers = {
        "Content-Type": "application/json; charset=utf-8",
        "Content-Encoding": "gzip"
    }
    async with aiohttp.ClientSession() as session:
        async with session.post(url, data=compressed_body, headers=headers) as resp:
            print(await resp.text())

asyncio.run(main())
它的写法和多数 Python HTTP 客户端类似:仍然是手动压缩,再用原始 body 参数传输。对纯异步高并发任务来说,这条路线很稳妥。
Tornado 内置客户端:框架内项目直接复用
如果项目本身就在用 Tornado Web 框架,通常没必要额外引入新的 HTTP 客户端,直接复用内置能力即可。
import json
from tornado.httpclient import AsyncHTTPClient, HTTPRequest
import tornado.ioloop

async def fetch():
    url = "http://127.0.0.1:8000/api/upload"
    payload = {"data": list(range(2000))}
    raw = json.dumps(payload).encode("utf-8")
    compressed_body = gzip_compress(raw)

    req = HTTPRequest(
        url,
        method="POST",
        body=compressed_body,
        headers={
            "Content-Type": "application/json; charset=utf-8",
            "Content-Encoding": "gzip"
        }
    )
    client = AsyncHTTPClient()
    res = await client.fetch(req)
    print(res.body.decode())

tornado.ioloop.IOLoop.current().run_sync(fetch)
这类场景的关键不是“能不能压缩”,而是尽量保持项目内技术栈一致,减少额外依赖和维护成本。
需要更底层控制时:pycurl 写法
pycurl 基于 C 库 libcurl,在吞吐和底层控制能力上很强,适合对性能要求较高、同时愿意接受更复杂 API 的场景。
import pycurl
import json
from io import BytesIO

url = "http://127.0.0.1:8000/api/upload"
payload = {"data": list(range(2000))}
raw = json.dumps(payload).encode("utf-8")
compressed_body = gzip_compress(raw)

resp_buffer = BytesIO()
c = pycurl.Curl()
c.setopt(c.URL, url)
c.setopt(c.POST, 1)
c.setopt(c.POSTFIELDS, compressed_body)
c.setopt(c.WRITEDATA, resp_buffer)

headers = [
    "Content-Type: application/json; charset=utf-8",
    "Content-Encoding: gzip"
]
c.setopt(c.HTTPHEADER, headers)
c.perform()
c.close()

print(resp_buffer.getvalue().decode())
它的代价同样明显:Windows 安装相对麻烦,接口风格也更偏底层。除非你已经熟悉 libcurl 体系,或者项目确实看重这一层性能,否则不一定是最省事的方案。
所有库都绕不开的几个坑
不要直接使用框架自带的 json 参数
像 httpx.post(json={})、requests.post(json={}) 这样的接口,会帮你自动完成 JSON 编码。这样一来,请求体就不再是你可控的原始二进制,也就没法替换成已经 gzip 压缩过的数据。
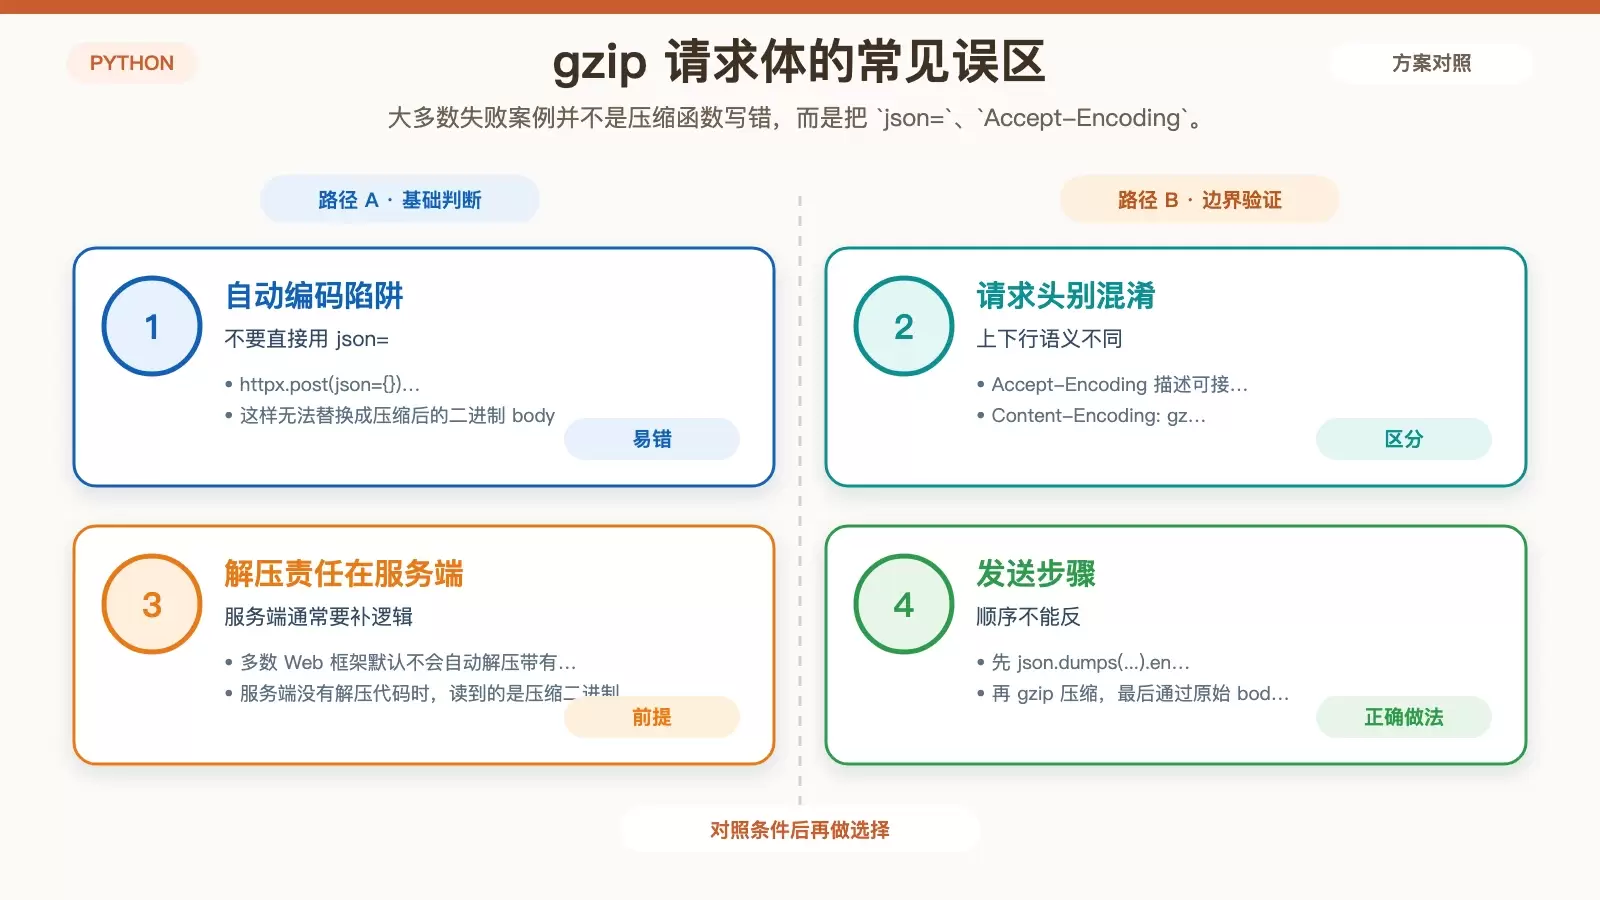
正确做法是:
- 先手动
json.dumps(...).encode("utf-8"); - 再做 gzip 压缩;
- 最后通过原始 body 参数发送。
不要把 Accept-Encoding 和 Content-Encoding 混为一谈
这两个头经常被混淆,但语义完全不同:
Accept-Encoding:表示客户端能接收什么压缩格式的响应;Content-Encoding: gzip:表示这一次发出去的请求体已经被 gzip 压缩。
也就是说,下行压缩和上行压缩是两回事。能自动解压响应,不等于会自动压缩请求体。
服务端通常还要自己解压
这一点很容易被忽略:绝大多数 Web 框架默认不会自动解压带有 Content-Encoding 的请求体。如果服务端没有显式解压逻辑,它读到的往往只是压缩后的二进制内容。
所以客户端改完之后,最好同步确认服务端是否已经支持:
- 识别
Content-Encoding: gzip; - 在业务解析前先做解压;
- 再把解压后的内容当作 JSON 或其他格式处理。
库选型怎么判断
如果只想快速落地,可以直接按项目条件判断:
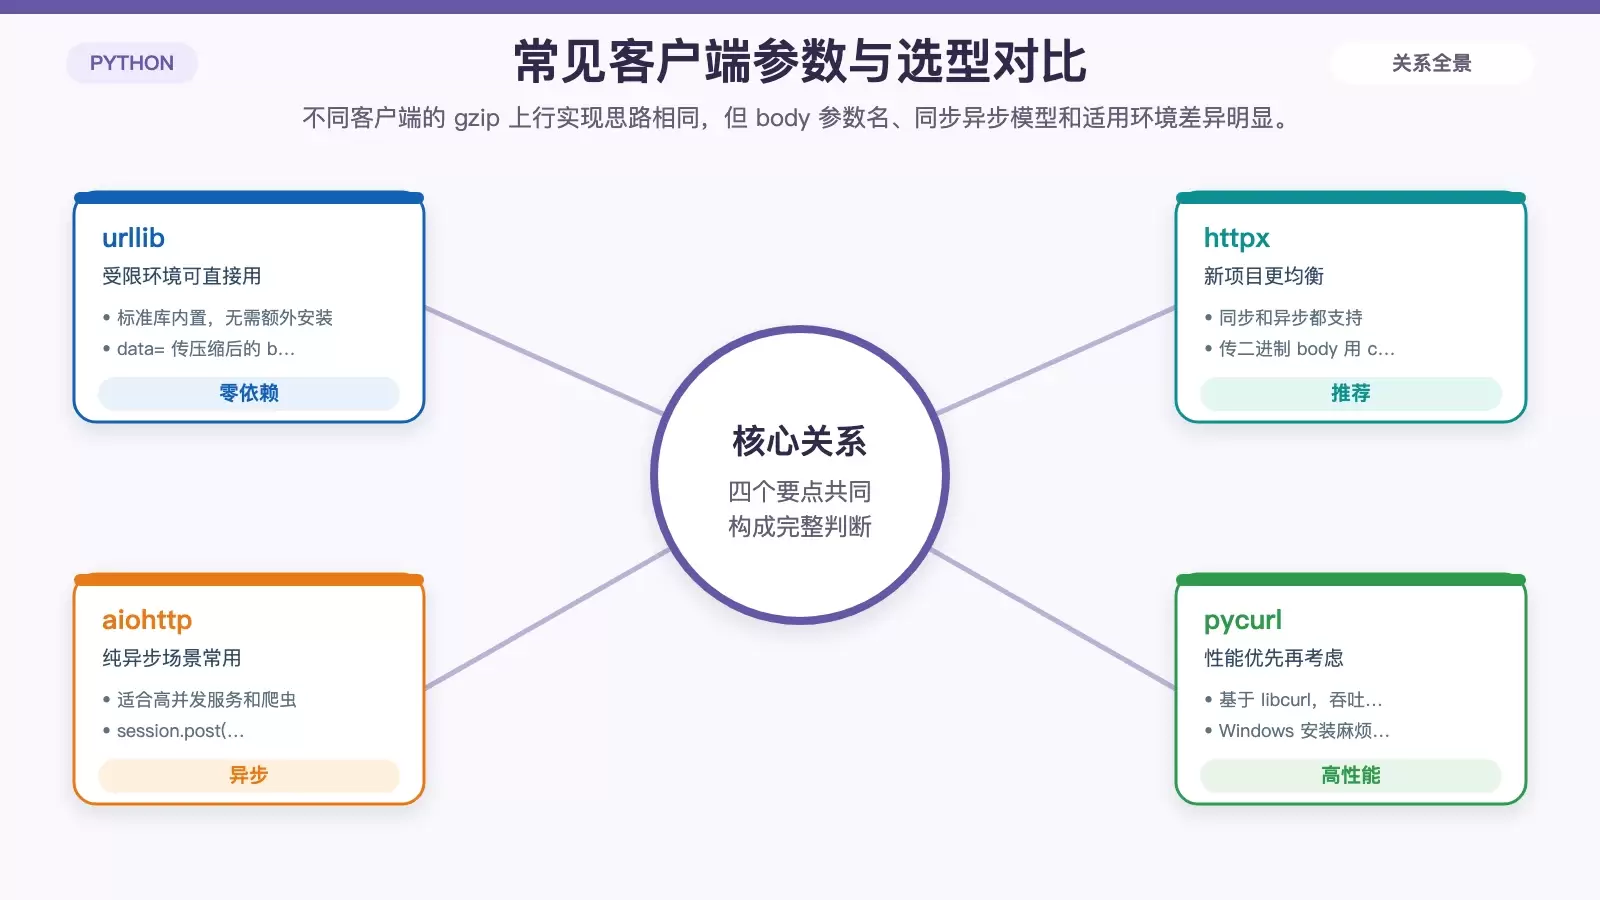
- 新项目,且同步和异步都可能用到:httpx
- 纯异步高并发服务或爬虫:aiohttp
- 不能安装第三方包、环境极简:urllib(标准库)
- 追求极致性能,且熟悉
libcurl:pycurl - 老项目以稳定为先:继续沿用现有客户端,例如
requests
从实现角度看,这几种方案没有本质差异,核心都还是“手动压缩 body + 正确设置 Content-Encoding”。真正影响维护体验的,是参数命名、同步异步模型、依赖限制和项目现有技术栈。









