


在 CentOS 上部署 Golang 服务,日志系统常常一边承担排障职责,一边悄悄吞掉 I/O 和 CPU 预算。真正有效的优化,不是只换一个“更快”的库,而是把日志链路拆开看:哪些日志必须写、何时写、写到哪里、写满后怎么处理。顺着这几个问题往下梳理,你可以更清楚地判断,当前瓶颈到底出在日志库、写入方式,还是磁盘与归档策略上。
先做选型:不同日志库的性能侧重点不一样
日志优化的第一步,是确认你用的库是否适合当前场景。常见的几种 Go 日志库,侧重点并不相同:
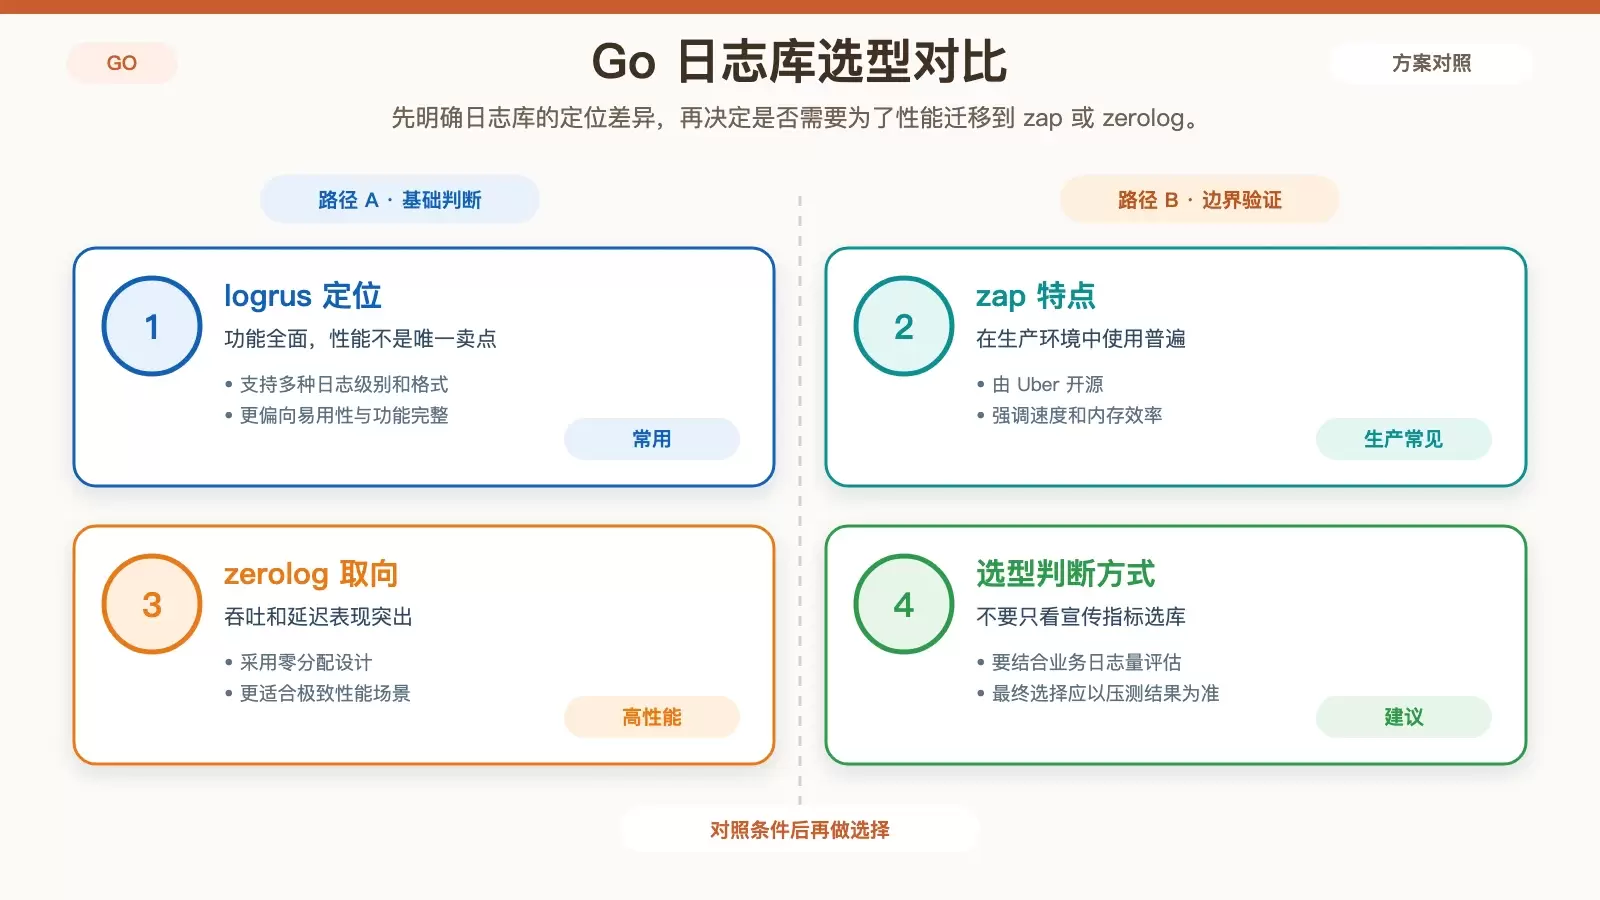
- logrus:结构化能力完整,支持多种日志级别和输出格式,适合更看重易用性和生态兼容的场景。
- zap:由 Uber 开源,强调速度和内存效率,在生产环境中的使用非常普遍。
- zerolog:以零分配为目标,性能表现突出,更适合对吞吐和延迟都很敏感的服务。
如果你的重点是压低日志开销,通常可以优先评估 zap 和 zerolog。不过最终是否合适,仍然要结合业务日志量、字段复杂度和实际压测结果来判断,而不是只看库本身的宣传指标。
按环境收紧日志级别,先减少无效写入
很多服务的日志性能问题,根源并不是“写得慢”,而是“写得太多”。在生产环境里,把大量 INFO 甚至调试信息持续落盘,通常会直接放大 I/O 压力。
比较稳妥的做法,是按环境区分日志级别:开发和测试环境保留更详细的信息,生产环境则尽量只保留 WARN 或 ERROR,把真正有诊断价值的内容留下来,减少无意义写入。
下面是一个使用 zap 的简单示例:
import ("go.uber.org/zap")
func main() {
logger, _ := zap.NewProduction()
defer logger.Sync()
logger.Info("This is an info message")
logger.Warn("This is a warning message")
logger.Error("This is an error message")
}
这段代码本身很简单,但实际优化价值在于:你需要确保生产配置不会默认放出过多低级别日志。日志级别每升高一档,通常都能直接减少写入次数和序列化成本。
异步日志怎么用,关键在队列和退出时机
当请求链路对响应时间比较敏感时,同步写日志很容易把 I/O 延迟传导到业务线程。异步日志的价值就在这里:业务先把日志写入队列,由后台协程负责落盘,前台流程不必等待日志写入完成。
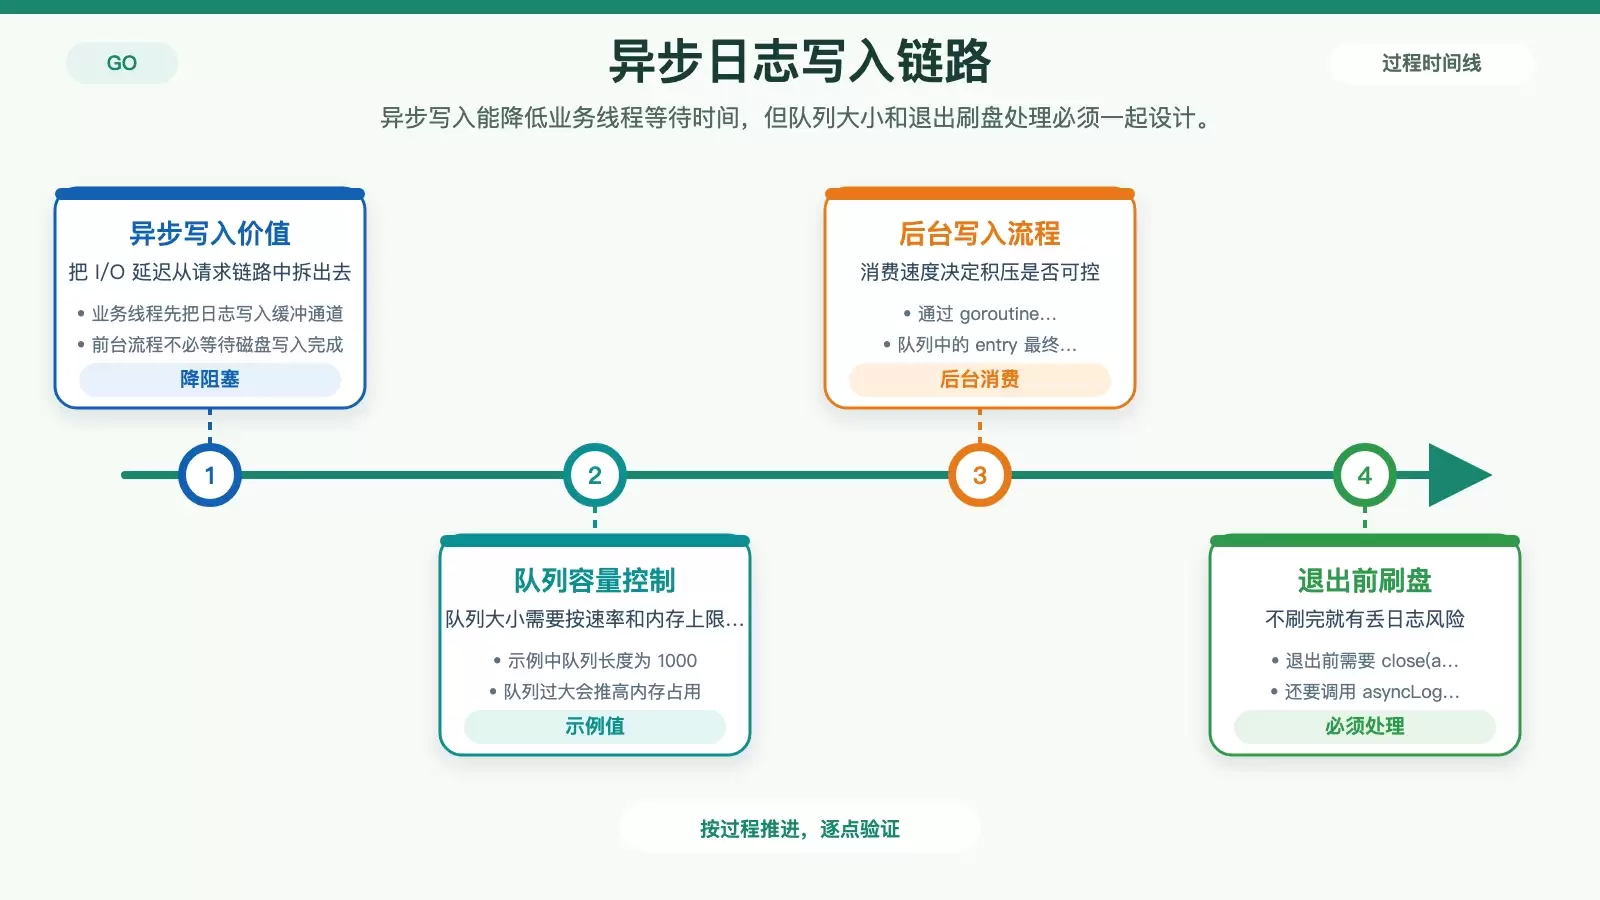
一个基于 zap 的异步日志封装示例如下:
import ("go.uber.org/zap""go.uber.org/zap/zapcore""sync")
type AsyncLogger struct {logger *zap.Loggerqueuechan zapcore.Entrywg sync.WaitGroup}
func NewAsyncLogger(logger *zap.Logger, queueSize int) *AsyncLogger {
al := &AsyncLogger{logger: logger,queue:make(chan zapcore.Entry, queueSize),}
al.wg.Add(1)
go al.processQueue()
return al
}
func (al *AsyncLogger) processQueue() {
defer al.wg.Done()
for entry := range al.queue {
al.logger.Write(entry)
}
}
func (al *AsyncLogger) Info(msg string, fields ...zap.Field) {
al.queue <- zapcore.Entry{Level: zap.InfoLevel, Message: msg, Context: fields}
}
func (al *AsyncLogger) Error(msg string, fields ...zap.Field) {
al.queue <- zapcore.Entry{Level: zap.ErrorLevel, Message: msg, Context: fields}
}
func main() {
logger, _ := zap.NewProduction()
asyncLogger := NewAsyncLogger(logger, 1000)
asyncLogger.Info("This is an info message")
asyncLogger.Error("This is an error message")
// 确保退出前所有日志都已刷入
close(asyncLogger.queue)
asyncLogger.wg.Wait()
}
这类方案落地时,要重点看两个地方:
队列大小不能只图保险
示例里的队列长度是 1000。这个值不是越大越好,队列越大,峰值时内存占用也越高;过小则可能在日志突增时阻塞业务。合理做法是结合日志产生速率、消费速度和可接受的内存上限来压测调整。
进程退出前必须刷完日志
异步写入最大的风险不是“慢”,而是“丢”。如果服务退出前没有正确关闭队列并等待后台协程完成,最后一批日志很可能还在缓冲区里。示例中通过 close(asyncLogger.queue) 和 asyncLogger.wg.Wait() 保证了这一点,这一步不能省。
日志文件别无限增长,交给 logrotate 处理
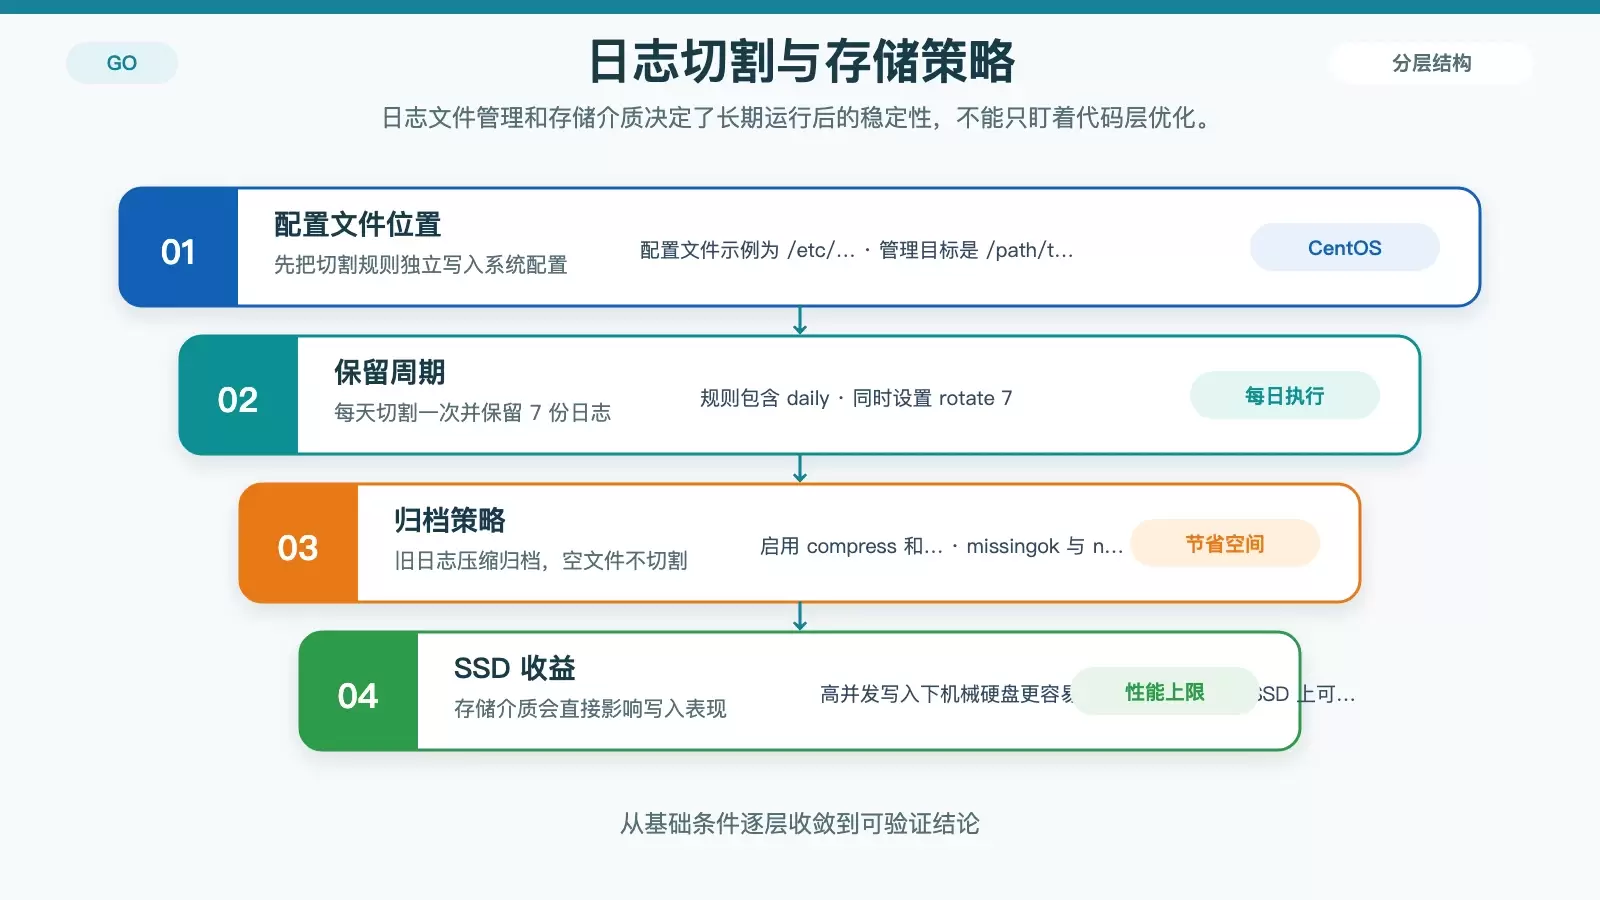
单个日志文件持续膨胀,会带来两个直接问题:一是后续读写和检索效率下降,二是磁盘空间管理失控。CentOS 上更成熟的做法,是用 logrotate 负责切割和归档。
配置步骤如下。
1. 创建 logrotate 配置文件
例如新建 /etc/logrotate.d/myapp,写入以下规则:
/path/to/your/app.log {
daily
rotate 7
compress
delaycompress
missingok
notifempty
create 640 root root
}
这组配置的含义很明确:每天切割一次,保留 7 份旧日志,旧文件压缩,日志缺失时不报错,空文件不切割,并在切割后重新创建权限为 640 的新日志文件。
2. 确保 logrotate 自动运行
启用并启动对应服务:
sudo systemctl enable logrotate
sudo systemctl start logrotate
这样可以避免当前活跃日志文件无限变大,也能把旧日志平稳转入归档,减少对在线写入性能的影响。
磁盘介质和缓冲参数,决定性能上限
当日志量已经不小、软件层面也做过收敛后,瓶颈就可能落到存储和缓冲配置上。
优先把日志放到 SSD
如果部署条件允许,日志目录放在 SSD 上通常会有比较直接的收益。相比机械硬盘,SSD 在高并发写入场景下的延迟和吞吐表现更稳定,不容易因为频繁写入把整条日志链路拖慢。
结合压测调整缓冲区与编码配置
除了磁盘本身,日志库的缓冲区大小也会影响性能表现。日志产生速率较高时,适当调整缓冲参数可以减少频繁刷写带来的开销。
以 zap 为例,可以从 EncoderConfig 入手,评估像 LevelKey 和 TimeKey 这类字段是否都必须保留。字段越多、格式越复杂,序列化成本通常越高。这里没有通用最优解,还是要以压测结果为准逐步微调。
一套更实用的优化顺序
如果你准备在 CentOS 上系统地优化 Go 日志性能,比较实用的顺序通常是:先收紧日志级别,再评估是否需要切换到 zap 或 zerolog,随后引入异步写入,最后补齐 logrotate、SSD 和缓冲参数调优。
这样做的好处是,每一步都能通过压测观察收益,也更容易定位真实瓶颈。对于大多数线上服务来说,日志性能优化不是一次性改造,而是一组能逐步叠加的工程实践。









