

NumPy 与 Python 列表标准差计算性能对比

本文深入解析 NumPy 数组与 Python 内置列表在计算标准差时的核心区别。通过对比底层数据结构、运算机制及实际计时结果,展示 NumPy 基于 C 语言实现的矢量化操作如何显著提升计算效率。文章包含具体代码示例与性能测试数据,帮助开发者理解为何在大规模数据处理中 NumPy 是更优选择。
1 什么是 Numpy
NumPy 全称为 Numerical Python,是高性能科学计算与数据分析领域的基础核心库。诸如 pandas 等数据处理工具以及 Scikit-learn 等机器学习框架,均底层依赖 NumPy 包进行数值运算。
NumPy 的核心数据结构是ndarray,即 N 维数值数组。从外观形式上看,它与 Python 原生的列表类型相似,但两者在底层实现上存在本质差异。
为了直观理解这种差异,我们可以观察一个简单的对比示例。
首先创建两个 Python 列表,创建完成后,可以使用 +运算符将它们进行连接:
list1 = [i for i in range(1,11)]
list2 = [i**2 for i in range(1,11)]
print(list1+list2)
# [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 1, 4, 9, 16, 25, 36, 49, 64, 81, 100]
在 Python 列表中,元素被视为独立对象,而非单纯的数值。因此,+ 运算符的行为并非按元素相加,而是将两个列表拼接在一起。如果期望的是数值向量按元素相加,Python 原生列表无法直接实现这一功能。
接下来查看使用 NumPy 数组版本的实现方式:
import numpy as np
arr1 = np.array(list1)
arr2 = np.array(list2)
arr1 + arr2
# array([ 2, 6, 12, 20, 30, 42, 56, 72, 90, 110])
利用 numpy 的np.array数组方法,可以高效实现两个列表中对应数值的逐个相加。
通过dir 函数可以进一步观察两者的区别。首先查看 Python 内置列表 list1的内置方法:
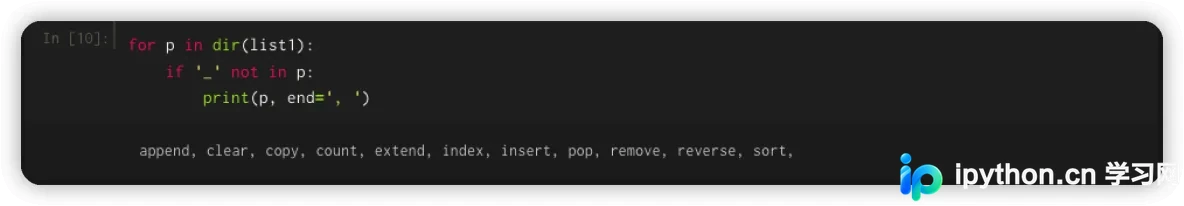
接着使用相同的方法查看 arr1中的方法:
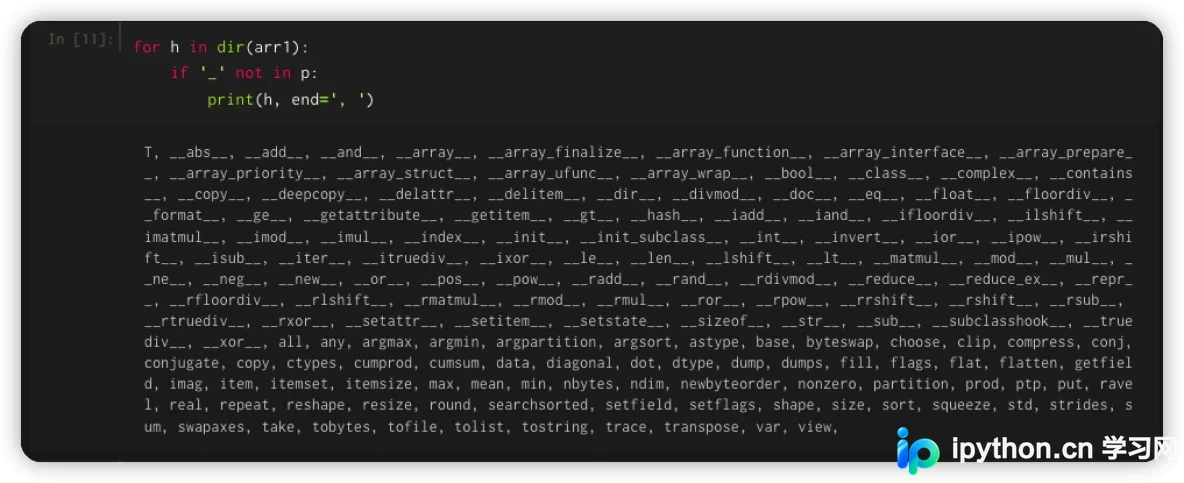
NumPy 数组对象提供了更多专为数值和统计计算设计的函数与属性。特别需要注意的是mean、std和sum等方法,它们明确体现了该库对数值运算的关注,且执行速度极快。
2 NumPy 数组和 Python 内置计算对比
NumPy 的计算速度显著快于 Python 列表,这主要归功于其矢量化实现以及核心例程使用 C 语言(基于 CPython 框架)编写的事实。NumPy 数组是同构类型且密集排列的数组,而 Python 列表是指向对象的指针数组,即使元素类型相同。这种结构差异使得 NumPy 能够利用内存局部性优势。
由于许多 NumPy 操作直接在 C 语言层面实现,避免了 Python 解释器中的循环、指针间接寻址以及逐元素的动态类型检查开销。特别是,速度提升的具体幅度取决于所执行的操作类型。对于数据科学和机器学习任务而言,这种避免在长多维数组中进行显式循环的能力具有极高价值。
为了直观展示这一差异,我们使用 @timing计时装饰器进行性能测试。该代码封装了两个函数 std_dev和std_dev_python,分别使用 NumPy 和本机 Python 代码来计算列表/数组的标准差。
3 函数计算时间装饰器
我们可以利用 Python 装饰器语法结合functools模块中的wrapping功能,编写一个时间装饰器timing:
def timing(func):
@wraps(func)
def wrap(*args, **kw):
begin_time = time()
result = func(*args, **kw)
end_time = time()
print(f"Function '{func.__name__}' took {end_time-begin_time} seconds to run")
return result
return wrap
4 标准差计算公式
利用上述时间装饰器,我们可以对比 Numpy 数组和 Python 内置列表在计算标准差时的表现。
具体计算公式如图所示:
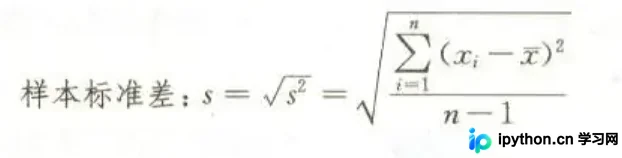
- 定义 Numpy 计算标准差的函数
std_dev(),numpy模块中内置了标准差公式的函数a.std(),我们可以直接调用该方法。 - 而列表计算公式方法需要按照数学公式逐步手动计算:
- 首先求出总和
s - 接着求出平均值
average - 计算每个数值与平均值的差的平方,并求和得到
sumsq - 再求出
sumsq的平均值sumsq_average - 最终得到标准差结果
result
具体代码如下:
from functools import wraps
from time import time
import numpy as np
from math import sqrt
def timing(func):
@wraps(func)
def wrap(*args, **kw):
begin_time = time()
result = func(*args, **kw)
end_time = time()
# print(f"Function '{func.__name__}' with arguments {args},keywords {kw} took {end_time-begin_time} seconds to run")
print(f"Function '{func.__name__}' took {end_time-begin_time} seconds to run")
return result
return wrap

@timing
def std_dev(a):
if isinstance(a, list):
a = np.array(a)
s = a.std()
return s

@timing
def std_dev_python(lst):

length = len(lst)
s = sum(lst)
average = s / length
sumsq = 0
for i in lst:
sumsq += (i-average)**2
sumsq_average = sumsq/length
result = sqrt(sumsq_average)
return result
运行结果显示,对于 1000000 个数据点,标准差值为 288675.13459。其中,Numpy 计算耗时仅为 0.0080 秒,而 Python 原生计算方式耗时为 0.2499 秒:
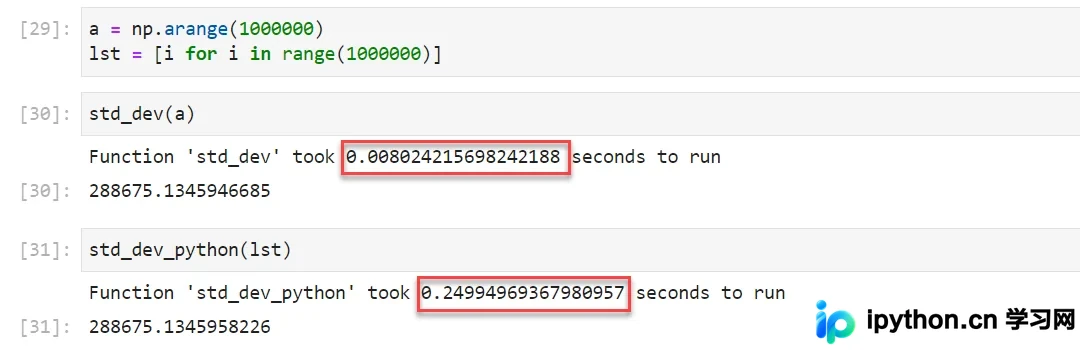
由此可见,Numpy 的计算方式在效率上具有明显优势。
5 总结
NumPy 专为数组操作和运算设计,其存储效率和输入输出性能远优于 Python 中的嵌套列表。随着数组规模的增大,NumPy 的性能优势愈发显著。
本文关于 NumPy 与 Python 内置列表计算标准差区别的分析到此结束。如需了解更多 Python 内置列表相关内容,请搜索本站过往文章或继续浏览后续文章,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









