


很多人在 Linux 上做 Rust 性能优化时,第一反应是重写热点代码,但真正影响结果的往往不只这一层。更高效的做法,是先从编译配置拿到“低成本收益”,再回到内存分配、并行模型和系统参数这些真正影响吞吐与延迟的环节,最后用基准测试和分析工具验证结论。读完这篇,你可以按“先测量、再定位、后优化”的顺序,判断哪些手段适合自己的程序。
先从编译优化拿到第一波性能收益
如果还在用默认调试构建来判断程序性能,结论大概率会失真。Rust 在 Linux 下的第一步优化,通常就是切到 release 模式,因为这会启用一整套 LLVM 优化,比手工微调代码更直接,也更稳定。
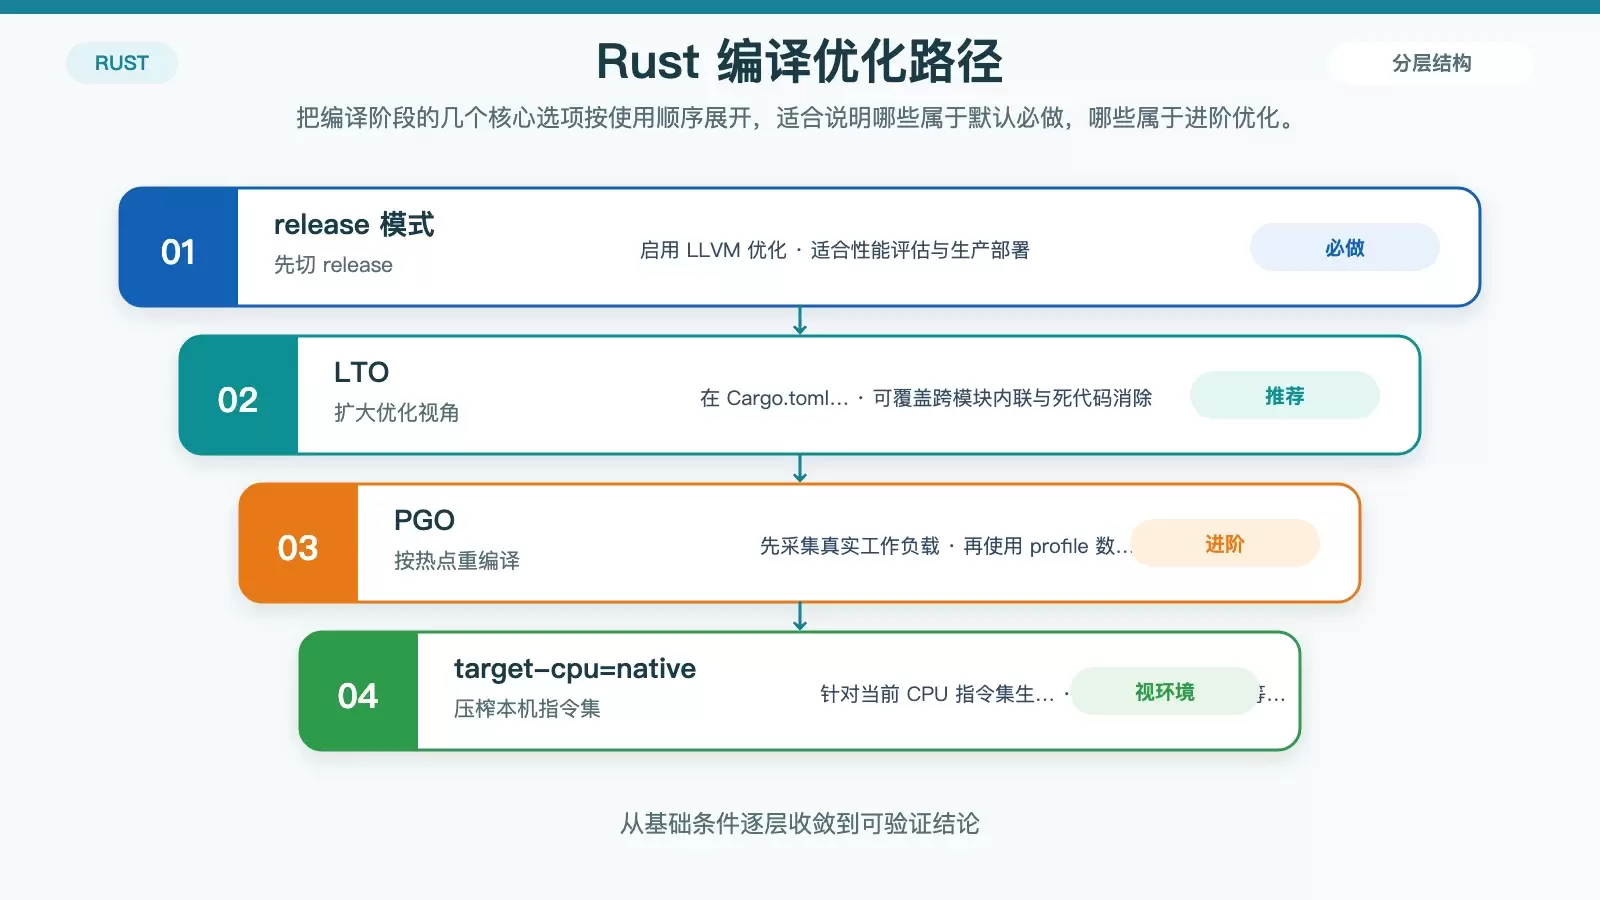
生产环境优先使用 release 模式
开发阶段习惯用 cargo build 没问题,但只要进入性能评估或生产部署,就应该改用 --release。这不只是一个开关,背后会直接改变编译器的优化策略,实际性能差距可能非常明显。
cargo build --releaseLTO 与 PGO 适合继续深挖极限性能
在 release 之外,下一步通常是启用 LTO(链接时优化)。它的价值在于把优化视角扩展到整个链接过程,让编译器看到跨模块的内联机会、死代码消除空间,以及更多全局级别的优化路径。
在 Cargo.toml 的 [profile.release] 中加入下面这一项即可:
lto = true如果程序已经进入高负载场景,或者你需要进一步压榨 CPU 性能,那么可以考虑 PGO(Profile-Guided Optimization)。它依赖真实工作负载来收集热点路径,再把这些数据反馈给第二次编译,让生成的机器码更贴近实际执行情况。
RUSTFLAGS="-C target-cpu=native -C profile-generate=/path/to/profile" cargo build --release
RUSTFLAGS="-C target-cpu=native -C profile-use=/path/to/profile" cargo build --release
这里的 target-cpu=native 也值得单独提一下。它会让编译器针对当前机器的 CPU 指令集生成代码,从而利用 AVX、BMI 等扩展能力。前提是你的部署环境与构建环境足够接近,否则可移植性会受到影响。
代码层优化,重点看分配、复制与并发模型
编译参数决定了性能下限,但程序能跑多快,最终还取决于代码本身是否在给运行时制造额外负担。Rust 里最常见的几类问题,通常集中在堆分配、无意义复制、错误的抽象选择,以及并行模型没有对上业务类型。
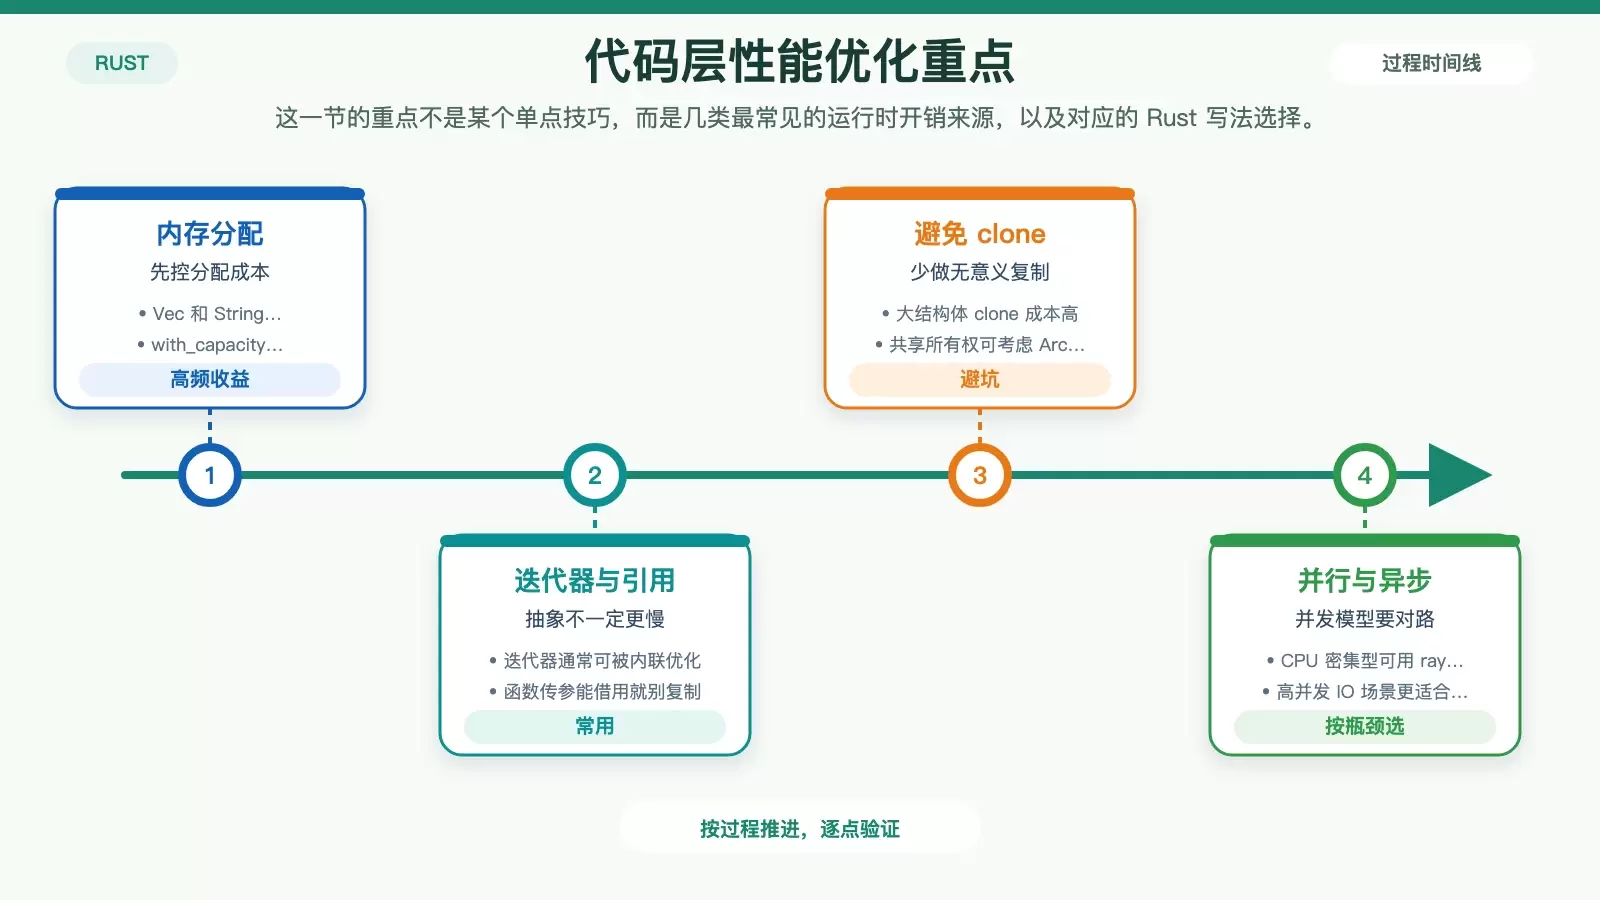
减少堆分配,优先控制 Vec 和 String 的增长成本
每次创建 Vec 或 String,都可能触发堆分配;如果容量不断扩张,还会产生重复的重新分配和数据搬运。对频繁增长的集合,提前用 with_capacity 预分配空间,往往能直接减少一批不必要的开销。
简单说,能在栈上解决的问题,就不要急着放到堆上;能提前估算容量的场景,也尽量别把扩容成本留给运行时兜底。
迭代器和引用,通常比手写复制更划算
Rust 的迭代器在大多数场景下属于零成本抽象,既能链式组合,也容易被编译器内联优化。相比直接写 for i in 0..n { ... },合适的迭代器方法往往能同时提升代码可读性与执行效率。
另一个常见性能坑是不必要的 clone。特别是大结构体或高频路径中的对象,如果函数参数本来可以借用引用,就不应该直接复制。必须共享所有权时,再考虑 Arc 或 Rc。
unsafe、并行计算与异步 IO 要按瓶颈类型使用
unsafe 确实可能换来更低开销,例如绕过边界检查、直接操作指针,但它的使用前提必须是:你已经确认这里就是性能瓶颈,而且能证明代码行为是安全的。否则,性能收益可能还比不上后续排查未定义行为的成本。
如果瓶颈在 CPU 计算,优先考虑并行化。rayon 对数据并行的封装比较友好,把普通迭代器替换为 par_iter,通常就能把任务分摊到多个线程。
如果瓶颈在高并发 IO,则更适合使用 tokio 配合 async/await,用非阻塞方式提升连接处理能力。这两类优化方向不要混用判断标准,关键是先分清程序主要卡在算力还是等待。
系统层限制,常常决定程序能不能跑满
代码和编译参数都处理好了,程序依然可能被 Linux 的默认限制卡住。尤其是网络服务、并发任务或多线程场景,文件描述符、线程栈和系统观测工具,往往比继续改业务代码更值得先检查。
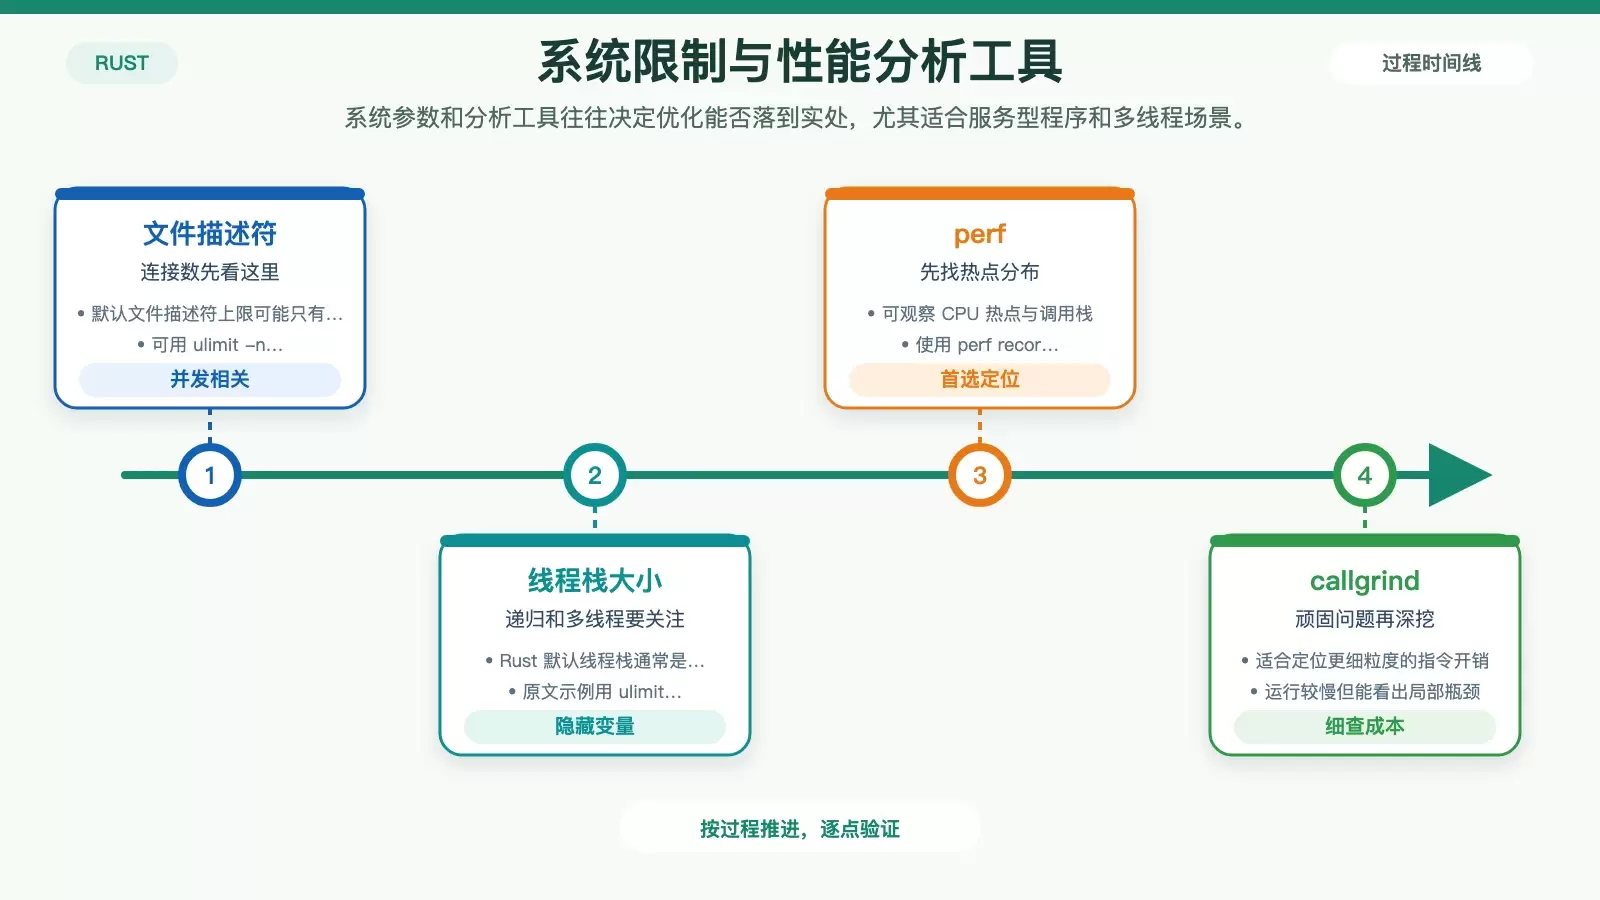
先检查文件描述符和线程栈大小
如果应用需要处理大量并发连接,默认的文件描述符上限可能只有 1024,这很容易成为吞吐瓶颈。可以先临时提升:
ulimit -n 65535如果需要长期生效,则应写入 /etc/security/limits.conf。
线程栈大小也是一个容易被忽视的变量。Rust 默认线程栈通常是 2MB,在深度递归或者大量线程并发时,可能会提前撞上限制。原文给出的调整方式如下:
ulimit -s 1048576这里的单位是 KB,也就是把栈上限设置为 1GB。是否需要这么高,要结合程序线程数量和内存预算来判断,不能机械照搬。
用 perf 和 callgrind 先定位热点,再谈优化动作
性能分析工具的作用,是告诉你时间到底花在了哪里。Linux 下常用的第一选择是 perf,它可以观察 CPU 热点、分支预测失败和缓存未命中等信息,适合先画出调用热点图。
perf record -g target/release/your_program
perf report
valgrind --tool=callgrind target/release/your_program
perf record -g 会先记录程序运行时的调用栈,接着用 perf report 查看热点分布。若你怀疑问题与更细粒度的执行成本有关,可以再用 valgrind 的 callgrind 做进一步定位。它运行会比较慢,但能告诉你更细的指令开销信息,适合分析顽固的局部瓶颈。
别忽略基准测试、系统调用和缓存策略
除了常见的编译、代码和系统参数,很多实际项目的性能上限,还取决于更基础的设计判断:数据结构是不是合适,系统调用有没有过多,缓存是否真正减少了重复劳动。这些问题如果判断错误,单点优化往往补不回来。
算法和数据结构选择,往往比微优化更关键
性能优化里最容易被低估的,其实是算法复杂度和数据结构选型。比如 HashMap 在查找上通常快于 Vec,但在小数据量场景下,线性扫描未必更慢,甚至可能因为常数项更低而更划算。
因此,在做复杂改造之前,建议先跑基准测试。原文提到的 criterion 和 cargo bench,就是用来验证这些选择是否真的带来收益的直接手段。
减少系统调用次数,缓存要配合一致性设计
write、read 这类系统调用会进入内核态,调用频率一高,吞吐就容易掉下来。常见优化方式包括使用 BufWriter 合并多次写入,或者使用内存映射文件,减少逐次调用带来的额外损耗。
缓存同样属于高性价比手段。无论是计算结果缓存还是 IO 缓存,本质上都是用空间换时间,避免重复计算和重复访问。不过缓存不是加上就完事,真正难的是失效策略和一致性维护。原文建议结合 lru 这类成熟库处理,这个方向是合理的。
优化的原则是先找到瓶颈,再决定是否值得复杂化
最后一点比任何技巧都重要:没有银弹。过度优化可能会让代码变得难读、难测、难维护,而收益却未必成比例。比较稳妥的工程路径是先测量,再定位,再做有明确收益预期的改动;只有这样,性能提升才不会变成维护成本的放大器。









