


在 Linux 环境里写 Rust,性能问题通常不是“语言不够快”,而是构建方式、测量方法和优化顺序出了偏差。与其一上来就改算法细节,不如先把基准、分析工具和低层优化手段串成一套流程;看完这篇,你可以判断哪些技巧适合先用,哪些只该在证据充分时再出手。
先把构建与测量基础打牢
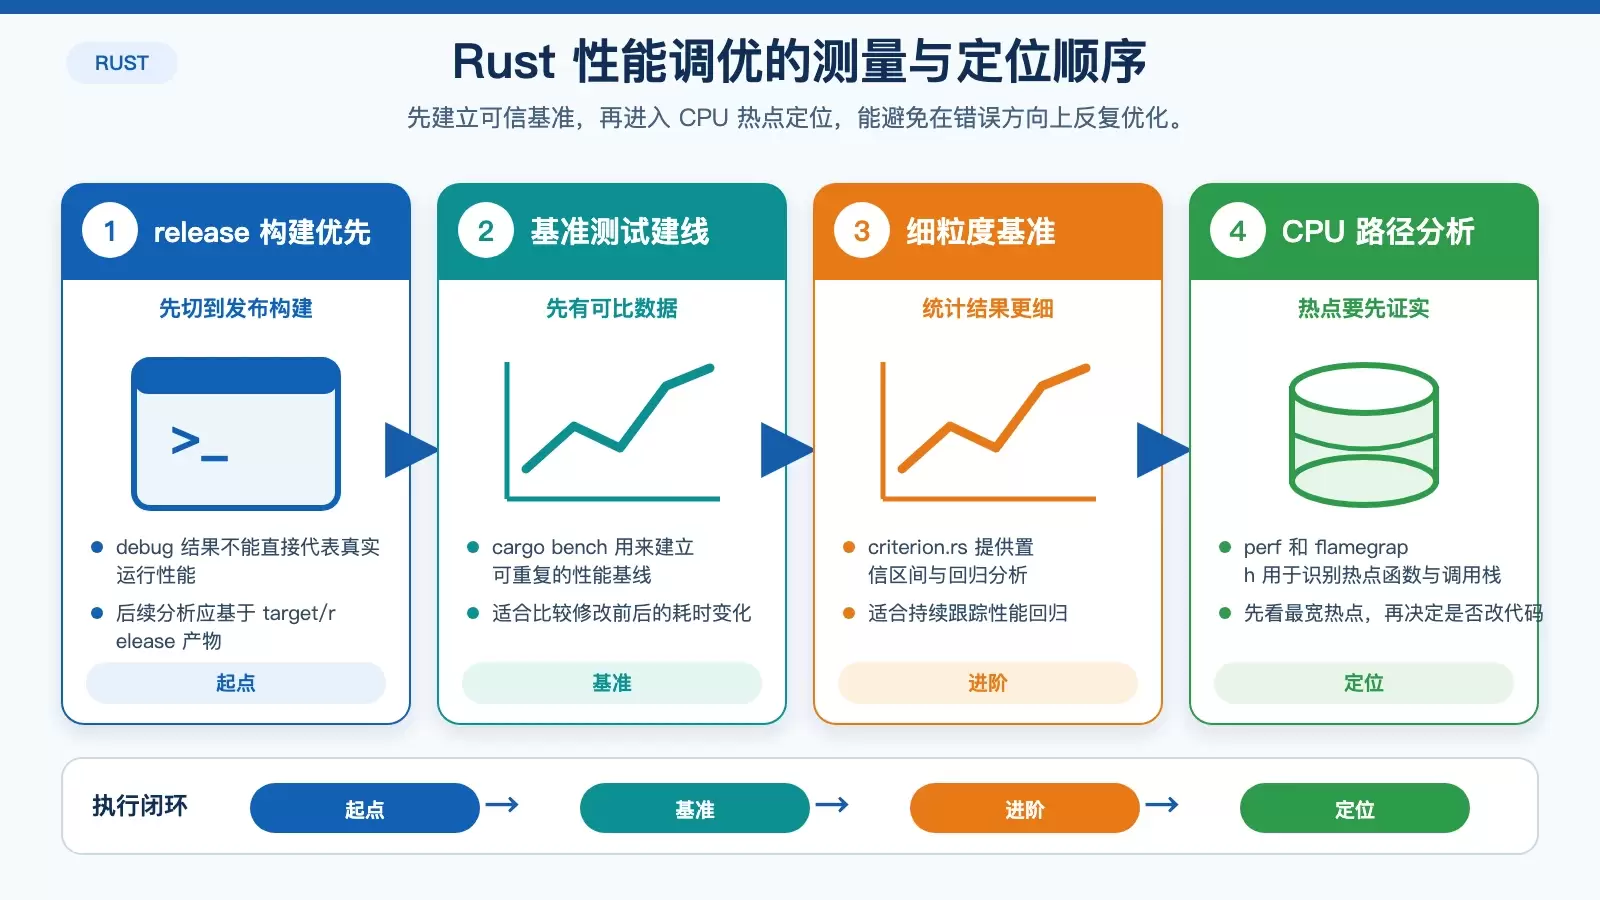
先确认是否用了 release 构建
性能优化最容易漏掉的一步,就是还在用 debug 结果判断程序快慢。debug 模式包含大量调试信息,而且默认几乎不做优化,和真实运行性能往往差出一个量级。
cargo build --release如果你的压测、基准或线上前验证都不是基于 target/release 产物完成,后面的分析结论很可能从一开始就偏了。
用 cargo bench 建立基准线
“这段代码应该更慢”这种直觉,通常不够可靠。先用 cargo bench 建一条可重复的基准线,至少能知道是哪个函数、哪一类调用开始拖后腿。
cargo bench它的价值不只是测一次结果,更在于给后续每轮修改提供可对比的数据基础。
需要更细粒度结果时,引入 criterion.rs
如果内置 bench 还不够细,criterion.rs 会更适合持续调优场景。它能给出置信区间、回归分析等统计信息,让你区分“真的变快了”和“只是这次测得更好看”。
[dev-dependencies]
criterion = "0.3"
接着在项目中建立 benches 目录,编写对应的基准测试代码。对于需要长期追踪性能回归的项目,这一步通常比零散跑几次命令更有价值。
定位热点:先找 CPU 与调用路径
用 perf 看清 CPU 时间花在哪里
perf 是 Linux 上最直接的性能分析工具之一,适合先回答“程序到底慢在什么地方”。它不仅能观察热点函数,也能帮助判断缓存命中、分支预测等底层行为是否异常。
sudo perf record -g target/release/your_program
sudo perf report
其中 -g 会记录调用栈,便于把单个热点函数放回完整调用链里理解,而不是只看到一组零散的耗时数字。
用 cargo flamegraph 直接可视化热点
如果你更习惯从图形上理解瓶颈,火焰图通常比纯文本报告更直观。cargo flamegraph 能把调用栈按 CPU 占用展开,哪段代码最“宽”,哪段就最值得先查。
cargo install flamegraph
cargo flamegraph --bin your_program
它特别适合处理“明明程序整体很慢,但不知道该先动哪一块”的情况。先看最宽的栈,再决定是否值得改代码结构、数据布局或算法。
别忽略 valgrind 的 callgrind 视角
Rust 能避免很多内存安全问题,但这不等于程序天然没有性能浪费。对于调用开销、内存访问模式、潜在泄漏或未定义行为相关问题,valgrind 里的 callgrind 仍然很有用。
valgrind --tool=callgrind target/release/your_program它适合补足另一类证据:不是“CPU 总体忙不忙”,而是“调用关系和资源消耗是否合理”。这类信息在分析复杂函数链时尤其有帮助。
当热点明确后,再看编译器与并行化空间
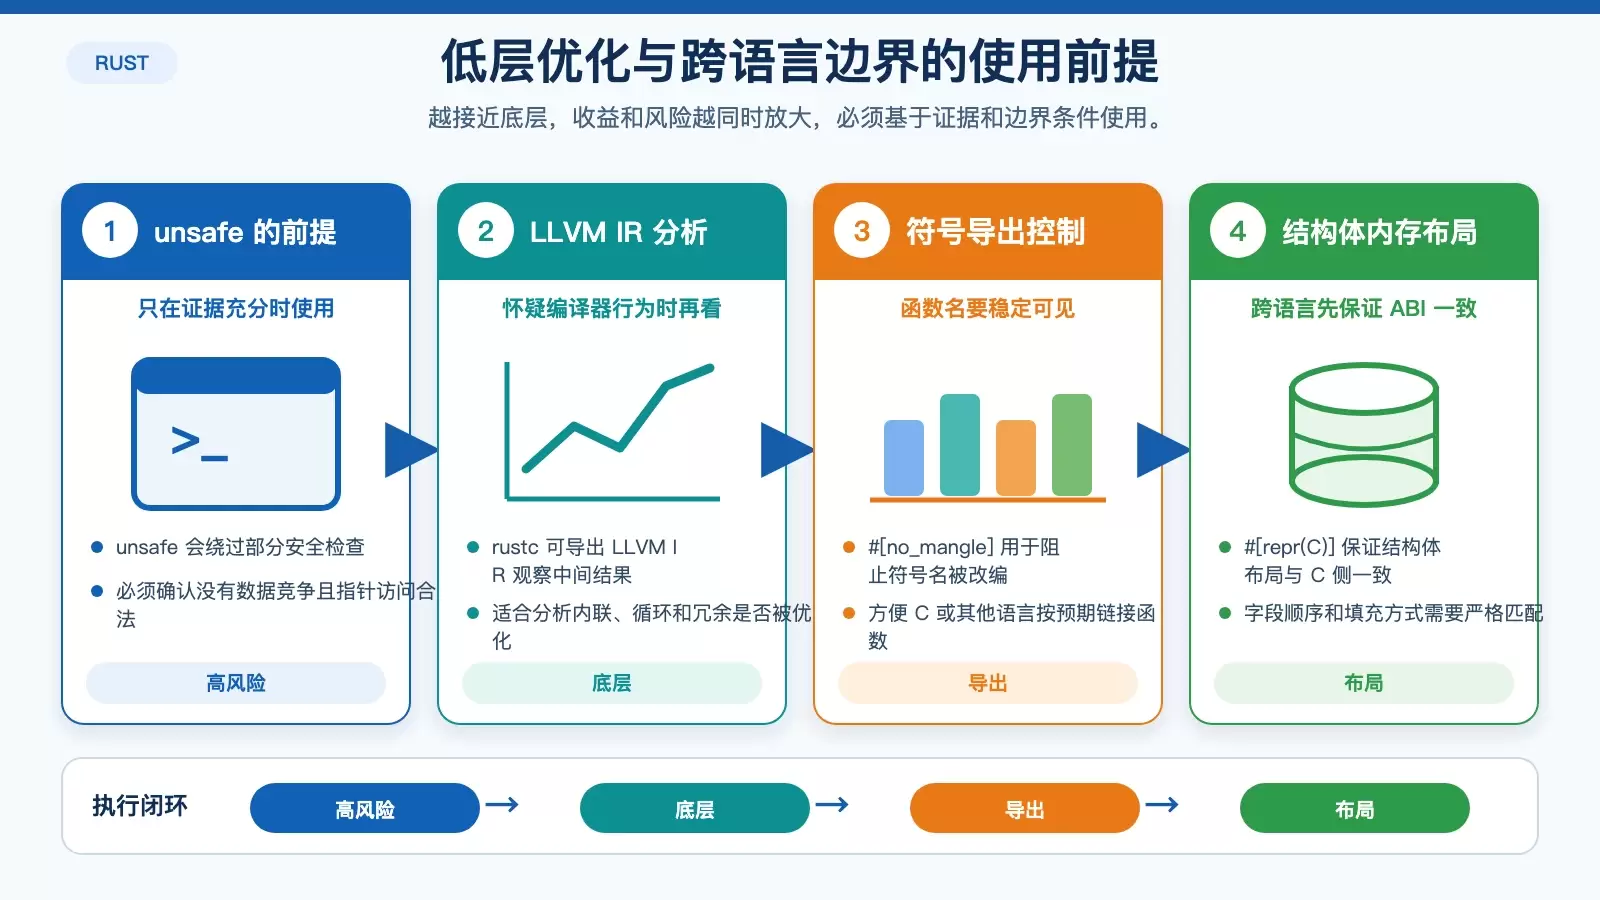
需要深挖时,检查 LLVM IR
当你怀疑“编译器本可以优化得更好”,或者某段代码在语义上看似简单、结果却没有跑出预期时,可以直接生成 LLVM IR 观察编译器中间结果。
rustc --emit=llvm-ir -C opt-level=3 your_program.rs这一步更偏底层分析,不适合作为起手动作,但在排查内联、消除冗余、循环优化是否生效时,常能提供非常直接的证据。
数据独立时,用 rayon 吃满多核
如果瓶颈集中在大量相互独立的循环或集合处理上,单线程优化可能很快见顶。这时可以评估是否适合接入 rayon 做数据并行。
[dependencies]
rayon = "1.5"
接入后,可将类似 .iter() 的串行迭代替换为 .par_iter(),例如 vec.par_iter().map(...)。不过前提很重要:任务之间要尽量独立,拆分和调度成本也要值得这次并行化。
减少运行时开销:从内存分配到编译期求值
优先减少不必要的内存分配
频繁分配和释放内存,往往是很多 Rust 程序“看起来没问题、跑起来却发闷”的根源之一。相比微调语法,先减少动态扩容、重复创建临时对象,通常更容易获得稳定收益。
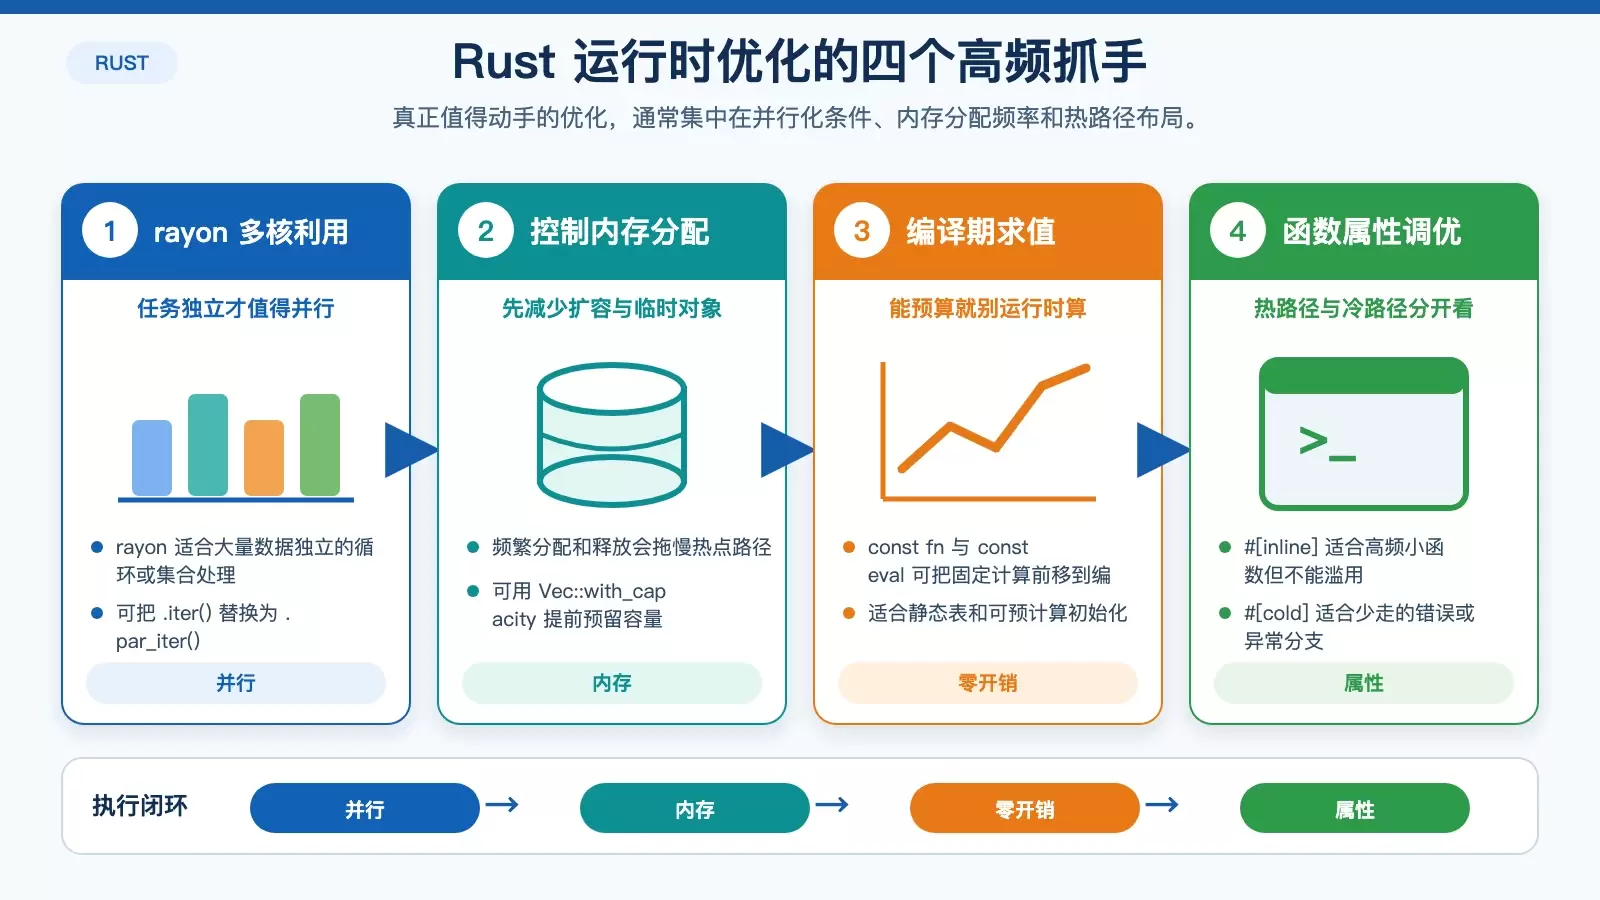
例如可以用 Vec::with_capacity 提前预留容量,尽量复用已有缓冲区,避免在热点路径里反复申请和释放内存。
能在编译期算完的,就别留到运行时
如果某些值在编译阶段就能确定,可以用 const fn 和 const eval 提前完成计算。这样做的意义不只是“少执行几行代码”,而是把一部分运行时成本直接归零。
这类优化特别适合固定表、配置常量、可预计算的初始化逻辑,但前提仍然是它们确实属于稳定、可静态求值的部分。
谨慎使用属性与不安全代码
合理使用 #[inline] 与 #[cold]
#[inline] 适合频繁调用的小函数,目标是减少函数调用开销;但它不是“贴上就更快”的万能开关,过度内联反而可能导致代码膨胀,影响指令缓存表现。
相对地,#[cold] 适合那些几乎不会进入的冷路径,例如错误处理或异常分支。把这类路径标记出来后,编译器更容易把热路径压得更紧凑,帮助分支预测。
unsafe 只该在证据充分时使用
unsafe 确实可能换来额外性能,但它绕过的是 Rust 最核心的一部分安全保障。只有在你已经通过基准和分析工具确认瓶颈、并且能严格证明没有数据竞争、指针访问合法时,才值得考虑。
即便使用,也应该在代码里明确写下注释,说明为什么这里是安全的、依赖了哪些前置条件。否则短期提速,长期维护成本通常会更高。
涉及 FFI 时,性能与兼容性要一起考虑
#[no_mangle] 与 #[repr(C)] 不是装饰项
当 Rust 代码需要导出给 C 或其他语言使用时,性能问题往往会和 ABI 兼容性绑在一起。#[no_mangle] 用来阻止符号名被改编,方便外部语言按预期链接到目标函数。
而 #[repr(C)] 则关系到结构体内存布局是否与 C 侧一致。如果字段顺序、填充方式不一致,轻则调用异常,重则直接引入难排查的问题。
因此,这两项更多是在保证跨语言边界“可正确优化、可正确调用”,而不是单纯追求某个局部指标更漂亮。
更实用的调优顺序
把这些技巧拆开看,每一项都能解决一类问题;但真正有效的方式,通常是按顺序组合使用。一个更稳妥的流程是:先用 cargo build --release 确认构建方式,再用 cargo bench 或 criterion.rs 建基准,随后通过 perf、cargo flamegraph、valgrind 定位热点,最后才进入并行化、内存优化、属性调整,甚至 unsafe 级别的处理。
性能调优不是一次性动作,而是一轮一轮地测量、定位、修改、验证。只要每一步都有数据支撑,最终得到的 Rust 程序通常不只是“跑得更快”,也更容易长期维护。









